Trong Data Science, trước khi xây dựng mô hình dự đoán hay triển khai thuật toán Machine Learning, bạn cần hiểu rõ dữ liệu mình đang có. Dữ liệu gồm những biến nào? Có giá trị bị thiếu không? Những biến nào có mối liên hệ với nhau? Có xuất hiện điểm bất thường ảnh hưởng đến kết quả phân tích không?
Để trả lời những câu hỏi này, các nhà phân tích dữ liệu sử dụng EDA (Exploratory Data Analysis), hay còn gọi là phân tích dữ liệu khám phá. Đây là quá trình giúp tìm hiểu cấu trúc, nhận diện xu hướng và phát hiện những vấn đề tiềm ẩn trong tập dữ liệu trước khi thực hiện các phân tích chuyên sâu.
Vậy EDA là gì, có vai trò như thế nào và được thực hiện ra sao bằng Python? Hãy cùng tìm hiểu quy trình, kỹ thuật và ví dụ thực hành trong bài viết dưới đây.
EDA là gì?
EDA (Exploratory Data Analysis) là quá trình phân tích và khám phá dữ liệu nhằm tìm hiểu các đặc điểm, cấu trúc, phân phối và mối quan hệ giữa các biến trong tập dữ liệu. EDA là viết tắt của Exploratory Data Analysis, trong đó Exploratory có nghĩa là khám phá, Data là dữ liệu và Analysis là phân tích.
Thuật ngữ này gắn liền với nhà thống kê John W. Tukey, người hệ thống hóa phương pháp phân tích dữ liệu khám phá trong cuốn sách Exploratory Data Analysis (1977), do Addison-Wesley xuất bản.
Quá trình EDA thường kết hợp thống kê mô tả và trực quan hóa để nhận diện xu hướng, phát hiện dữ liệu bất thường và hình thành giả thuyết. Thay vì bắt đầu ngay bằng việc xây dựng mô hình dự đoán, EDA giúp Data Scientist quan sát dữ liệu từ nhiều góc độ, hiểu rõ bản chất dữ liệu và xác định những vấn đề cần xử lý trước khi phân tích chuyên sâu.
Ví dụ, một doanh nghiệp thương mại điện tử muốn dự đoán doanh thu trong những tháng tiếp theo. Trước khi xây dựng mô hình, người phân tích cần khám phá dữ liệu bán hàng để xác định sản phẩm có doanh thu cao, xu hướng doanh thu theo thời gian, nhóm khách hàng có giá trị đơn hàng lớn và những giao dịch bất thường. Đây chính là những câu hỏi EDA giúp giải quyết.
EDA không phải một thuật toán hay công cụ phần mềm cụ thể, mà là phương pháp tiếp cận dữ liệu thông qua các kỹ thuật thống kê và trực quan hóa. Mục tiêu là khám phá thông tin, hiểu đặc điểm dữ liệu và phát hiện vấn đề trước khi đưa ra kết luận hoặc xây dựng mô hình Machine Learning.
Tại sao EDA quan trọng trong Data Science và Machine Learning?
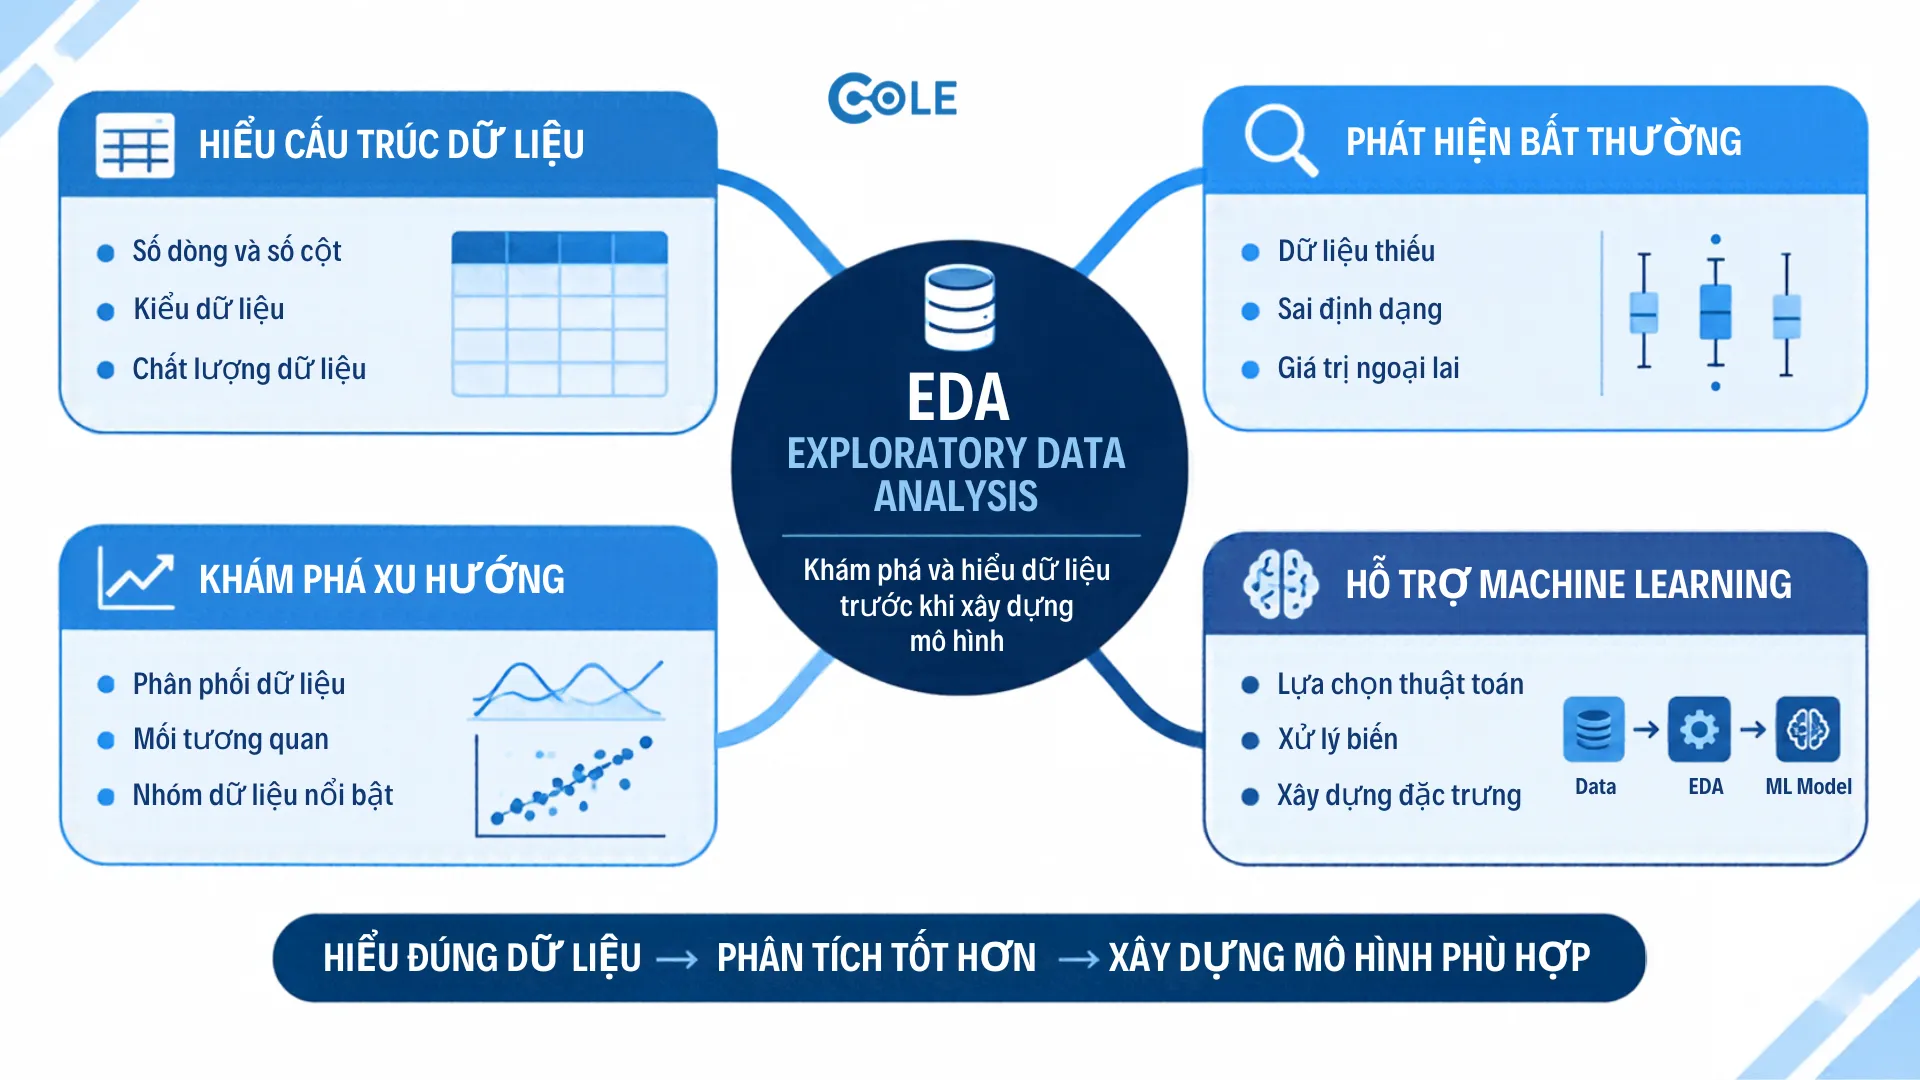
EDA giúp Data Scientist hiểu dữ liệu trước khi đưa ra quyết định phân tích. Nếu bỏ qua bước này, những lỗi dữ liệu hoặc giả định không chính xác có thể ảnh hưởng đến toàn bộ quá trình xây dựng mô hình.
Hiểu cấu trúc và chất lượng dữ liệu
Một tập dữ liệu có thể chứa hàng nghìn hoặc hàng triệu bản ghi với nhiều kiểu biến khác nhau. EDA giúp xác định số lượng dòng, số lượng cột, kiểu dữ liệu và mức độ đầy đủ của thông tin.
Qua đó, người phân tích biết mình đang làm việc với dữ liệu nào và liệu dữ liệu có đáp ứng yêu cầu của bài toán hay không.
Phát hiện dữ liệu thiếu và giá trị ngoại lai
Dữ liệu thực tế thường không hoàn hảo. Một số bản ghi có thể thiếu thông tin, sai định dạng hoặc chứa giá trị khác biệt đáng kể so với phần còn lại.
EDA giúp phát hiện những vấn đề này thông qua thống kê và biểu đồ. Từ kết quả khám phá, người phân tích có thể quyết định loại bỏ, thay thế hoặc giữ lại các giá trị bất thường tùy theo bối cảnh.
Tìm kiếm xu hướng và mối quan hệ giữa các biến
Thông qua biểu đồ phân phối, biểu đồ phân tán và thống kê nhóm, EDA hỗ trợ nhận diện xu hướng và mối liên hệ giữa các biến.
Ví dụ, doanh nghiệp có thể khám phá liệu số tiền quảng cáo có liên quan đến doanh thu hay không, hoặc nhóm khách hàng nào thường có giá trị đơn hàng cao hơn.
Hỗ trợ lựa chọn mô hình Machine Learning
Hiểu đặc điểm dữ liệu giúp Data Scientist đưa ra quyết định phù hợp khi lựa chọn thuật toán, xử lý biến và xây dựng đặc trưng.
Chẳng hạn, dữ liệu có phân phối lệch hoặc nhiều giá trị ngoại lai có thể cần được xem xét trước khi sử dụng một số thuật toán nhạy cảm với những đặc điểm này.
EDA không đảm bảo mô hình Machine Learning sẽ chính xác, nhưng giúp giảm nguy cơ đưa dữ liệu chưa được hiểu rõ vào quá trình huấn luyện.
Các kỹ thuật EDA phổ biến trong phân tích dữ liệu
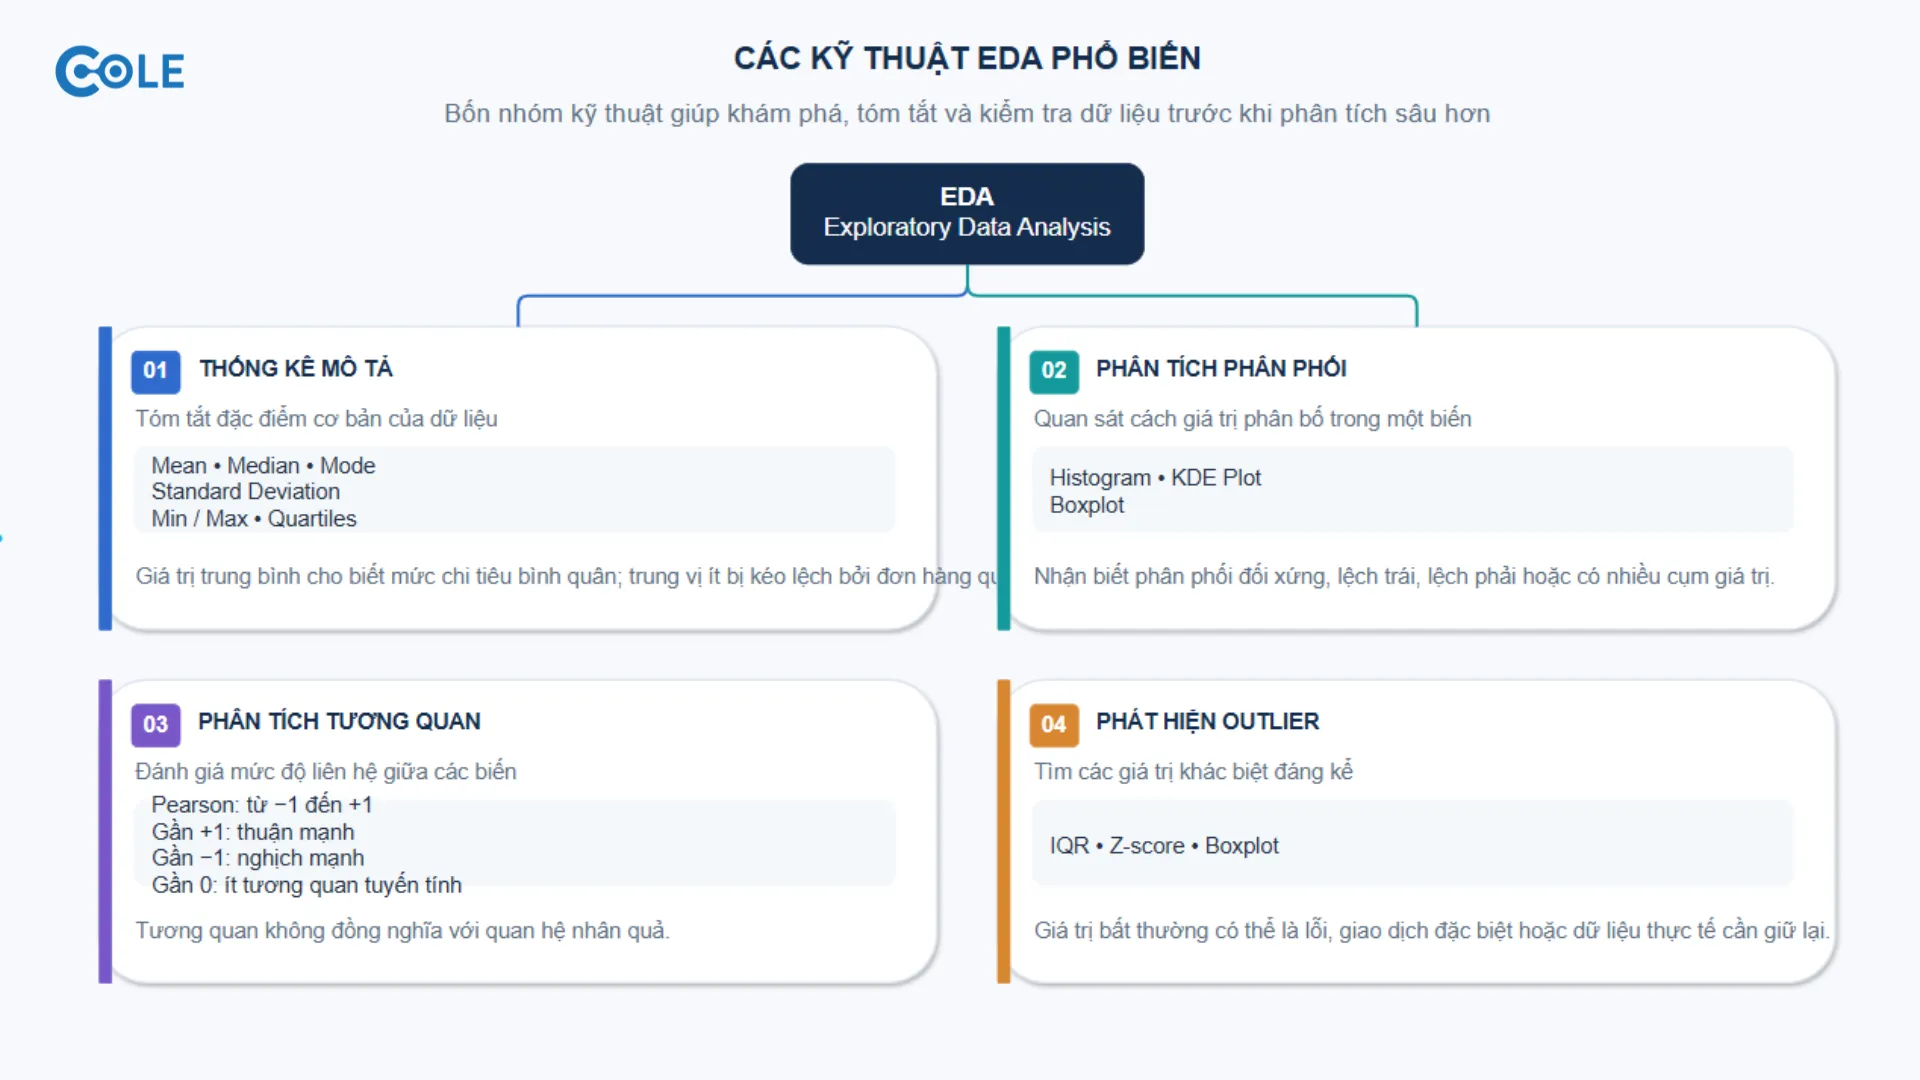
EDA sử dụng nhiều kỹ thuật khác nhau tùy thuộc vào loại dữ liệu và mục tiêu phân tích. Có thể chia các kỹ thuật phổ biến thành bốn nhóm chính.
Thống kê mô tả (Descriptive Statistics)
Thống kê mô tả giúp tóm tắt các đặc điểm cơ bản của dữ liệu thông qua Mean (trung bình), Median (trung vị), Mode (giá trị xuất hiện nhiều nhất), Standard Deviation (độ lệch chuẩn), Minimum, Maximum và các Quartiles (phân vị).
Ví dụ, khi phân tích giá trị đơn hàng, giá trị trung bình cho biết mức chi tiêu bình quân, trong khi trung vị giúp quan sát mức chi tiêu ở vị trí giữa và hạn chế ảnh hưởng từ một số đơn hàng có giá trị quá lớn.
Phân tích phân phối dữ liệu (Distribution Analysis)
Kỹ thuật này giúp tìm hiểu cách các giá trị phân bố trong một biến.
Histogram cho biết tần suất xuất hiện của các khoảng giá trị, KDE Plot ước lượng mật độ phân phối, còn Boxplot giúp quan sát trung vị, các phân vị và những điểm có khả năng là ngoại lai.
Thông qua phân tích phân phối, người làm dữ liệu có thể nhận biết dữ liệu đối xứng, lệch trái, lệch phải hoặc có nhiều nhóm giá trị khác nhau.
Phân tích tương quan (Correlation Analysis)
Phân tích tương quan giúp đánh giá mức độ liên hệ giữa các biến số.
Với hệ số tương quan Pearson, giá trị thường nằm trong khoảng từ -1 đến 1. Giá trị gần 1 thể hiện tương quan tuyến tính thuận mạnh, gần -1 thể hiện tương quan tuyến tính nghịch mạnh và gần 0 thể hiện ít hoặc không có tương quan tuyến tính.
Lưu ý, tương quan không đồng nghĩa với quan hệ nhân quả. Hai biến có tương quan không có nghĩa một biến trực tiếp gây ra sự thay đổi của biến còn lại.
Phát hiện giá trị ngoại lai (Outlier Detection)
Outlier là những giá trị khác biệt đáng kể so với phần lớn dữ liệu còn lại.
Một số phương pháp phổ biến gồm IQR (Interquartile Range), Z-score và Boxplot. Các phương pháp này giúp xác định những điểm dữ liệu cần kiểm tra thêm.
Ví dụ, trong tập dữ liệu về mức chi tiêu của khách hàng, phần lớn đơn hàng có giá trị từ vài trăm nghìn đến vài triệu đồng nhưng xuất hiện một đơn hàng trị giá hàng trăm triệu đồng.
Giá trị này có thể là lỗi nhập liệu, giao dịch đặc biệt hoặc một trường hợp thực tế cần được giữ lại. Vì vậy, không nên mặc định xóa mọi Outlier.
Các bước EDA trong Data Science
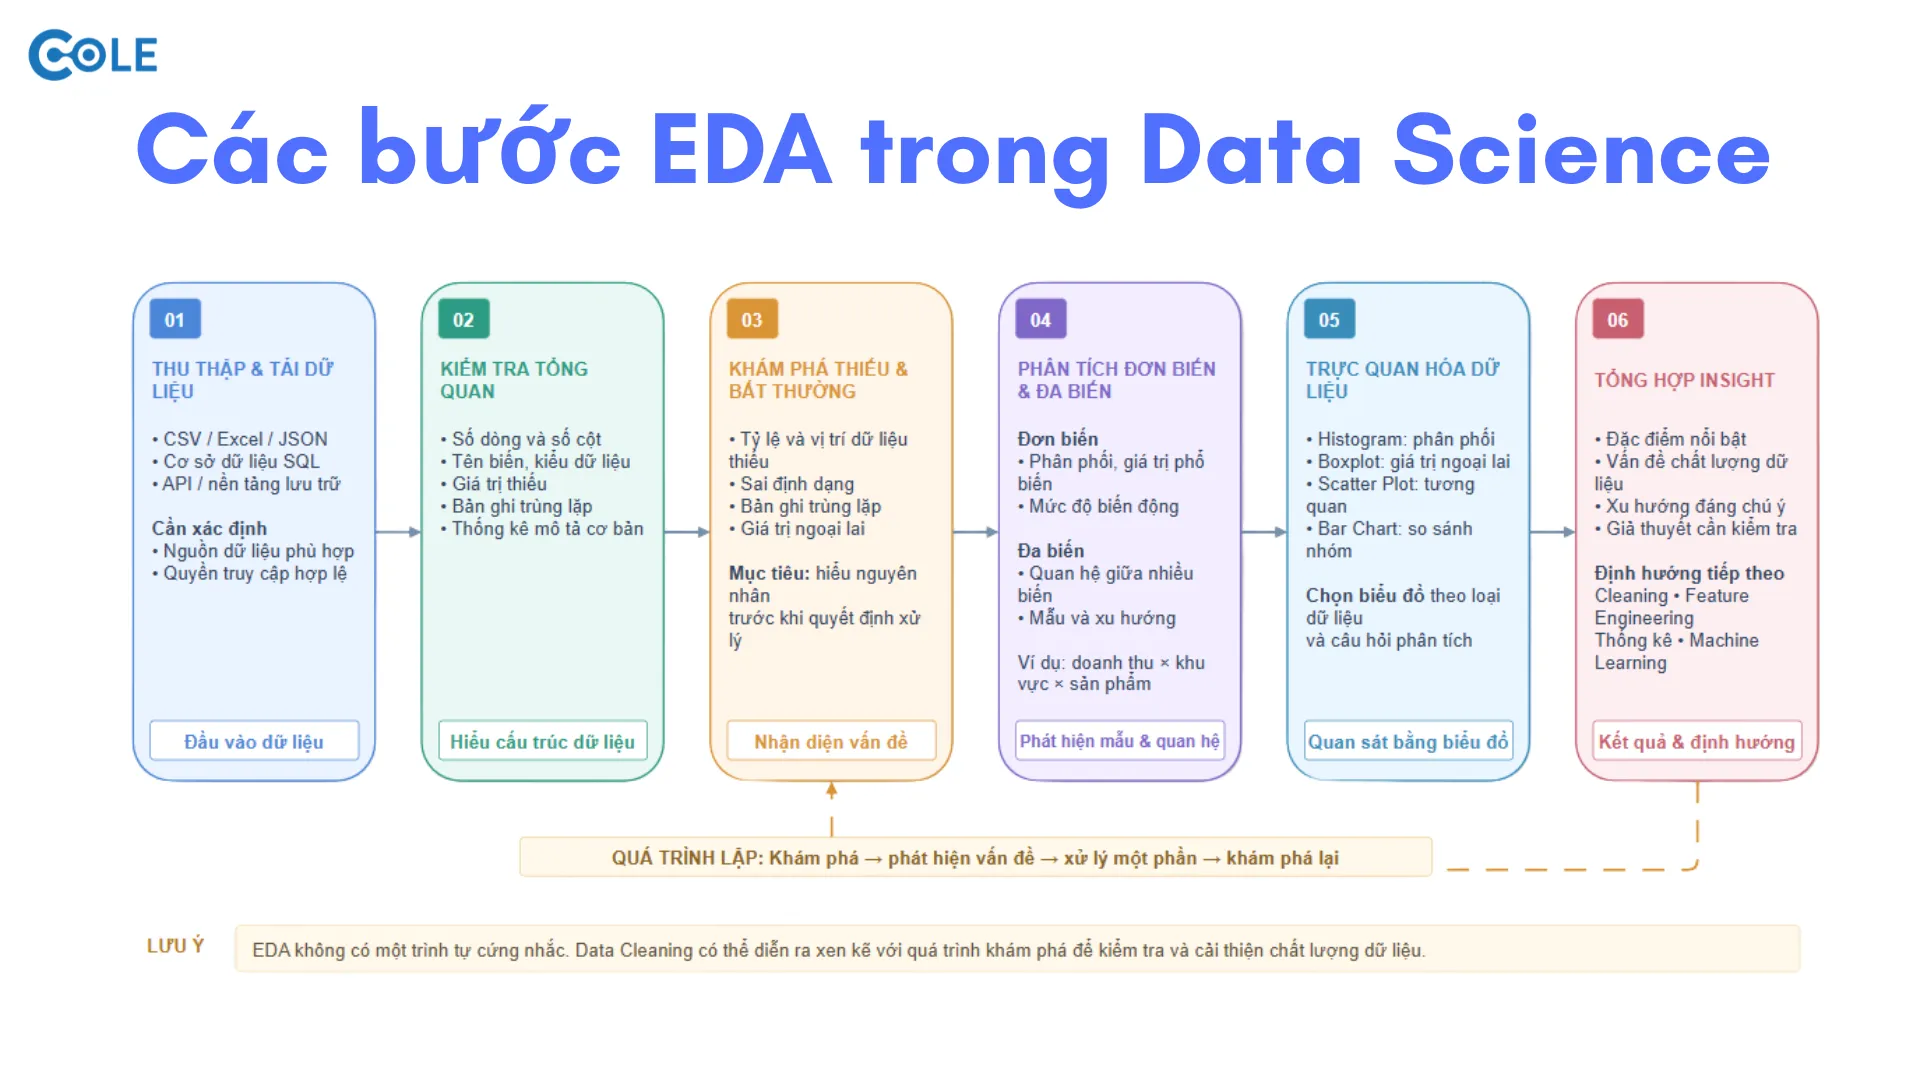
Không có một quy trình EDA cố định áp dụng cho mọi bài toán. Tuy nhiên, một quy trình phổ biến có thể được triển khai qua sáu bước sau:
Bước 1: Thu thập và tải dữ liệu
Đầu tiên, cần xác định nguồn dữ liệu và thu thập dữ liệu phục vụ mục tiêu phân tích. Dữ liệu có thể đến từ tệp CSV, Excel, JSON, cơ sở dữ liệu SQL, API hoặc các nền tảng lưu trữ dữ liệu.
Ở bước này, cần xác định dữ liệu có phù hợp với mục tiêu phân tích và đảm bảo quyền truy cập hợp lệ.
Bước 2: Kiểm tra tổng quan dữ liệu
Sau khi tải dữ liệu, người phân tích cần kiểm tra cấu trúc và đặc điểm cơ bản, bao gồm số lượng dòng và cột, tên biến, kiểu dữ liệu, giá trị thiếu, bản ghi trùng lặp và các chỉ số thống kê.
Bước này giúp xác định những vấn đề cần tìm hiểu trước khi đi sâu vào phân tích.
Bước 3: Khám phá dữ liệu thiếu và bất thường
Dữ liệu thiếu, sai định dạng hoặc trùng lặp có thể ảnh hưởng đến kết quả phân tích. Người thực hiện cần xác định tỷ lệ thiếu, vị trí xuất hiện và nguyên nhân có thể dẫn đến tình trạng này.
Ở giai đoạn này, chưa nhất thiết phải xóa hoặc thay thế toàn bộ giá trị bất thường. Quan trọng là hiểu được bản chất của vấn đề trước khi lựa chọn phương pháp xử lý.
Bước 4: Phân tích đơn biến và đa biến
Phân tích đơn biến (Univariate Analysis) tập trung vào từng biến riêng lẻ để tìm hiểu phân phối, giá trị phổ biến và mức độ biến động.
Trong khi đó, phân tích đa biến (Multivariate Analysis) xem xét mối quan hệ giữa nhiều biến nhằm khám phá các mẫu và xu hướng phức tạp hơn.
Ví dụ, thay vì chỉ xem xét doanh thu, người phân tích có thể kết hợp doanh thu, khu vực bán hàng và nhóm sản phẩm để tìm ra khu vực có hiệu quả kinh doanh tốt nhất.
Bước 5: Trực quan hóa dữ liệu
Biểu đồ giúp chuyển đổi những bảng số liệu phức tạp thành hình ảnh dễ quan sát và diễn giải.
Một số dạng biểu đồ thường sử dụng gồm Histogram để phân tích phân phối, Boxplot để phát hiện giá trị ngoại lai, Scatter Plot để quan sát mối quan hệ giữa hai biến và Bar Chart để so sánh các nhóm dữ liệu.
Lựa chọn biểu đồ cần dựa trên loại dữ liệu và câu hỏi phân tích, tránh sử dụng biểu đồ chỉ vì mục đích trình bày.
Bước 6: Tổng hợp insight và xác định hướng phân tích tiếp theo
Đây là bước chuyển những kết quả quan sát được thành thông tin có ý nghĩa.
Người phân tích cần tổng hợp các đặc điểm nổi bật của dữ liệu, vấn đề về chất lượng, xu hướng đáng chú ý và những giả thuyết cần kiểm tra thêm.
Kết quả EDA sẽ trở thành cơ sở để thực hiện Data Cleaning, Feature Engineering, lựa chọn phương pháp thống kê hoặc xây dựng mô hình Machine Learning.
Lưu ý: EDA và Data Cleaning không nhất thiết diễn ra theo một chiều cố định. Trong thực tế, người phân tích thường khám phá dữ liệu, phát hiện vấn đề, xử lý một phần rồi tiếp tục khám phá để kiểm tra kết quả. Đây là quá trình lặp lại cho đến khi dữ liệu đáp ứng yêu cầu của bài toán.
Hướng dẫn thực hiện EDA bằng Python qua ví dụ thực tế
Python là một trong những ngôn ngữ được sử dụng phổ biến trong Data Science nhờ hệ sinh thái thư viện hỗ trợ xử lý, phân tích và trực quan hóa dữ liệu.
Để dễ thực hành, chúng ta sẽ sử dụng một bộ dữ liệu bán hàng mẫu được tạo trực tiếp bằng Python. Bộ dữ liệu có thông tin về mã đơn hàng, sản phẩm, số lượng, đơn giá và doanh thu. Một số giá trị thiếu và bản ghi trùng lặp được chủ động đưa vào để minh họa quá trình khám phá dữ liệu.
Lưu ý về dữ liệu mẫu: Bộ dữ liệu chỉ có 12 đơn hàng ban đầu, được tạo để minh họa cú pháp và thao tác EDA. Các chỉ số như tương quan, Skewness và ngưỡng Outlier trên mẫu nhỏ này không có giá trị suy diễn cho hoạt động kinh doanh thực tế.
Các thư viện Python thường dùng trong EDA
| Thư viện | Công dụng |
|---|---|
| Pandas | Đọc, xử lý và khám phá dữ liệu dạng bảng |
| NumPy | Tính toán số học và thao tác với mảng |
| Matplotlib | Xây dựng biểu đồ trực quan |
| Seaborn | Trực quan hóa dữ liệu thống kê |
| Plotly | Tạo biểu đồ tương tác |
Ví dụ thực tế: Phân tích dữ liệu bán hàng để đánh giá hiệu quả kinh doanh
Giả sử bạn là một Data Analyst tại một doanh nghiệp bán lẻ thiết bị công nghệ. Bộ phận kinh doanh cung cấp dữ liệu đơn hàng gồm mã đơn hàng, tên sản phẩm, số lượng bán và đơn giá. Tuy nhiên, dữ liệu chưa được kiểm tra chất lượng và chưa có báo cáo tổng quan về tình hình kinh doanh.
Nhiệm vụ của bạn là sử dụng Python để thực hiện Exploratory Data Analysis (EDA), nhằm trả lời các câu hỏi:
Dữ liệu bán hàng có đầy đủ và đáng tin cậy không?
Sản phẩm nào có số lượng đơn hàng và doanh thu cao nhất?
Doanh thu có phân phối bất thường hoặc xuất hiện giao dịch ngoại lai không?
Số lượng sản phẩm bán ra có mối quan hệ như thế nào với doanh thu?
Thông qua bài thực hành này, bạn sẽ từng bước làm sạch dữ liệu, phân tích các biến và trực quan hóa kết quả để rút ra những nhận định ban đầu về hoạt động kinh doanh.
Notebook thực hành: Xem và chạy toàn bộ code EDA bằng Python trên Google Colab
Thao tác 1: Tạo dữ liệu mẫu và import thư viện
import pandas as pd
import numpy as np
import matplotlib.pyplot as plt
import seaborn as sns
data = {
    "Order_ID": range(1, 13),
    "Product": [
        "Laptop", "Phone", "Tablet", "Laptop",
        "Phone", "Tablet", "Laptop", "Phone",
        "Tablet", "Laptop", "Phone", "Tablet"
    ],
    "Quantity": [
        2, 3, 1, 2, 5, 2, 3, 4, 2, 20, 3, 1
    ],
    "Unit_Price": [
        15000000, 8000000, 5000000, 15000000,
        8000000, np.nan, 15000000, 8000000,
        5000000, 15000000, 8000000, 5000000
    ]
}
df = pd.DataFrame(data)
df["Revenue"] = df["Quantity"] * df["Unit_Price"]
# Thêm một bản ghi trùng lặp để thực hành
df = pd.concat([df, df.iloc[[0]]], ignore_index=True)
print(df.head())
Thao tác 2: Kiểm tra tổng quan dữ liệu
# Kích thước dữ liệu
print("Shape:", df.shape)
# Thông tin và kiểu dữ liệu
df.info()
# Thống kê mô tả
print(df.describe())
# Kiểm tra giá trị thiếu
print(df.isnull().sum())
# Kiểm tra bản ghi trùng lặp
print("Duplicates:", df.duplicated().sum())
Các câu lệnh trên giúp xác định kích thước dữ liệu, kiểu biến, những giá trị thống kê cơ bản và các vấn đề về chất lượng dữ liệu.
Thao tác 3: Phân tích biến phân loại
Với những biến phân loại như Product, người phân tích cần xem xét tần suất xuất hiện của từng nhóm.
product_counts = df["Product"].value_counts()
print(product_counts)
product_counts.plot(
    kind="bar",
    figsize=(8, 5)
)
plt.title("Number of Orders by Product")
plt.xlabel("Product")
plt.ylabel("Number of Orders")
plt.xticks(rotation=0)
plt.tight_layout()
plt.show()
Biểu đồ giúp quan sát sản phẩm nào xuất hiện nhiều nhất trong tập dữ liệu. Tuy nhiên, số lượng đơn hàng không đồng nghĩa với doanh thu hoặc lợi nhuận cao nhất.
Thao tác 4: Xử lý dữ liệu thiếu và trùng lặp
# Tạo bản sao trước khi xử lý
df_clean = df.copy()
# Loại bỏ bản ghi trùng lặp
df_clean = df_clean.drop_duplicates()
# Điền giá trị thiếu theo trung vị từng sản phẩm
df_clean["Unit_Price"] = (
    df_clean.groupby("Product")["Unit_Price"]
    .transform(lambda s: s.fillna(s.median()))
)
# Tính lại doanh thu
df_clean["Revenue"] = (
    df_clean["Quantity"] * df_clean["Unit_Price"]
)
print(df_clean.isnull().sum())
Trong ví dụ này, đơn giá bị thiếu thuộc nhóm Tablet. Vì đơn giá phụ thuộc vào loại sản phẩm, việc sử dụng trung vị theo từng nhóm giúp hạn chế tình trạng lấy giá của một sản phẩm khác để thay thế.
Đây là lý do người làm dữ liệu cần hiểu ý nghĩa nghiệp vụ của các biến trước khi lựa chọn phương pháp xử lý giá trị thiếu.
Thao tác 5: Phân tích phân phối và phát hiện Outlier
Để quan sát phân phối doanh thu, có thể sử dụng Histogram kết hợp KDE Plot.
plt.figure(figsize=(8, 5))
sns.histplot(
    data=df_clean,
    x="Revenue",
    kde=True
)
plt.title("Revenue Distribution")
plt.xlabel("Revenue")
plt.ylabel("Frequency")
plt.tight_layout()
plt.show()
Boxplot giúp nhận diện những giá trị doanh thu có khả năng là ngoại lai.
plt.figure(figsize=(8, 5))
sns.boxplot(
    data=df_clean,
    y="Revenue"
)
plt.title("Revenue Boxplot")
plt.ylabel("Revenue")
plt.tight_layout()
plt.show()
Có thể sử dụng phương pháp IQR để xác định phạm vi giá trị cần kiểm tra:
Q1 = df_clean["Revenue"].quantile(0.25)
Q3 = df_clean["Revenue"].quantile(0.75)
IQR = Q3 - Q1
lower_bound = Q1 - 1.5 * IQR
upper_bound = Q3 + 1.5 * IQR
outliers = df_clean[
    (df_clean["Revenue"] < lower_bound) |
    (df_clean["Revenue"] > upper_bound)
]
print(outliers)
IQR được tính bằng hiệu giữa phân vị thứ ba và phân vị thứ nhất. Các giá trị nằm ngoài khoảng từ Q1 - 1,5 × IQR đến Q3 + 1,5 × IQR được đánh dấu là những điểm có khả năng ngoại lai.
Trong dataset minh họa, đơn Laptop có số lượng 20 chiếc tạo ra doanh thu 300 triệu đồng và được IQR đánh dấu là điểm cần kiểm tra.
Tuy nhiên, đây không nhất thiết là giao dịch sai. Người phân tích cần kiểm tra thêm dữ liệu gốc và bối cảnh kinh doanh trước khi quyết định giữ lại hay loại bỏ.
Thao tác 6: Phân tích doanh thu theo sản phẩm
Để trả lời câu hỏi sản phẩm nào mang lại doanh thu cao nhất, có thể sử dụng groupby() để tổng hợp doanh thu theo từng nhóm sản phẩm.
revenue_by_product = (
    df_clean.groupby("Product")["Revenue"]
    .sum()
    .sort_values(ascending=False)
)
print(revenue_by_product)
plt.figure(figsize=(8, 5))
revenue_by_product.plot(
    kind="bar"
)
plt.title("Total Revenue by Product")
plt.xlabel("Product")
plt.ylabel("Revenue (VND)")
plt.xticks(rotation=0)
plt.tight_layout()
plt.show()
Với bộ dữ liệu mẫu, kết quả doanh thu như sau:
| Sản phẩm | Số đơn hàng | Tổng doanh thu |
|---|---|---|
| Laptop | 4 | 405 triệu đồng |
| Phone | 4 | 120 triệu đồng |
| Tablet | 4 | 30 triệu đồng |
Laptop có doanh thu cao nhất dù số lượng đơn hàng bằng Phone và Tablet. Kết quả này minh họa rằng số lượng đơn hàng không phải yếu tố duy nhất quyết định doanh thu.
Thao tác 7: Phân tích mối quan hệ giữa số lượng và doanh thu
Scatter Plot giúp quan sát mối quan hệ giữa hai biến số và phân biệt các nhóm sản phẩm.
plt.figure(figsize=(8, 5))
sns.scatterplot(
    data=df_clean,
    x="Quantity",
    y="Revenue",
    hue="Product",
    s=100
)
plt.title("Quantity vs Revenue by Product")
plt.xlabel("Quantity")
plt.ylabel("Revenue (VND)")
plt.tight_layout()
plt.show()
Trong ví dụ này, biểu đồ giúp quan sát cách doanh thu thay đổi theo số lượng sản phẩm và sự khác biệt giữa các nhóm hàng có đơn giá khác nhau.
Doanh thu được tính bằng số lượng nhân với đơn giá, vì vậy mối quan hệ quan sát được một phần xuất phát trực tiếp từ công thức tính. Không nên diễn giải đây là bằng chứng về quan hệ nhân quả độc lập.
Thao tác 8: Đánh giá độ lệch của dữ liệu
Độ lệch (Skewness) cho biết mức độ bất đối xứng của phân phối dữ liệu.
skewness = df_clean["Revenue"].skew()
print("Revenue Skewness:", skewness)
Giá trị Skewness dương thường biểu thị phân phối lệch phải, trong khi giá trị âm thường biểu thị phân phối lệch trái.
Nếu dữ liệu doanh thu không âm và có phân phối lệch phải đáng kể, người phân tích có thể xem xét phép biến đổi logarit:
df_clean["Log_Revenue"] = np.log1p(
    df_clean["Revenue"]
)
Phép biến đổi này giúp giảm mức độ lệch của một số phân phối, nhưng không phải lúc nào cũng cần thiết. Cần kiểm tra lại phân phối sau biến đổi và đánh giá tính phù hợp với mục tiêu phân tích.
Tổng hợp kết quả EDA
Sau khi thực hiện các thao tác trên, người phân tích cần kết hợp thống kê và biểu đồ để đưa ra nhận xét.
Một báo cáo EDA cơ bản nên trả lời được các câu hỏi: Dữ liệu có bao nhiêu bản ghi và biến? Có bao nhiêu giá trị thiếu và bản ghi trùng lặp? Các biến số có phân phối như thế nào? Nhóm dữ liệu nào có đặc điểm nổi bật? Có những giá trị ngoại lai nào cần kiểm tra? Cần xử lý hoặc phân tích thêm những vấn đề gì?
Điểm quan trọng không nằm ở số lượng biểu đồ được tạo ra mà là khả năng diễn giải kết quả và đưa ra quyết định dựa trên dữ liệu.
Các công cụ tự động hóa EDA phổ biến
Ngoài việc tự viết code bằng Pandas, Matplotlib và Seaborn, người làm dữ liệu có thể sử dụng các thư viện tự động hóa EDA để tạo báo cáo tổng quan nhanh hơn.
YData Profiling
YData Profiling (trước đây là Pandas Profiling) là thư viện Python hỗ trợ tạo báo cáo khám phá dữ liệu tự động.
Công cụ có thể tổng hợp thông tin về kiểu dữ liệu, thống kê mô tả, giá trị thiếu, phân phối, tương quan và những cảnh báo liên quan đến dữ liệu.
Cài đặt:
pip install ydata-profiling
Thực hiện:
from ydata_profiling import ProfileReport
profile = ProfileReport(
    df_clean,
    title="EDA Report",
    explorative=True
)
profile.to_file("eda_report.html")
Sau khi chạy, bạn có thể mở file HTML để xem báo cáo tổng quan.
Sweetviz
Sweetviz là thư viện hỗ trợ tạo báo cáo EDA trực quan, giúp người dùng khám phá các biến, phân phối dữ liệu và so sánh những tập dữ liệu khác nhau.
Cài đặt:
pip install sweetviz
Thực hiện:
import sweetviz as sv
report = sv.analyze(df_clean)
report.show_html("sweetviz_report.html")
Báo cáo được xuất dưới dạng HTML, thuận tiện cho việc quan sát và chia sẻ.
Lưu ý: Sweetviz có thể gặp vấn đề tương thích với một số phiên bản Python, NumPy hoặc Pandas. Nếu gặp lỗi cài đặt hay thực thi, nên kiểm tra yêu cầu phiên bản của thư viện và thử trong môi trường ảo với các phiên bản phụ thuộc tương thích. Với người mới bắt đầu, YData Profiling có thể là lựa chọn ưu tiên để tạo báo cáo tổng quan.
Nên chọn công cụ EDA nào?
| Công cụ | Điểm mạnh | Khi nào nên sử dụng |
|---|---|---|
| Pandas | Kiểm soát chi tiết từng thao tác | Khi cần khám phá và xử lý dữ liệu linh hoạt |
| Matplotlib và Seaborn | Tùy chỉnh biểu đồ theo mục tiêu | Khi cần phân tích sâu và trình bày trực quan |
| Plotly | Biểu đồ tương tác | Khi cần khám phá dữ liệu trên dashboard |
| YData Profiling | Tạo báo cáo tổng quan tự động | Khi cần kiểm tra nhanh tập dữ liệu |
| Sweetviz | Báo cáo trực quan, hỗ trợ so sánh dữ liệu | Khi cần khám phá và đối chiếu các tập dữ liệu |
Các công cụ tự động hóa giúp tiết kiệm thời gian nhưng không thay thế tư duy phân tích. Người thực hiện vẫn cần kiểm tra các cảnh báo, đánh giá kết quả và xác định vấn đề thực sự có ý nghĩa đối với bài toán.
Phân biệt EDA với Data Cleaning và Data Visualization
EDA, Data Cleaning và Data Visualization là những khái niệm có liên quan nhưng không đồng nghĩa với nhau.
| Tiêu chí | EDA | Data Cleaning | Data Visualization |
|---|---|---|---|
| Bản chất | Khám phá và tìm hiểu dữ liệu | Làm sạch và cải thiện chất lượng dữ liệu | Trình bày dữ liệu bằng hình ảnh |
| Mục tiêu | Phát hiện xu hướng, vấn đề và mối quan hệ | Xử lý dữ liệu thiếu, sai hoặc trùng lặp | Giúp quan sát và truyền tải thông tin |
| Phương pháp | Thống kê, biểu đồ, khám phá dữ liệu | Xóa, thay thế, chuẩn hóa, chuyển đổi | Biểu đồ, đồ thị, dashboard |
| Công cụ | Pandas, Seaborn, R | Pandas, SQL, OpenRefine | Matplotlib, Tableau, Power BI |
Điểm khác biệt quan trọng là EDA có phạm vi rộng hơn việc làm sạch hay trực quan hóa dữ liệu. Đây là quá trình khám phá tổng thể, trong đó Data Cleaning và Data Visualization có thể được sử dụng như những hoạt động hỗ trợ.
Người mới học Data Science cần biết gì về EDA?
Đối với người mới bắt đầu, EDA là một trong những kỹ năng quan trọng cần xây dựng khi học Data Science.
Để thực hiện EDA hiệu quả, bạn cần biết kiến thức thống kê cơ bản, Python, Pandas, NumPy và kỹ năng trực quan hóa dữ liệu. Bên cạnh kiến thức kỹ thuật, tư duy đặt câu hỏi và diễn giải kết quả cũng rất quan trọng.
Bạn không cần thành thạo toàn bộ kiến thức ngay từ đầu. Hãy bắt đầu bằng những bộ dữ liệu nhỏ, thực hành từng kỹ thuật và dần nâng cao độ phức tạp của bài toán.
Nếu muốn phát triển theo hướng Data Science, bạn có thể tìm hiểu lộ trình học từ thống kê, Python, SQL đến xử lý dữ liệu, Machine Learning và thực hiện các dự án thực tế.
Câu hỏi thường gặp về EDA
1. EDA có phải là một thuật toán Machine Learning không?
Không. EDA là phương pháp tiếp cận để khám phá và tìm hiểu dữ liệu, không phải thuật toán Machine Learning. Tuy nhiên, kết quả EDA có thể hỗ trợ lựa chọn và xây dựng mô hình học máy.
2. EDA thường được thực hiện ở giai đoạn nào?
EDA thường được thực hiện sau khi thu thập dữ liệu và trước khi xây dựng mô hình phân tích hoặc Machine Learning. Tuy nhiên, đây là quá trình lặp lại và có thể tiếp tục trong các giai đoạn phát triển dự án.
3. Có thể thực hiện EDA mà không cần Python không?
Có. Bạn có thể sử dụng Excel, R, SQL, Tableau hoặc Power BI tùy theo mục tiêu và đặc điểm dữ liệu. Python chỉ là một lựa chọn phổ biến nhờ hệ sinh thái thư viện phong phú.
4. EDA có bắt buộc trong mọi dự án Data Science không?
Không phải mọi dự án đều có một quy trình EDA giống nhau. Tuy nhiên, việc khám phá và hiểu dữ liệu là hoạt động rất quan trọng để hạn chế sai sót, đánh giá chất lượng dữ liệu và lựa chọn phương pháp phân tích phù hợp.
5. Người mới học có thể thực hiện EDA không?
Có. Người mới có thể bắt đầu với các bộ dữ liệu đơn giản, sử dụng Pandas để kiểm tra dữ liệu và Matplotlib hoặc Seaborn để trực quan hóa. Sau đó, bạn có thể nâng cao kỹ năng thông qua các bài tập và dự án thực tế.
6. EDA khác gì với Data Analysis?
EDA tập trung vào việc khám phá dữ liệu để nhận diện đặc điểm, xu hướng và các mối quan hệ tiềm ẩn. Data Analysis có phạm vi rộng hơn, bao gồm việc đặt câu hỏi, xử lý dữ liệu, phân tích, diễn giải kết quả và hỗ trợ ra quyết định. EDA thường là một phần trong quy trình phân tích dữ liệu.