Machine Learning và Data Science thường xuất hiện cùng nhau trong các chủ đề về AI và phân tích dữ liệu, nhưng hai lĩnh vực này không đồng nghĩa. Data Science là cả quy trình dùng dữ liệu để giải bài toán kinh doanh: thu thập, làm sạch, phân tích và trình bày insight để hỗ trợ ra quyết định. Machine Learning là phương pháp giúp máy tự học quy luật từ dữ liệu để dự đoán, chẳng hạn khách hàng nào sẽ mua hàng. Data Science có thể dùng Machine Learning như một công cụ, nhưng không phải dự án nào cũng cần, và Machine Learning cũng được dùng ngoài Data Science, như nhận diện hình ảnh hay robot.
Nếu bạn đang cân nhắc theo đuổi lĩnh vực dữ liệu, bài viết này giúp bạn phân biệt hai hướng đi qua mục tiêu, kiến thức, công cụ, sản phẩm đầu ra và vị trí công việc. Bài cũng có ví dụ code Python, mức lương tham khảo tại Việt Nam và lộ trình gợi ý cho người mới, để bạn biết nên bắt đầu từ đâu.
Machine Learning là gì?
Machine Learning (học máy) là một nhánh của trí tuệ nhân tạo (AI), cho phép máy tính học quy luật từ dữ liệu để dự đoán, phân loại hoặc đưa ra quyết định mà không cần lập trình riêng từng quy tắc cho mọi trường hợp.
Thay vì yêu cầu hệ thống xử lý từng tình huống bằng các câu lệnh cố định, Machine Learning sử dụng thuật toán để tìm ra mối quan hệ trong dữ liệu. Từ đó, mô hình được huấn luyện để xử lý những dữ liệu mới.
Ví dụ, một nền tảng thương mại điện tử có thể sử dụng lịch sử mua hàng và hành vi tìm kiếm để dự đoán sản phẩm mà khách hàng có khả năng quan tâm.
Đặc điểm và nguyên lý hoạt động của Machine Learning
Một hệ thống Machine Learning cơ bản thường có ba thành phần:
Dữ liệu: Thông tin được sử dụng để huấn luyện và kiểm tra mô hình.
Thuật toán: Phương pháp giúp hệ thống tìm kiếm quy luật trong dữ liệu.
Mô hình: Kết quả sau quá trình huấn luyện, được sử dụng để dự đoán hoặc phân loại dữ liệu mới.
Quy trình phổ biến gồm chuẩn bị dữ liệu, lựa chọn thuật toán, huấn luyện mô hình, đánh giá kết quả và điều chỉnh tham số. Khi đạt hiệu quả phù hợp, mô hình có thể được tích hợp vào ứng dụng thực tế.
Các phương pháp Machine Learning phổ biến
Machine Learning thường được chia thành ba nhóm phương pháp:
Supervised Learning (học có giám sát): Mô hình được huấn luyện bằng dữ liệu đã có nhãn. Ví dụ: phân loại email spam, dự đoán giá nhà hoặc xác định khách hàng có khả năng rời bỏ dịch vụ.
Unsupervised Learning (học không giám sát): Mô hình tìm kiếm cấu trúc và quy luật trong dữ liệu chưa có nhãn. Một ứng dụng phổ biến là phân nhóm khách hàng theo hành vi mua sắm.
Reinforcement Learning (học tăng cường): Hệ thống học cách lựa chọn hành động thông qua tương tác với môi trường, nhận phần thưởng hoặc hình phạt dựa trên kết quả. Phương pháp này được ứng dụng trong robot, trò chơi và một số bài toán tối ưu hóa.
Ứng dụng Machine Learning trong thực tế
Machine Learning được sử dụng trong nhiều sản phẩm và hoạt động kinh doanh:
Nhận diện hình ảnh: Phân loại hình ảnh, nhận diện vật thể và phát hiện lỗi sản phẩm.
Hệ thống gợi ý: Đề xuất phim, sản phẩm hoặc nội dung dựa trên sở thích người dùng.
Dự báo nhu cầu: Phân tích dữ liệu bán hàng để ước tính nhu cầu trong tương lai.
Phát hiện gian lận: Nhận diện giao dịch có dấu hiệu bất thường trong lĩnh vực tài chính.
Data Science là gì?
Data Science (khoa học dữ liệu) là lĩnh vực kết hợp thống kê, toán học, lập trình và kiến thức chuyên ngành để thu thập, xử lý, phân tích dữ liệu và khai thác thông tin có giá trị.
Mục tiêu của Data Science không chỉ là xử lý dữ liệu mà còn tìm ra insight, giải thích hiện tượng và hỗ trợ tổ chức đưa ra quyết định dựa trên bằng chứng.
Chẳng hạn, khi doanh thu giảm, doanh nghiệp có thể sử dụng Data Science để phân tích dữ liệu bán hàng, hành vi khách hàng và hiệu quả chiến dịch marketing nhằm tìm hiểu những yếu tố liên quan đến sự thay đổi này.
Đặc điểm và mục tiêu của Data Science
Data Science có phạm vi rộng, bao gồm nhiều hoạt động từ thu thập dữ liệu đến phân tích và truyền đạt kết quả.
Người làm Data Science cần kết hợp kiến thức thống kê, lập trình và hiểu biết về lĩnh vực đang phân tích. Họ có thể sử dụng SQL để truy vấn dữ liệu, Python để xử lý và phân tích, hoặc công cụ trực quan hóa để trình bày kết quả.
Điểm quan trọng là không phải dự án Data Science nào cũng cần Machine Learning. Với một số bài toán, thống kê mô tả, phân tích dữ liệu và trực quan hóa đã đủ để tìm ra thông tin cần thiết.
Các công đoạn trong quy trình Data Science
Một quy trình Data Science thường gồm năm công đoạn:
Thu thập dữ liệu: Lấy dữ liệu từ cơ sở dữ liệu, hệ thống nội bộ, tệp tin, API hoặc nguồn phù hợp.
Làm sạch và xử lý dữ liệu: Xử lý dữ liệu thiếu, trùng lặp, sai định dạng và giá trị bất thường.
Phân tích khám phá dữ liệu (EDA): Sử dụng thống kê và trực quan hóa để tìm hiểu đặc điểm, xu hướng và mối quan hệ giữa các biến.
Xây dựng mô hình: Áp dụng phương pháp thống kê hoặc Machine Learning nếu bài toán yêu cầu dự đoán, phân loại hay phân nhóm.
Trực quan hóa và truyền đạt insight: Trình bày kết quả qua biểu đồ, báo cáo hoặc dashboard để hỗ trợ ra quyết định.
Quy trình này có thể thay đổi tùy mục tiêu dự án. Trong thực tế, người làm Data Science thường phải quay lại xử lý dữ liệu hoặc điều chỉnh phương pháp khi kết quả chưa đáp ứng yêu cầu.
Ứng dụng Data Science trong thực tế
Một số ứng dụng phổ biến của Data Science gồm:
Phân tích hành vi khách hàng: Tìm hiểu nhu cầu, sở thích và mức độ trung thành.
Dự báo kinh doanh: Phân tích dữ liệu lịch sử để hỗ trợ dự báo doanh thu và nhu cầu thị trường.
Phân tích tài chính: Đánh giá xu hướng, rủi ro và hiệu quả hoạt động.
Tối ưu vận hành: Phân tích dữ liệu kho hàng, chuỗi cung ứng và quy trình sản xuất.
So sánh Machine Learning và Data Science chi tiết
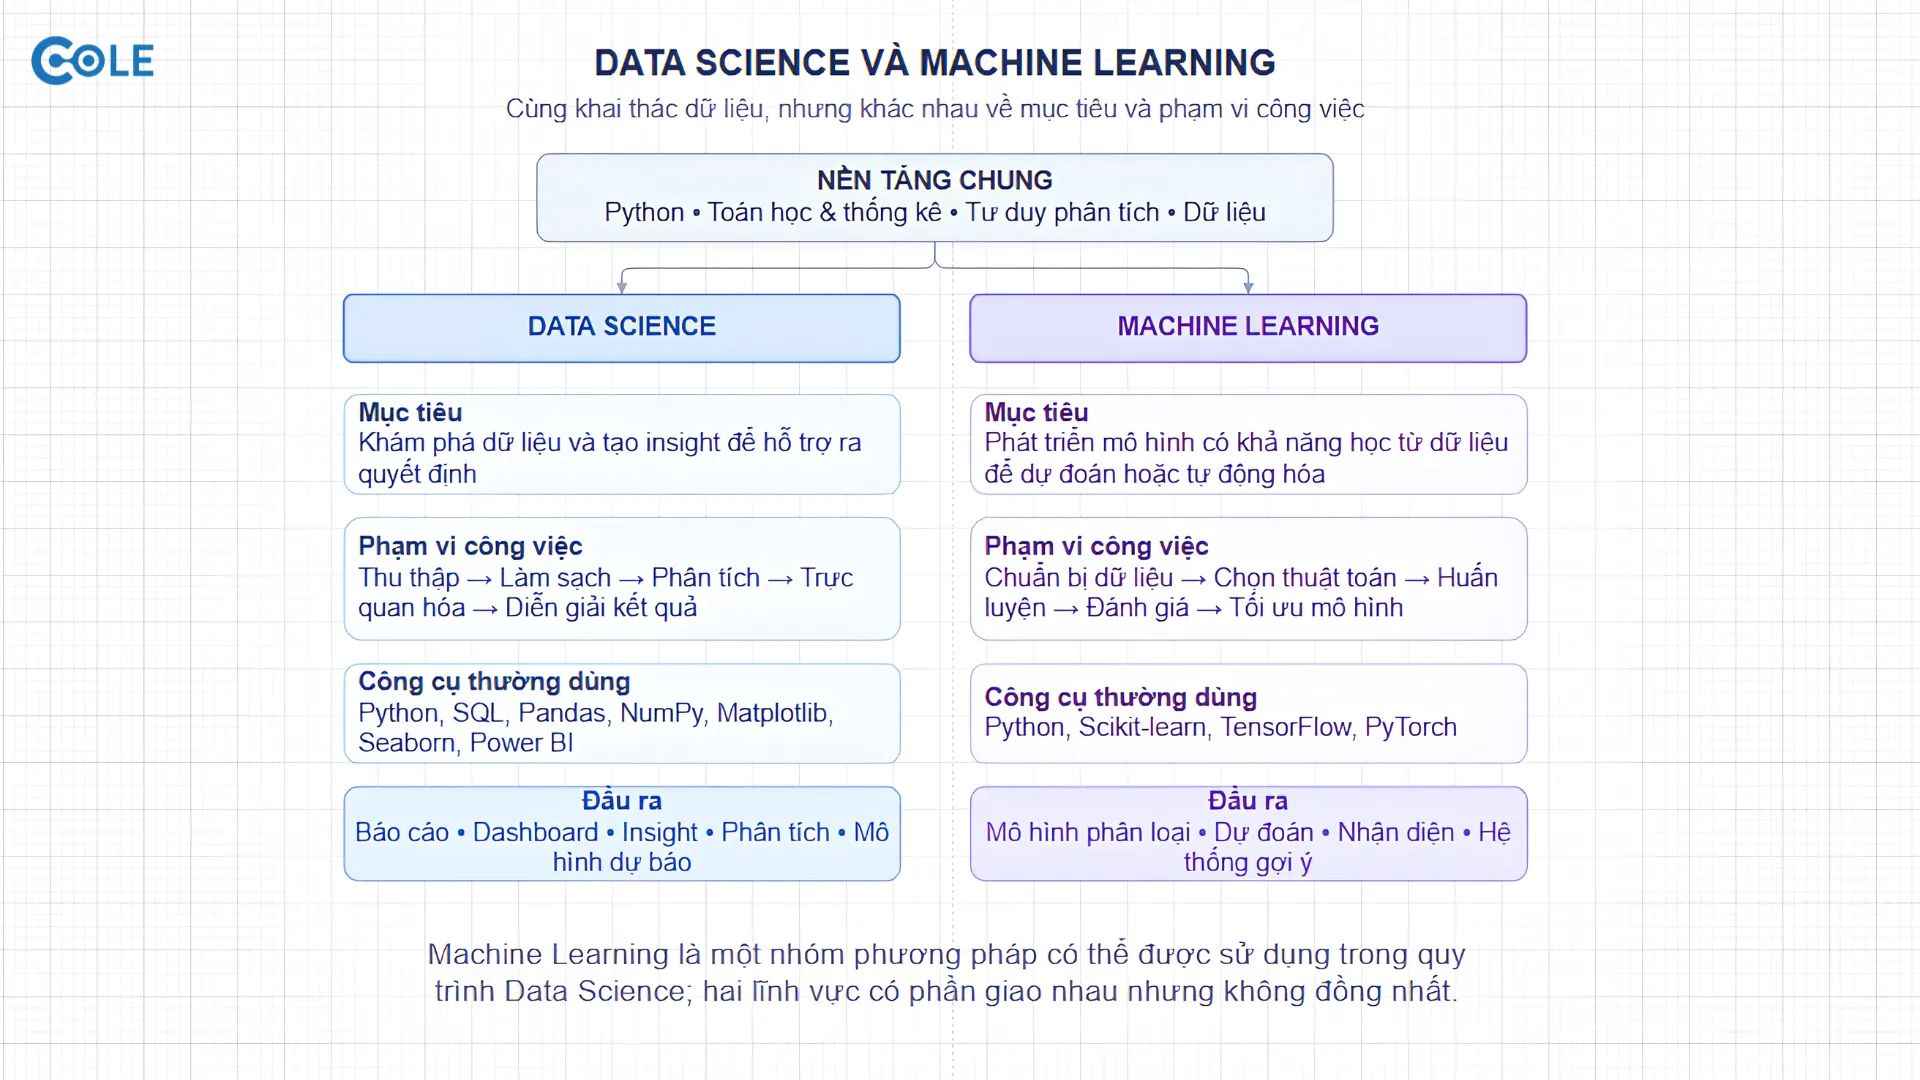
Machine Learning và Data Science có điểm chung là sử dụng dữ liệu, lập trình và phương pháp toán học. Tuy nhiên, mục tiêu và phạm vi công việc của hai lĩnh vực không giống nhau.
So sánh về mục tiêu và phạm vi công việc
Data Science hướng đến việc khai thác giá trị từ dữ liệu để giải quyết vấn đề. Công việc có thể trải dài từ thu thập, làm sạch, phân tích đến trực quan hóa và xây dựng mô hình.
Machine Learning tập trung vào phát triển thuật toán và mô hình có khả năng học từ dữ liệu. Người làm thường dành nhiều thời gian cho việc lựa chọn phương pháp, huấn luyện, đánh giá và tối ưu mô hình.
Có thể hiểu đơn giản: Data Science quan tâm đến việc giải quyết bài toán bằng dữ liệu, còn Machine Learning cung cấp một nhóm phương pháp để hệ thống học và dự đoán từ dữ liệu.
So sánh về kiến thức và kỹ năng cần thiết
Người học Data Science cần kiến thức thống kê, xác suất, lập trình, xử lý dữ liệu và tư duy phân tích. Khả năng hiểu bài toán kinh doanh và trình bày kết quả cũng rất quan trọng.
Với Machine Learning, kiến thức toán học và thuật toán thường được đào sâu hơn. Người học cần hiểu cách mô hình hoạt động, phương pháp huấn luyện, đánh giá hiệu suất và những vấn đề như overfitting (quá khớp) hoặc underfitting (thiếu khớp).
Hai lĩnh vực đều cần tư duy logic và kỹ năng lập trình. Mức độ chuyên sâu của từng nhóm kiến thức phụ thuộc vào vị trí công việc.
So sánh về ngôn ngữ lập trình và công cụ
Python là ngôn ngữ phổ biến trong cả hai lĩnh vực.
Với Data Science, người học thường làm việc với Python, SQL, Pandas, NumPy và các công cụ trực quan hóa như Matplotlib, Seaborn hoặc Power BI.
Với Machine Learning, các thư viện thường gặp gồm Scikit-learn, TensorFlow và PyTorch. Chúng hỗ trợ xây dựng, huấn luyện và đánh giá mô hình học máy.
SQL cũng có thể được sử dụng trong dự án Machine Learning để truy vấn và chuẩn bị dữ liệu. Vì vậy, không nên hiểu rằng mỗi lĩnh vực chỉ sử dụng một nhóm công cụ riêng biệt.
So sánh về sản phẩm đầu ra
Sản phẩm của Data Science có thể là báo cáo phân tích, dashboard, bộ dữ liệu đã xử lý, insight hoặc mô hình dự báo. Kết quả cần giúp người sử dụng hiểu vấn đề và đưa ra quyết định.
Trong khi đó, sản phẩm của Machine Learning thường là mô hình phân loại, dự đoán, nhận diện hoặc hệ thống gợi ý. Những mô hình này có thể được tích hợp vào phần mềm hoặc quy trình vận hành.
So sánh về vị trí công việc và trách nhiệm
Các vị trí liên quan đến Data Science gồm Data Analyst, Data Scientist và Business Intelligence Analyst. Tùy doanh nghiệp, Data Scientist có thể đảm nhận cả việc xây dựng mô hình Machine Learning.
Các vị trí liên quan đến Machine Learning gồm Machine Learning Engineer, AI Engineer hoặc Machine Learning Researcher. Công việc thường yêu cầu kiến thức chuyên sâu hơn về mô hình, thuật toán và triển khai hệ thống.
Tên chức danh không phải lúc nào cũng phản ánh chính xác phạm vi công việc. Khi tìm hiểu nghề nghiệp, bạn nên xem kỹ mô tả tuyển dụng thay vì chỉ dựa vào tên vị trí.
Bảng tổng hợp sự khác nhau giữa Machine Learning và Data Science
| Tiêu chí | Machine Learning | Data Science |
|---|---|---|
| Mục tiêu | Xây dựng mô hình học từ dữ liệu | Khai thác giá trị và insight từ dữ liệu |
| Phạm vi | Thuật toán, huấn luyện và đánh giá mô hình | Thu thập, xử lý, phân tích và ứng dụng dữ liệu |
| Kỹ năng | Lập trình, toán học, thuật toán | Thống kê, lập trình, phân tích dữ liệu |
| Công cụ | Python, Scikit-learn, TensorFlow, PyTorch | Python, SQL, Pandas, Power BI |
| Đầu ra | Mô hình dự đoán, phân loại, gợi ý | Báo cáo, insight, dashboard, mô hình phân tích |
| Vị trí liên quan | Machine Learning Engineer, AI Engineer | Data Scientist, Data Analyst, BI Analyst |
Mối quan hệ giữa Machine Learning và Data Science
Machine Learning và Data Science không nằm hoàn toàn bên trong nhau. Hai lĩnh vực có phần giao nhau, đặc biệt khi Data Science sử dụng thuật toán học máy để phân tích và dự đoán.
Có thể hình dung mối quan hệ này bằng hai vòng tròn giao nhau: Machine Learning thuộc AI, còn Data Science là lĩnh vực liên ngành. Phần giao nhau thể hiện những hoạt động sử dụng Machine Learning trong các dự án khai thác dữ liệu.
Machine Learning có phải là một phần của Data Science không?
Cần phân biệt hai góc nhìn:
Về phân loại lĩnh vực: Machine Learning là một nhánh của AI, bên cạnh các hướng nghiên cứu và ứng dụng khác.
Về ứng dụng: Machine Learning là một trong những phương pháp được sử dụng trong Data Science để giải quyết bài toán dự đoán, phân loại hoặc nhận diện quy luật.
Do đó, Machine Learning không phải toàn bộ Data Science và Data Science cũng không bao trùm toàn bộ Machine Learning. Hai lĩnh vực giao nhau nhưng có mục tiêu và phạm vi riêng.
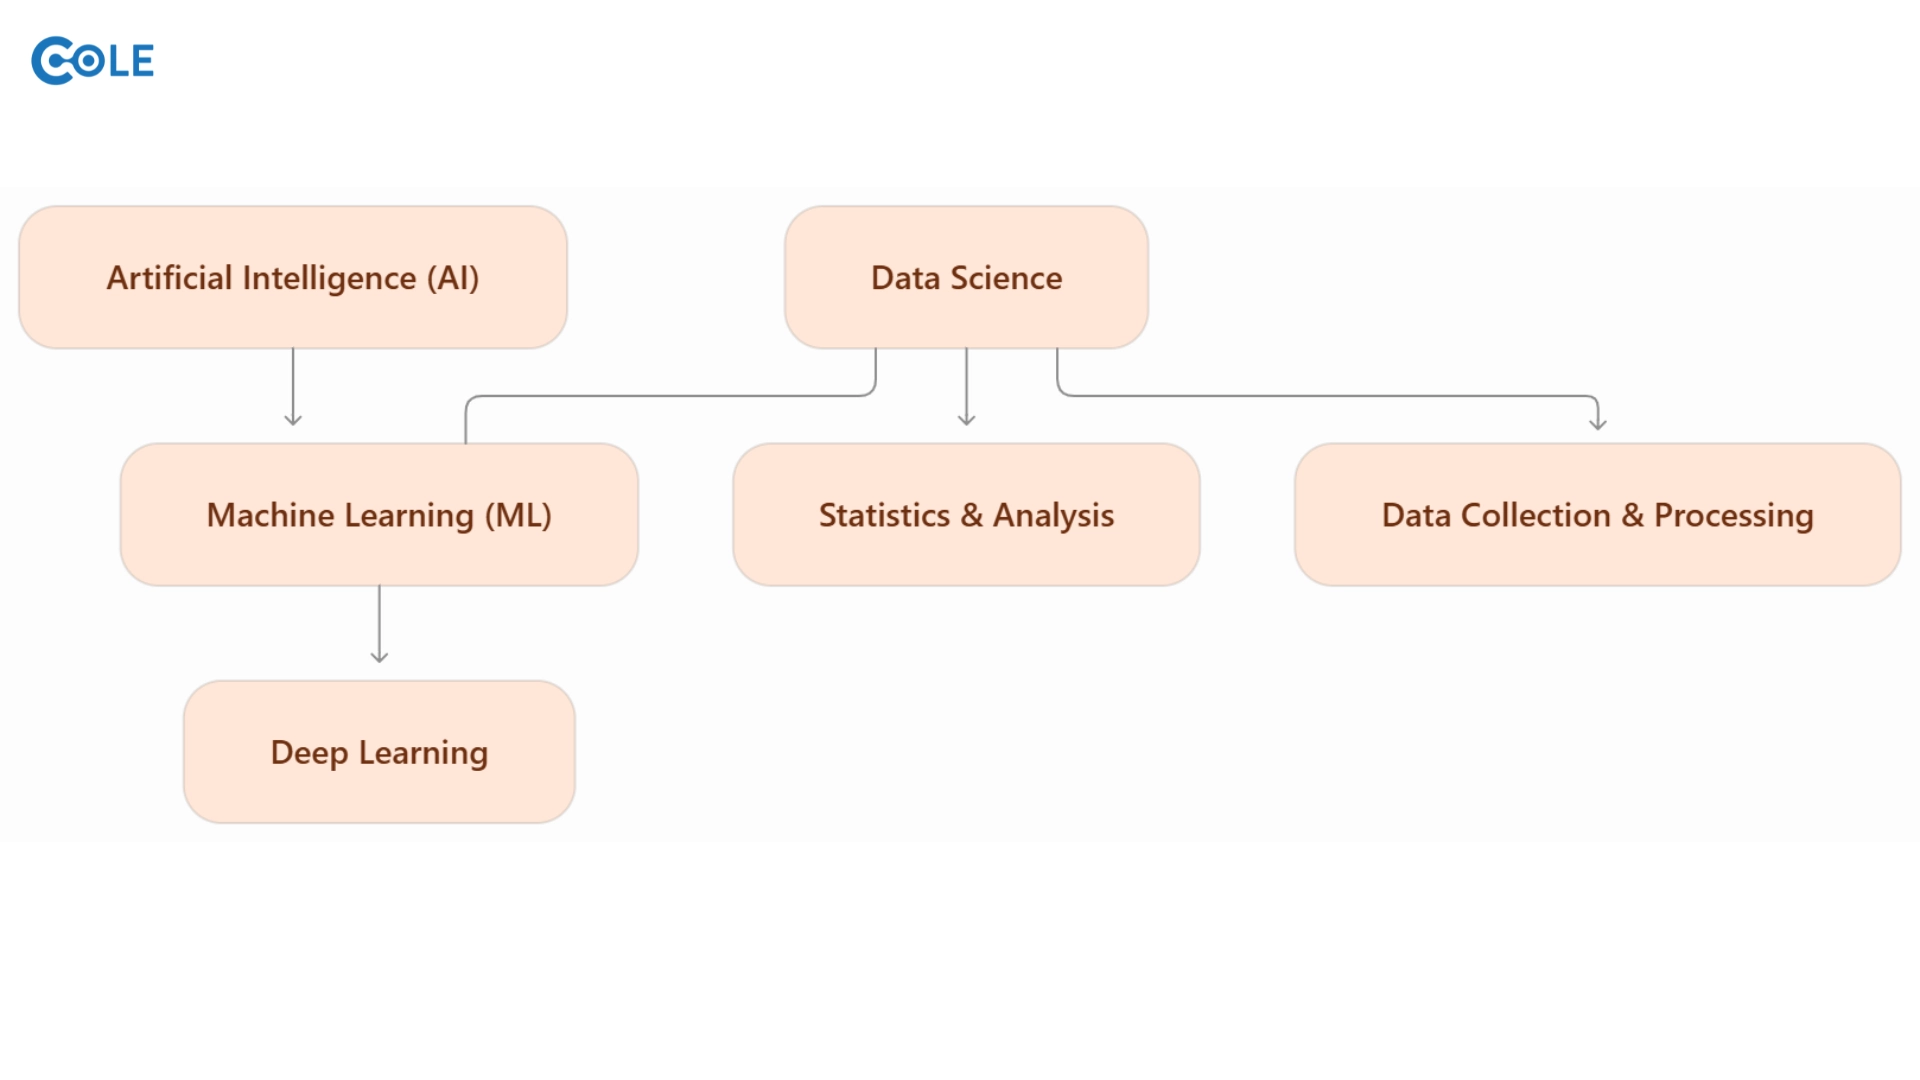
Ví dụ ứng dụng Machine Learning trong một dự án Data Science
Giả sử một doanh nghiệp thương mại điện tử muốn dự đoán khách hàng có khả năng mua một sản phẩm để tối ưu chiến dịch marketing.
| Giai đoạn | Công việc | Kết quả |
|---|---|---|
| Data Science | Thu thập lịch sử mua hàng, lượt xem, thời gian truy cập | Bộ dữ liệu khách hàng |
| Data Science | Làm sạch và phân tích hành vi | Xác định đặc điểm khách hàng |
| Machine Learning | Huấn luyện mô hình phân loại | Dự đoán khả năng mua hàng |
| Ứng dụng | Đưa kết quả vào chiến dịch marketing | Hỗ trợ phân nhóm khách hàng |
Trong ví dụ này, Data Science giúp xác định bài toán và chuẩn bị dữ liệu. Machine Learning được sử dụng để xây dựng mô hình dự đoán. Kết quả sau đó hỗ trợ doanh nghiệp lựa chọn nhóm khách hàng phù hợp hơn.
Machine Learning hoạt động như thế nào? Thử xây dựng mô hình dự đoán bằng Python
Sau khi thu thập và xử lý dữ liệu khách hàng, người làm Data Science có thể sử dụng Machine Learning để xây dựng mô hình dự đoán khả năng mua hàng.
Ví dụ, doanh nghiệp có dữ liệu về số lần khách hàng truy cập website, số sản phẩm đã xem và số đơn hàng trước đó. Mô hình có thể sử dụng những đặc điểm này để phân loại khách hàng thành hai nhóm: có khả năng mua hàng và chưa có khả năng mua hàng.
Đoạn code Python dưới đây minh họa cách sử dụng thuật toán Random Forest trong thư viện Scikit-learn:
import numpy as np
import pandas as pd
from sklearn.model_selection import train_test_split, cross_val_score
from sklearn.compose import ColumnTransformer
from sklearn.pipeline import Pipeline
from sklearn.preprocessing import StandardScaler, OneHotEncoder
from sklearn.linear_model import LogisticRegression
from sklearn.ensemble import RandomForestClassifier
1. Tạo dữ liệu mẫu: 3.000 khách hàng (dữ liệu giả lập)
rng = np.random.default_rng(42)
n = 3000
df = pd.DataFrame({
    "so_lan_truy_cap": rng.integers(1, 30, n),
    "so_san_pham_da_xem": rng.integers(1, 50, n),
    "so_don_truoc_do": rng.integers(0, 10, n),
    "kenh": rng.choice(["quang_cao", "tim_kiem", "email"], n),
})
# Khách xem nhiều sản phẩm VÀ đã từng mua có xu hướng mua mạnh hơn hẳn
diem = (df["so_lan_truy_cap"] * 0.06
        + df["so_san_pham_da_xem"] * 0.03
        + df["so_don_truoc_do"] * 0.25
        + (df["kenh"] == "email") * 0.8
        + (df["so_san_pham_da_xem"] > 30) * (df["so_don_truoc_do"] > 4) * 2.0)
df["co_mua_hang"] = rng.binomial(1, 1 / (1 + np.exp(-(diem - diem.mean()) * 1.2)))
X, y = df.drop(columns="co_mua_hang"), df["co_mua_hang"]
X_tr, X_te, y_tr, y_te = train_test_split(X, y, test_size=0.2, stratify=y, random_state=42)
# 2. Pipeline: tự động chuẩn hóa cột số, mã hóa cột chữ, rồi huấn luyện
tien_xu_ly = ColumnTransformer([
    ("so", StandardScaler(), ["so_lan_truy_cap", "so_san_pham_da_xem", "so_don_truoc_do"]),
    ("chu", OneHotEncoder(), ["kenh"]),
])
cac_mo_hinh = {
    "Logistic Regression": LogisticRegression(max_iter=1000),
    "Random Forest": RandomForestClassifier(n_estimators=200, random_state=42),
}
# 3. So sánh 2 mô hình bằng cross-validation (AUC: càng gần 1 càng tốt, 0,5 = đoán ngẫu nhiên)
diem_auc = {}
for ten, m in cac_mo_hinh.items():
    pipe = Pipeline([("xu_ly", tien_xu_ly), ("mo_hinh", m)])
    diem_auc[ten] = cross_val_score(pipe, X_tr, y_tr, cv=5, scoring="roc_auc").mean()
    print(f"{ten}: AUC = {diem_auc[ten]:.3f}")
ten_tot_nhat = max(diem_auc, key=diem_auc.get)
print(f"-> Chọn mô hình: {ten_tot_nhat}")
# 4. Dùng mô hình thắng cuộc để trả lời câu hỏi kinh doanh
pipe = Pipeline([("xu_ly", tien_xu_ly), ("mo_hinh", cac_mo_hinh[ten_tot_nhat])]).fit(X_tr, y_tr)
X_te = X_te.assign(xac_suat_mua=pipe.predict_proba(X_te)[:, 1], thuc_te=y_te)
top20 = X_te.nlargest(int(len(X_te) * 0.2), "xac_suat_mua")
print(f"\nTỷ lệ mua trung bình: {y_te.mean():.1%}")
print(f"Tỷ lệ mua ở nhóm 20% khách hàng được mô hình chấm cao nhất: {top20['thuc_te'].mean():.1%}")
Trong ví dụ này:
pd.DataFrame() tạo bảng dữ liệu khách hàng, mỗi dòng là một khách hàng, mỗi cột là một đặc điểm.
train_test_split() chia dữ liệu thành tập huấn luyện và tập kiểm tra. Tham số stratify=y giữ tỷ lệ người mua và không mua giống nhau ở cả hai tập.
StandardScaler() đưa các cột số (số lần truy cập, số sản phẩm đã xem...) về cùng một thang đo để mô hình không bị lệch về cột có giá trị lớn.
OneHotEncoder() chuyển cột chữ như “kênh” thành các cột 0/1 để máy tính xử lý được.
ColumnTransformer() áp dụng đúng cách xử lý cho từng nhóm cột: cột số dùng StandardScaler, cột chữ dùng OneHotEncoder.
Pipeline() nối bước xử lý dữ liệu và bước huấn luyện thành một chuỗi, giúp dữ liệu mới luôn được xử lý giống hệt dữ liệu huấn luyện.
LogisticRegression() và RandomForestClassifier() khởi tạo hai thuật toán phân loại để so sánh với nhau.
cross_val_score() chia dữ liệu huấn luyện thành 5 phần, lần lượt dùng từng phần để kiểm tra và trả về điểm AUC trung bình của mô hình.
.fit() giúp mô hình học từ dữ liệu huấn luyện.
.predict_proba() dự đoán xác suất mua hàng của từng khách hàng trên dữ liệu mới, thay vì chỉ trả lời “mua” hoặc “không mua”.
.nlargest() lọc ra nhóm khách hàng có xác suất mua cao nhất để kiểm tra xem mô hình xếp hạng có hiệu quả không.
Đây là ví dụ minh họa trên dữ liệu giả lập, nên kết quả đẹp hơn so với thực tế. Với dữ liệu thật, bạn cần làm sạch dữ liệu kỹ hơn, kiểm tra xem mô hình có bị quá khớp (overfitting) hay không, và đánh giá thêm Precision, Recall, F1-score bên cạnh AUC. Sau khi triển khai, mô hình cũng cần được theo dõi vì hành vi khách hàng có thể thay đổi theo thời gian.
Qua ví dụ này có thể thấy Data Science đảm nhiệm việc xác định bài toán, thu thập và xử lý dữ liệu; Machine Learning cung cấp thuật toán để xây dựng mô hình dự đoán.
Nhu cầu nhân lực và mức lương Data Science, Machine Learning tại Việt Nam
Nhu cầu khai thác dữ liệu và ứng dụng AI đang khiến các kỹ năng phân tích, lập trình và xây dựng mô hình trở nên quan trọng hơn trong nhiều ngành. Tuy vậy, cơ hội việc làm và thu nhập vẫn phụ thuộc vào năng lực, kinh nghiệm, vị trí và quy mô doanh nghiệp.
Nhu cầu nhân lực AI và dữ liệu
Bức tranh toàn cầu. Báo cáo Future of Jobs 2025 của World Economic Forum xác định AI và Big Data là nhóm kỹ năng tăng trưởng nhanh nhất trong giai đoạn 2025–2030, tiếp theo là mạng và an ninh mạng, rồi năng lực sử dụng công nghệ. Báo cáo cũng dự báo khoảng 39% kỹ năng cốt lõi của người lao động sẽ thay đổi vào năm 2030.
Tại Việt Nam. Theo Báo cáo Đánh giá mức độ sẵn sàng về AI tại Việt Nam của UNESCO, thị trường AI trong nước đạt khoảng 547 triệu USD năm 2023 và được dự báo vượt 2 tỷ USD vào năm 2032. Cũng theo báo cáo này, kỹ sư AI chiếm khoảng 4,2% tổng số tin tuyển dụng ICT năm 2024. Báo cáo còn đề cập tình trạng thiếu hụt nhân lực CNTT, nhưng con số 150.000–200.000 người mỗi năm là mức thiếu hụt nhân lực IT nói chung, không phải riêng kỹ sư AI hay Data Scientist.
Không chỉ có Data Scientist và ML Engineer. Doanh nghiệp còn cần Data Analyst, Data Engineer, Business Intelligence Analyst và những người biết kết nối dữ liệu với hoạt động kinh doanh. Khi xem tin tuyển dụng, bạn sẽ thường gặp các yêu cầu như Python, SQL, thống kê, trực quan hóa, xử lý dữ liệu và hiểu biết cơ bản về AI.
Mức lương Data Scientist và Machine Learning Engineer
Theo báo cáo Vietnam IT & Tech Talent Landscape 2024–2025 của TopDev, mức lương tháng trước thuế của một số vị trí nhóm Data & Analytics như sau:
| Vị trí | Khoảng lương/tháng | Mức trung vị/tháng |
|---|---|---|
| Data Scientist | 1.490–2.310 USD | 1.640 USD |
| Machine Learning Engineer | 1.480–2.380 USD | 1.680 USD |
| Data Analyst | 1.130–1.860 USD | 1.230 USD |
| AI Engineer | 1.110–2.060 USD | 1.360 USD |
Đây là số liệu tham khảo, không phải mức lương đảm bảo cho mọi ứng viên. Thu nhập thực tế thay đổi theo kinh nghiệm, năng lực, địa điểm và yêu cầu công việc.
Báo cáo Vietnam IT Salary & Recruitment Market Report 2025–2026 của ITviec ghi nhận mức lương trung vị 40,65 triệu đồng/tháng cho nhóm Data Analyst/Data Scientist/Business Intelligence Analyst. Vì ba chức danh được gộp chung, bạn không nên dùng con số này để suy ra lương riêng của Data Scientist hay đem so trực tiếp với Machine Learning Engineer.
Khi đọc các báo cáo lương, hãy chú ý năm khảo sát, nhóm chức danh và cách tính thu nhập. Một con số trung vị không đại diện cho toàn bộ thị trường.
Triển vọng nghề nghiệp trong lĩnh vực dữ liệu
Bên cạnh các kỹ năng nền tảng, lĩnh vực dữ liệu đang phát triển theo một số hướng đáng chú ý:
Deep Learning: mở rộng khả năng xử lý hình ảnh, âm thanh, ngôn ngữ và các loại dữ liệu phức tạp.
Generative AI và LLM: được dùng trong tìm kiếm thông tin, phân tích tài liệu, truy vấn dữ liệu bằng ngôn ngữ tự nhiên và tự động hóa quy trình.
MLOps: kết hợp Machine Learning với vận hành phần mềm để triển khai, giám sát và duy trì mô hình trong môi trường thực tế.
AI hỗ trợ phân tích: công cụ AI giúp viết truy vấn, tạo code và khám phá dữ liệu nhanh hơn, nhưng người làm dữ liệu vẫn phải kiểm tra kết quả, hiểu nguồn dữ liệu và chịu trách nhiệm về kết luận.
Học thêm nhiều công cụ AI không tự động tạo lợi thế nghề nghiệp. Nền tảng dữ liệu, khả năng giải quyết vấn đề và tư duy kiểm chứng vẫn là những yếu tố quyết định.
Nên học Machine Learning hay Data Science?
Lựa chọn giữa hai lĩnh vực phụ thuộc vào sở thích, kiến thức nền tảng và mục tiêu nghề nghiệp. Người mới chưa nhất thiết phải quyết định chuyên sâu ngay từ đầu.
Ai nên lựa chọn Data Science?
Data Science phù hợp với người yêu thích phân tích dữ liệu, tìm kiếm quy luật và sử dụng thông tin để giải quyết vấn đề thực tế.
Nếu muốn phát triển theo hướng Data Analyst, Data Scientist hoặc Business Intelligence Analyst, bạn nên chú trọng thống kê, SQL, Python, phân tích dữ liệu và trực quan hóa.
Ai nên lựa chọn Machine Learning?
Machine Learning phù hợp với người yêu thích lập trình, toán học và thuật toán, đặc biệt khi muốn xây dựng mô hình dự đoán hoặc ứng dụng AI.
Nếu định hướng trở thành Machine Learning Engineer hoặc AI Engineer, bạn cần đầu tư sâu hơn vào thuật toán, đại số tuyến tính, xác suất, tối ưu hóa và kỹ năng triển khai mô hình.
Người mới bắt đầu nên học lĩnh vực nào trước?
Nếu chưa có nền tảng về dữ liệu, bạn nên bắt đầu từ những kiến thức cốt lõi trước khi đi sâu vào Machine Learning.
Một lộ trình tham khảo có thể chia thành các giai đoạn:
| Giai đoạn | Nội dung cần học | Sản phẩm thực hành |
|---|---|---|
| 1. Nền tảng | Python, SQL | Truy vấn và xử lý một bộ dữ liệu |
| 2. Thống kê | Xác suất, thống kê cơ bản | Phân tích đặc điểm dữ liệu |
| 3. Phân tích | Pandas, EDA, trực quan hóa | Báo cáo phân tích dữ liệu bán hàng |
| 4. Machine Learning | Hồi quy, phân loại, phân nhóm | Mô hình dự đoán khách hàng |
| 5. Dự án | Kết hợp kiến thức đã học | Portfolio giải quyết một bài toán thực tế |
Thời gian học từng giai đoạn phụ thuộc vào nền tảng và thời lượng tự học của mỗi người. Quan trọng hơn việc hoàn thành thật nhanh là có thể giải thích được dữ liệu đầu vào, phương pháp xử lý và ý nghĩa của kết quả.
Nếu muốn tìm hiểu sâu hơn về thứ tự kiến thức và nội dung cần chuẩn bị, bạn có thể xem thêm khóa học Data Science tại Cole.
Câu hỏi thường gặp về Machine Learning và Data Science
Machine Learning có khó hơn Data Science không?
Machine Learning thường khó tiếp cận hơn với người chưa có nền tảng toán học và lập trình vì cần hiểu thuật toán, cách huấn luyện và đánh giá mô hình. Tuy nhiên, Data Science cũng không đơn giản: người học phải xử lý dữ liệu không hoàn chỉnh, lựa chọn phương pháp phân tích và giải thích kết quả trong bối cảnh thực tế. Độ khó phụ thuộc vào chuyên môn mà bạn muốn theo đuổi.
Học Data Science có cần biết Machine Learning không?
Không nhất thiết phải biết Machine Learning ngay từ đầu. Bạn nên học Python, SQL, thống kê và phân tích dữ liệu trước. Khi cần giải quyết bài toán dự đoán, phân loại hoặc nhận diện quy luật phức tạp, kiến thức Machine Learning sẽ trở nên cần thiết.
Machine Learning và Data Science có cần học Python không?
Có. Python được sử dụng phổ biến trong cả hai lĩnh vực nhờ hệ sinh thái thư viện hỗ trợ xử lý dữ liệu, phân tích thống kê và xây dựng mô hình. Ngoài Python, người học Data Science nên trang bị SQL để làm việc với cơ sở dữ liệu.
Không giỏi toán có học Data Science được không?
Bạn vẫn có thể bắt đầu học Data Science nếu chưa giỏi toán. Tuy nhiên, cần từng bước bổ sung kiến thức xác suất, thống kê và đại số tuyến tính cơ bản. Điều quan trọng là hiểu cách vận dụng kiến thức vào bài toán thực tế, thay vì chỉ ghi nhớ công thức.
.jpg "Hướng dẫn Vibe Coding cho người mới tạo sản phẩm thực tế")
.jpg "Agentic Coding là gì? Cách AI Agent thay đổi lập trình hiện đại")