Khóa Học Data Engineer & Big Data 2026 – Từ Cơ bản đến Pipeline Thực Chiến

Thời lượng
63 buổi

Hình thức đào tạo
Online qua Zoom

Học phí
Liên hệ
Về khóa học Data Engineer
Vì Sao Data Engineer Là Vị Trí Được Săn Đón Hàng Đầu?
- Mức thu nhập bứt phá: Theo Báo cáo Thị trường IT của ITViec, mức lương trung bình của một Data Engineer đạt khoảng 41,3 triệu đồng/tháng và duy trì mức tăng trưởng hơn 10% mỗi năm. Tại các thị trường sôi động như Việt Nam, Singapore và Mỹ, nhu cầu tuyển dụng kỹ sư dữ liệu đang vượt xa nguồn cung.- Bài toán khan hiếm nhân lực thực chiến: Phần lớn chương trình đại học hiện nay tập trung vào lý thuyết nền tảng mà thiếu môi trường thực hành trên các hệ thống dữ liệu lớn. Doanh nghiệp luôn tìm kiếm nhân sự được đào tạo bài bản, có khả năng xử lý bài toán xuyên suốt, làm sạch và tối ưu dữ liệu thực tế ngay khi nhận việc. Đó là lý do vì sao Khóa học tại Cole trở thành lựa chọn hàng đầu của nhiều học viên muốn thăng tiến nhanh trong nghề Data Engineer. (xem phản hồi của các học viên Data Engineer).
Lộ Trình Đào Tạo 5 Giai Đoạn Chuẩn
Khóa học dẫn dắt học viên đi qua toàn bộ vòng đời phát triển của một hệ thống dữ liệu hiện đại:- Cơ sở dữ liệu & Tối ưu truy vấn (SQL Server): Nắm vững T-SQL chuyên sâu, CTE, Window Functions, thiết kế lược đồ quan hệ, phân tích Execution Plan và tối ưu Index, kiểm soát Transaction & xử lý Deadlock.
- Kho dữ liệu & Đường ống luân chuyển ETL/ELT: Thiết kế Data Warehouse chuẩn hóa và Star/Snowflake Schema, kỹ thuật Data Vault 2.0, tự động hóa luồng trích xuất dữ liệu bằng SSIS và quản lý dữ liệu biến đổi chậm (SCD).
- Lập trình Kỹ thuật Dữ liệu: Thành thạo Python, thư viện Pandas xử lý dữ liệu quy mô lớn, kiểm thử chất lượng dữ liệu tự động với Great Expectations trên môi trường Unix/Linux.
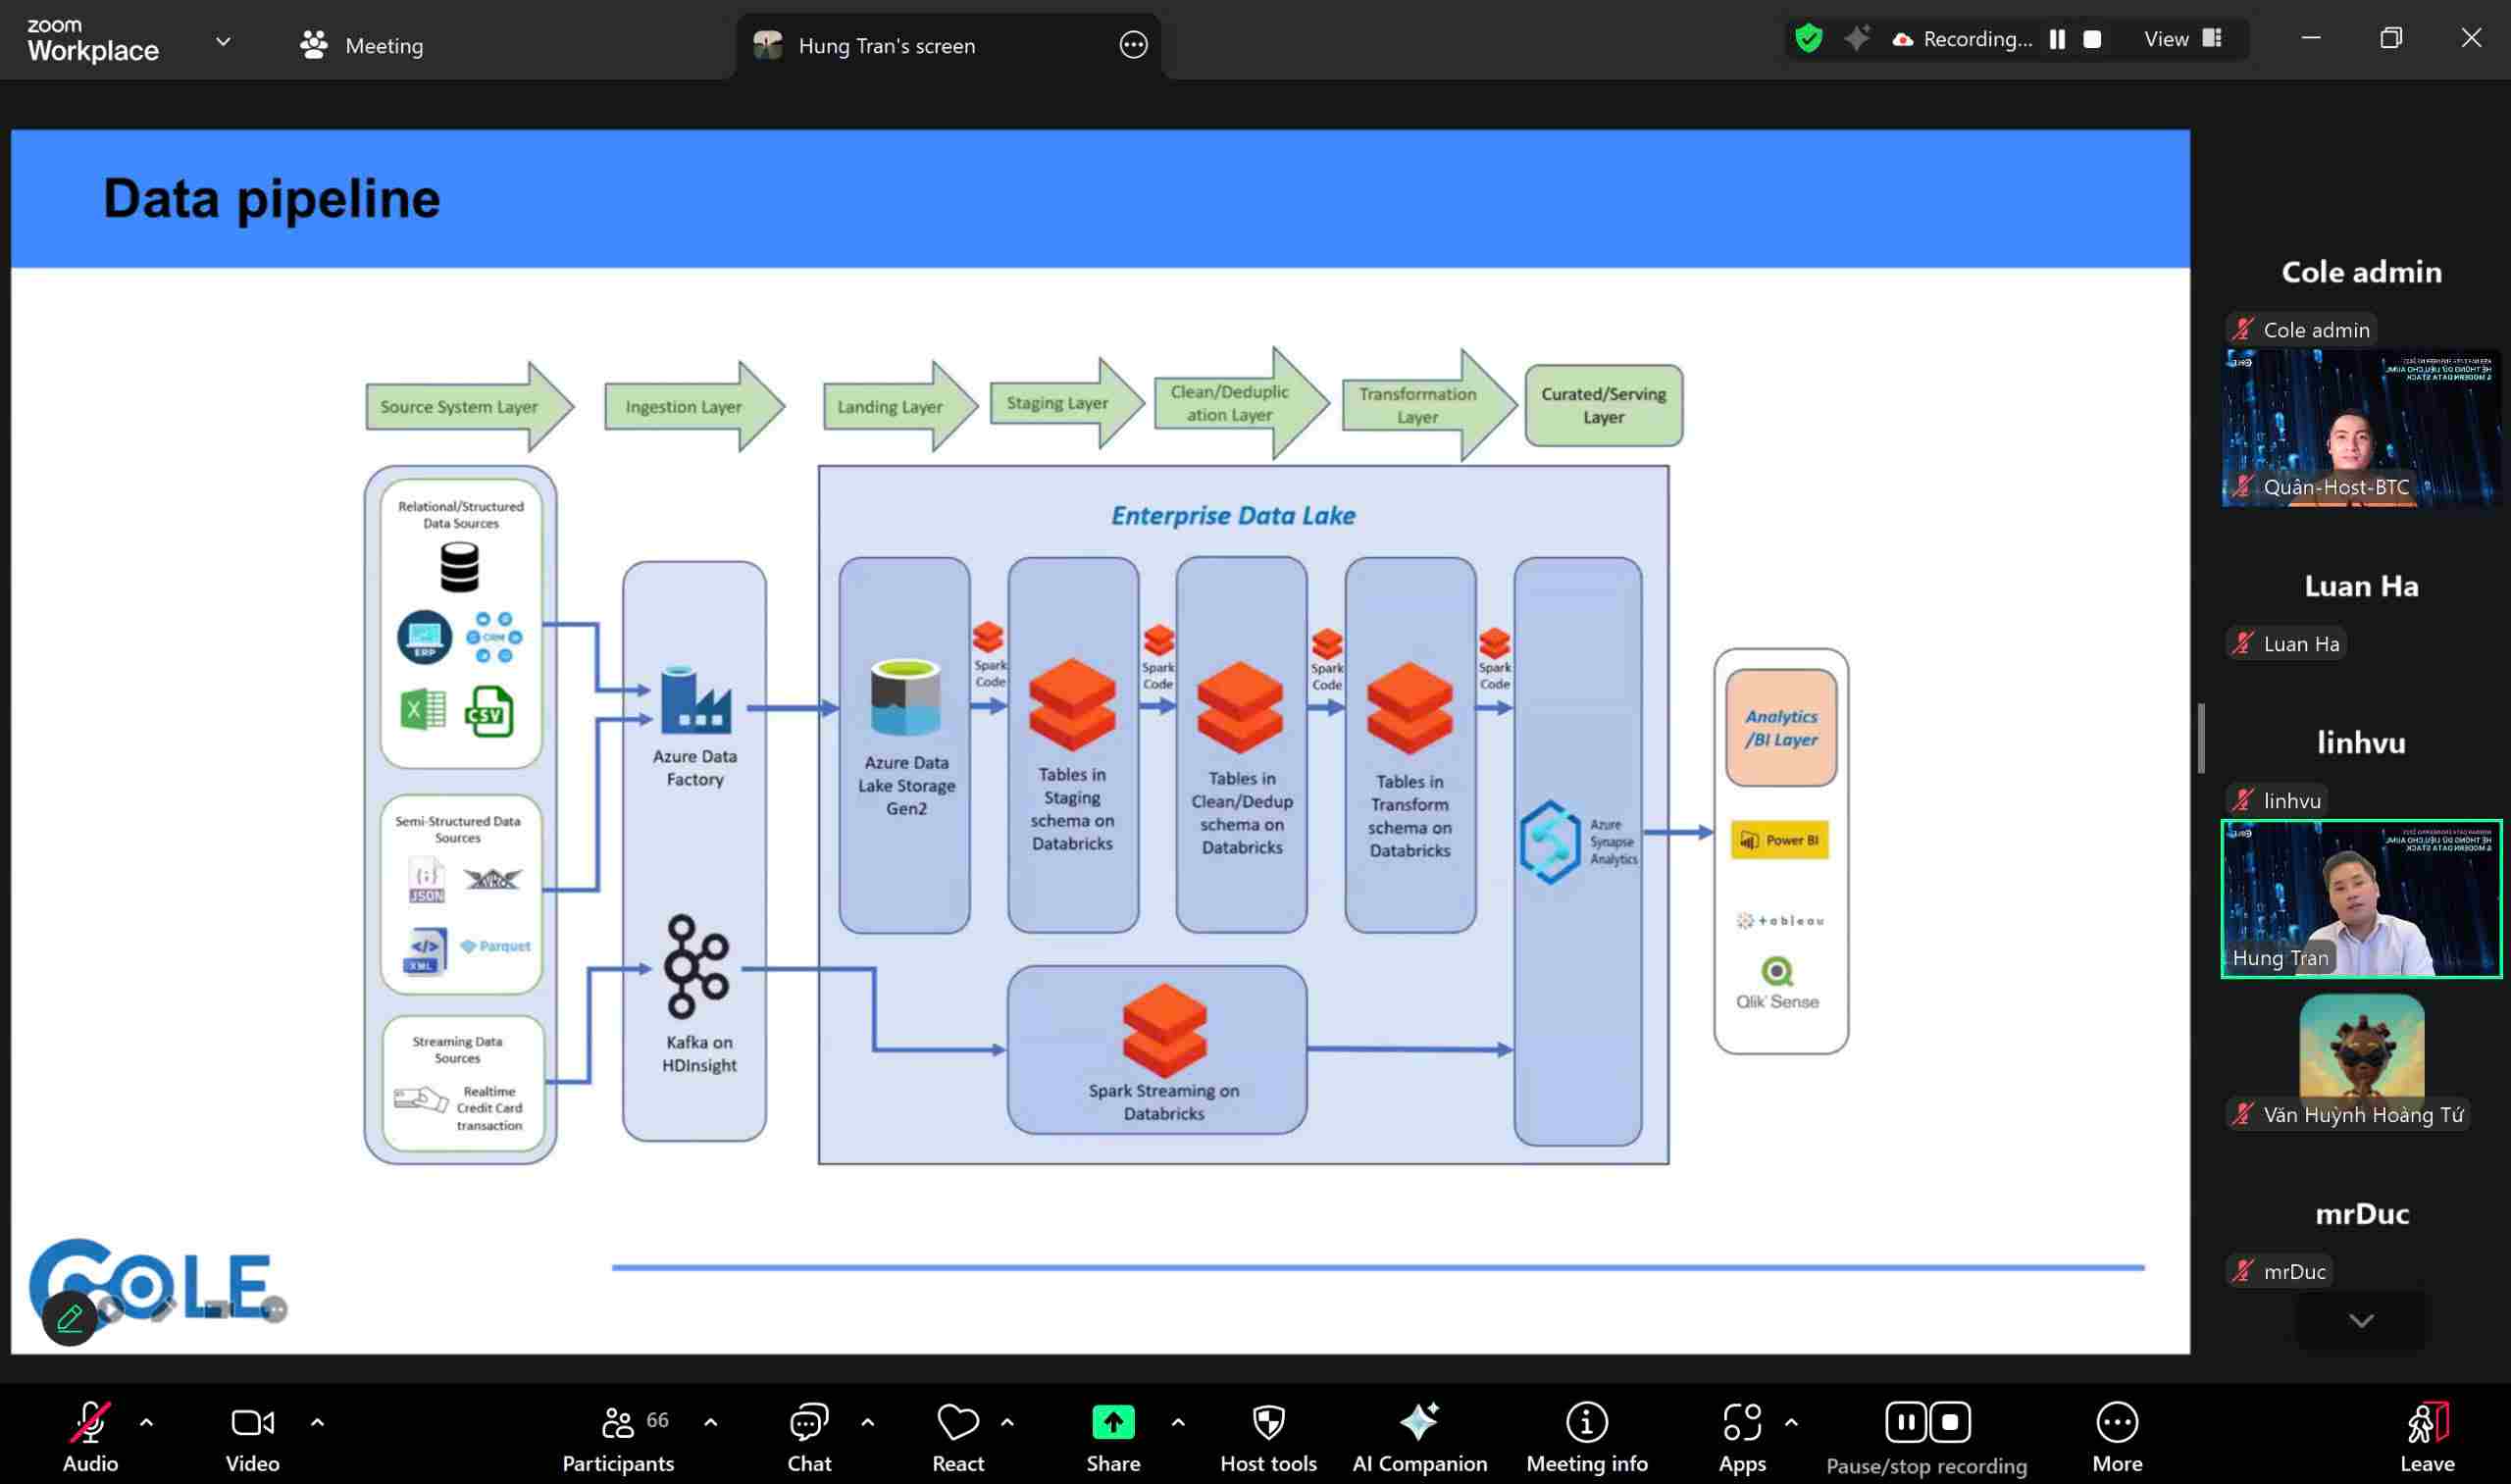
- Hệ sinh thái Big Data & Streaming thời gian thực: Triển khai hệ thống phân tán Hadoop (HDFS, Hive), làm chủ Apache Spark (PySpark, SparkSQL) và xây dựng luồng streaming dữ liệu thời gian thực với Apache Kafka & CDC.
- Điện toán đám mây & DataOps: Tự động hóa pipeline bằng Apache Airflow, triển khai hạ tầng trên AWS Cloud (S3, Glue, Athena), xây dựng mô hình Lakehouse hiện đại (Apache Iceberg, MinIO) và áp dụng CI/CD với Git & Jenkins.
Điểm Khác Biệt Tại Khóa Học Data Engineer Của Cole
- 7+ Dự án thực tế (Capstone Projects): Trải nghiệm bài toán dữ liệu lớn thực tế từ bán lẻ, logistics đến phân tích clickstream, hoàn thiện Portfolio chất lượng để chinh phục nhà tuyển dụng.- Đồng hành sát sao cùng Mentor: Học viên được giải đáp thắc mắc trực tiếp, review mã nguồn và định hướng chiến lược nghề nghiệp từ các Lead/Senior Data Engineer.
- Ứng dụng AI Agent vào Data Engineering: Cập nhật xu hướng công nghệ mới, hướng dẫn sử dụng AI để tự động hóa việc lập pipeline, tối ưu vận hành và giám sát chất lượng hệ thống.
- Tư duy quản trị dữ liệu có trách nhiệm (Data Governance): Đào tạo đạo đức làm nghề, bảo mật và an toàn thông tin – nền tảng quan trọng để phát triển bền vững lên các cấp bậc quản lý dữ liệu.
Lợi ích khóa học
Thời lượng
8 tháng - 63 buổi
Hình thức học
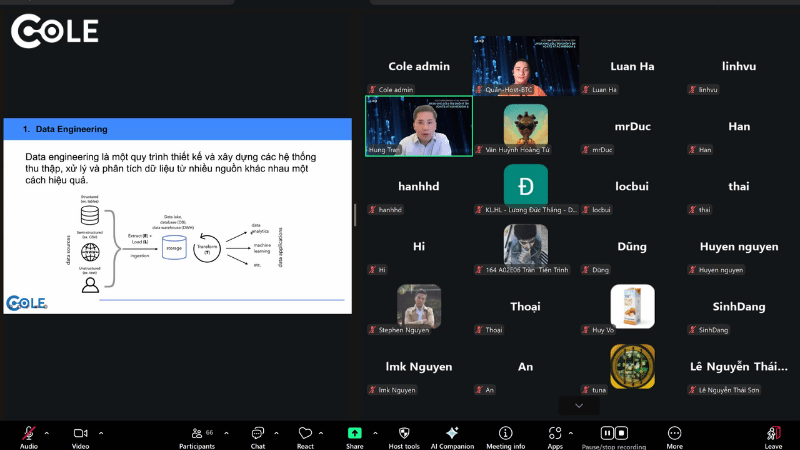
Online qua nền tảng Zoom
Lịch khai giảng
- Hàng tháng
- Thời gian học: Từ 20h- 22h
- Học 2 buổi một tuần
Công cụ
Có LMS hỗ trợ quá trình học tập, video record, slide tài liệu, bài test đánh giá năng lực và nhiều tài liệu học tập khác
Chứng nhận
Sau khóa học được cấp chứng nhận hoàn thành khóa học tại Cole.
Hỗ trợ
Hỗ trợ trọn đời sau khóa học & hệ thống học tập video record LMS
Mục tiêu học tập
Đối tượng học tập
Chuẩn đầu ra – Năng lực sau khóa học

Kiến thức & kỹ năng chuyên môn
Kiến thức & kỹ năng chuyên môn
• Hiểu rõ vai trò của Data Engineer trong hệ thống dữ liệu doanh nghiệp và môi trường Big Data.
• Thành thạo các công nghệ cốt lõi: SQL, Data Warehouse, ETL/ELT, Power BI, Cloud (AWS), Hadoop, Spark, Kafka, Airflow...
• Làm chủ toàn bộ quy trình xây dựng và vận hành hệ thống dữ liệu: từ thiết kế CSDL, xử lý dữ liệu, đến trực quan hóa và triển khai hệ thống.
• Làm quen cấu trúc đề và thực hành các chứng chỉ phổ biến: Databricks, AWS Data Analytics, Azure Data Engineer…
Thực chiến với hệ thống dự án
Thực chiến với hệ thống dự án
• Hoàn thành 7+ dự án thực tế, bao gồm: thiết kế cơ sở dữ liệu, xây dựng Data Warehouse, ETL pipeline, phân tích dữ liệu lớn, xử lý dữ liệu thời gian thực và triển khai hệ thống trên AWS, Iceberg, MinIO.
Năng lực làm việc & ứng dụng thực tế
Năng lực làm việc & ứng dụng thực tế
• Phân tích yêu cầu, thiết kế hệ thống dữ liệu và tối ưu hóa quy trình xử lý dữ liệu doanh nghiệp.
• Kỹ năng làm việc nhóm, tư duy hệ thống, tự học công nghệ mới và triển khai dự án theo mô hình Agile.
• Viết CV, luyện phỏng vấn và sẵn sàng ứng tuyển vào các vị trí Data Engineer, Big Data Engineer, BI Developer tại doanh nghiệp trong và ngoài nước.
Lộ trình học tập
- Data Warehousing
- ETL
- SQL
- Business Intelligence
- SQL Server
- Framework ETL, ELT
- AWS
- Big Data
- Cài đặt Microsoft SQL Server
- Cài đặt Tool SSMS
- Cơ sở của truy vấn - Ngôn ngữ SQL
- Các khái niệm, thành phần cơ bản trong SQL
- Các nhóm lệnh cơ bản trong SQL
- Kiểu dữ liệu trong SQL Server
- Select statement
- Select statement: Cú pháp câu điều kiện (DISTINCT, WHERE, IN, ORDER BY, AND, OR, NOT,...)
- SQL statement with aggregate functions (COUNT, SUM, AVERAGE , MIN, MAX, ..)
- Bài tập thực hành
- Truy vấn sql nâng cao với các hàm báo cáo thống kê
- GROUP BY HAVING
- ROLLUP, CUBE, PIVOT, LAG
- Constraint
- DML statement
- Bài tập thực hành
- Functioin (Hàm)
- If ... else ...
- case ... when ...
- vòng lặp while
- cursor (con trỏ) bảng tạm with cte Bài tập thực hành
- Công cụ turning, debug, tracing
- Tối ưu hóa câu lệnh SQL
- Execution plan (Kế hoạch thực thi)
- Bài tập thực hành
- bán hàng online
- book phòng khách sạn
- đặt vé sự kiện
- quản lý nhân sự...
- Tổng quan về ETL
- Transform
- Load
- SSIS
- Tổng quan trực quan hóa dữ liệu
- Xây dưng các biểu đồ
- AWS console
- IAM
- Các dịch vụ dữ liệu của AWS
- Cách tạo RDS và kết nối tới database
- Giám sát trạng thái hoạt động của server
- Backup dữ liệu định kỳ
- Bài tập thực hành
- Sử dụng công cụ aws-cli để upload/download file
- Sử dụng athena để truy vấn dữ liệu trên S3
- Bài tập thực hành
- Một số cú pháp truy vấn cơ bản
- Backup định kỳ
- Bài tập thực hành
- Data Catalogue
- Crawler
- Visual ETL
- Bài tập thực hành
- Các phép biến đổi dữ liệu thông dụng
- Bài tập thực hành
- Xây dựng pipeline để tổng hợp và khai thác dữ liệu từ nhiều nguồn
- Kéo dữ liệu từ nhiều nguồn
- Basic Programming Constructs
- Predefined Functions
- Overview of Collections - list and set
- Overview of Collections - dict and tuple
- Jupyter Notebooks and Loading Data
- Pandas vs Numpy
- Creating DataFrames
- Saving and Serialising
- Inspecting DataFrames
- Introduction and super basic plots
- Pandas vs Matplotlib
- Visualising 1D distributions
- Visualising 2D distributions
- Styling Pandas Table outputs
- Higher dimension visualisations
- Introduction, Labelling and Ordering
- Slicing and Filtering
- Removing and adding data
- Apply, map and vectorised functions
- Introduction and motivation
- Basic grouping syntax
- Intelligent imputation
- Grouping aggregation
- Introduction and basic syntax
- Different types of merging
- Helpful merging functions
- Introduction and basic MultiIndexes
- MultiIndex II - MultiIndex Strikes Back
- Stacking and Unstacking
- Pivoting
- Pivot Margins
- Data Vault 2.0 Modeling
- Getting Started
- File Management
- Directory Management
- File Permission / Access Modes
- Environment
- Printing, Email
- Pipes and Filters
- Processes Management
- Network Communication Utilities
- The vi Editor Tutorial
- What is Shells?
- Using Shell Variables
- Special Variables
- Using Shell Arrays
- Shell Basic Operators
- Shell Decision Making
- Shell Loop Types
- Shell Loop Control
- Shell Substitution
- Big Data Solutions
- Introduction
- Enviornment Setup
- HDFS Overview
- Command Reference
- MapReduce
- Streaming
- Multi-Node Cluster
- Perform a bulk data import on your EMR cluster, targeting your HBase table using the next two files in your dataset with appropriate scripts.
- Develop MapReduce code to process and analyze the downloaded files on your EMR instance.
- Use the Sqoop export command to transfer the output from each MapReduce task back to your RDS instance. Visualize the data by connecting the RDS instance to a dashboarding tool, such as Google Data Studio, Tableau, or PowerBI.
- Spark Basics and the RDD Interface.
- Running Spark on a Cluster.
- CLI (Command Line Interface) 101.
- Start Kafka
- Start a MySQL database
- Start a MySQL command line client
- Start Kafka Connect
- Workflows as code
- Why Airflow?
- Why not Airflow?
- It’s a DAG definition file
- Importing Modules
- Default Arguments
- Instantiate a DAG
- Operators
- Tasks
- Automated Testing in Big Data
- Version Control and Configuration Management
- Python and Pyspark package management
The project involves handling two data types: clickstream data and batch data.
- Clickstream Data: This real-time data, captured in Kafka, is consumed by a streaming framework, which loads it into Hadoop. Once ingested into the stream processing layer, the data is synced to an HDFS directory for further processing.
- Batch Data: This consists of bookings data stored in an RDS instance. This data needs to be ingested periodically into Hadoop for analysis and processing.
- Tổng quan về hệ thôgs
- Hệ thống chứng chỉ của DE: Sparks, DE, DA, và AI/ML
- Cách thức ôn tập và luyện thi
- Cấu trúc đề thi DE Asscociate và chi tiết các tính năng
- Tải các bộ đề, nguồn tài liệu học tập
- Giải thích các tính năng và tổng hợp lý thuyết theo cấu trúc đề thi
- Hướng dẫn đăng ký thi và update Cert
- Bắt đầu làm đề thi khoảng 80/250 câu
- Chia sẻ, hoàn thiện kết quả thi
- Trao đổi kinh nghiệm thi và kinh nghiệm làm nghề Data
Đầu ra:
- Proposal
- BRD (Business Requirement Doc)
- TRD (Technical Requirement Doc)
- Project plan
- Raw layer + DAG / Job chạy
- Staging tables / scripts
- DW schema
- Power BI
- Workflow chạy hoàn chỉnh
- Log report + alert config
- Demo + feedback + interview
| Thành phần | Option 1 (Microsoft) | Option 2 (Open-source) | Option 3 (Cloud-native) |
|---|---|---|---|
| Database / DW | SQL Server | PostgreSQL | BigQuery / Snowflake |
| ETL / ELT | SSIS | Python (pandas / PySpark) + dbt | Dataflow / Glue / Cloud Composer |
| Orchestration | SSIS Job Scheduler | Apache Airflow / Prefect | Airflow (managed cloud) |
| BI / Reporting | Power BI | Metabase / Superset | Looker / Data Studio |
| Version Control & CI/CD | Azure DevOps | GitHub Actions / GitLab CI | Cloud Build / Cloud Deploy |
| Monitoring | SQL Agent log / Power BI refresh log | Airflow UI / Prometheus | Cloud Monitoring |
Giảng viên
Data Architecture tại Tập đoàn BRG
ThS. Nguyễn Thế Anh hiện phụ trách Mảng Phần mềm & Kiến trúc doanh nghiệp (Enterprise Architecture) tại Tập đoàn đa ngành BRG, sở hữu hơn 15 năm kinh nghiệm thực chiến trong lĩnh vực chuyển đổi số và tư vấn giải pháp CNTT. Anh từng đảm nhận vai trò Kỹ sư Dữ liệu chủ chốt tại BestBuy.com (Mỹ & Malaysia) cùng bề dày triển khai các hệ thống Chính phủ điện tử trọng điểm quốc gia (Đà Nẵng, Văn phòng Chính phủ, Bộ Y tế, Bộ GTVT, Một cửa quốc gia). Với nền tảng Kỹ sư Toán - Tin từ Đại học Bách khoa Hà Nội, anh còn là chuyên gia giàu kinh nghiệm trong vai trò lãnh đạo CNTT, đào tạo nhân lực công nghệ (tại VNPT, Aptech) và dẫn dắt đội tuyển STEM Việt Nam thi đấu quốc tế.
- 15+ năm kinh nghiệm làm việc thực tế về chuyển đổi số, tham gia phát triển nhiều dự án CNTT lớn. Tham gia đánh giá, tư vấn hỗ trợ trong việc mua sắm phần mềm cho doanh nghiệp.
- Đã có kinh nghiêm làm việc chuyển đổi số trong và ngoài nước (Mỹ và Malaysia) - Tập đoàn BestBuy.Com với vai trò là key chính (kỹ sư dữ liệu).
- Đã chuyển đổi số trong nhiều lĩnh vực từ doanh nghiệp nước ngoài, chính phủ, và doanh nghiệp tư nhân
- Làm việc với nhiều vai trò khác nhau từ nhân viên, thầy giáo, tư vấn, quản trị dự án, lãnh đạo CNTT trong doanh nghiệp, chủ doanh nghiệp, làm các dự án startup.
- Đã làm các dự án phần mềm (chuyển đổi số) cho chính phủ (Chính phủ điện tử Đà Nẵng, Một cửa quốc gia, Chính phủ điện tử cho bộ Y tế, Bộ giao thông vận tải, Văn phòng chính phủ…).
- Đã đào tạo đội làm chính phủ điện tử bên VNPT , đào tạo STEM và có đưa team học sinh Việt Nam đi thi đấu tại Indonesia.
- Hiện tại phụ trách phần mềm, EA (enterprise architecture) của Tập đoàn BRG (Công ty đa ngành sở hữu ngân hàng SeaBank, Golf, Khách sạn, BDS, Dược phẩm……)
- Tốt nghiệp kỹ sư CNTT ngành ngành Toán - Tin Đại học Bách khoa Hà Nội.
- Từng làm giảng viên tại Aptech.
Senior Data Analyst - Business Inteligence tại Corp360
Senior Data Analyst - Business Inteligence tại Corp360
Principal Engineer tại IX - Công ty chuyển đổi số hàng đầu Nhật Bản
Thầy Đỗ Đình Tấn hiện đang giữ chức vụ Principal Engineer tại IX – công ty chuyển đổi số hàng đầu Nhật Bản. Thầy sở hữu 12 năm kinh nghiệm làm chuyển đổi số cho các khách hàng Nhật Bản cùng 5 năm làm việc trực tiếp tại Nhật, nổi bật với các dự án xây dựng hệ thống Data Warehouse và Big Data cho Mynavi (tập đoàn tuyển dụng lớn nhất Nhật Bản).
Data Architect at Bosch Digital
- 7+ năm kinh nghiệm xây dựng và phát triển Big Data Platform tại ACB Bank và Bosch.
- 2+ năm phát triển và vận hành quy trình tự động hóa với vai trò RPA Engineer tại FPT và Bosch.
- Chứng chỉ:
- Big Data Specialization - Đại học California, San Diego.
- BI Foundations with SQL, ETL and Data Warehousing - IBM.
Project học viên
Học viên nói gì về khóa học
Feedback học viên
Nguyễn Thùy Linh
Intern Data Engineer tại tập đoàn FPT

Ngô Thái Huy
Fresher Data Engineer tại Viettel
Thái Thùy Trang
Junior Data Engineer tại CMC
Lợi ích chỉ có tại COLE

Giới thiệu việc làm sau khóa học

Học lại free

Cộng đồng chuyển đổi số 1
Câu hỏi thường gặp
Để biết thêm thông tin chi tiết đừng ngần ngại gọi cho chúng tôi.
-
Hotline
-
Email
-
Trang tin chính thức
Hoặc để lại thông tin
COLE - Lựa chọn hàng đầu cho nhân
sự về Digital Skills

5000+
Học viên theo học

30%
Thu nhập học viên tăng lên sau khi học

30+ Khóa học
Hàng đầu về ứng dụng công nghệ

50+
Chuyên gia hàng đầu về chuyển đổi số
300+ Doanh nghiệp hàng đầu lựa chọn Cole để nâng cấp kỹ năng





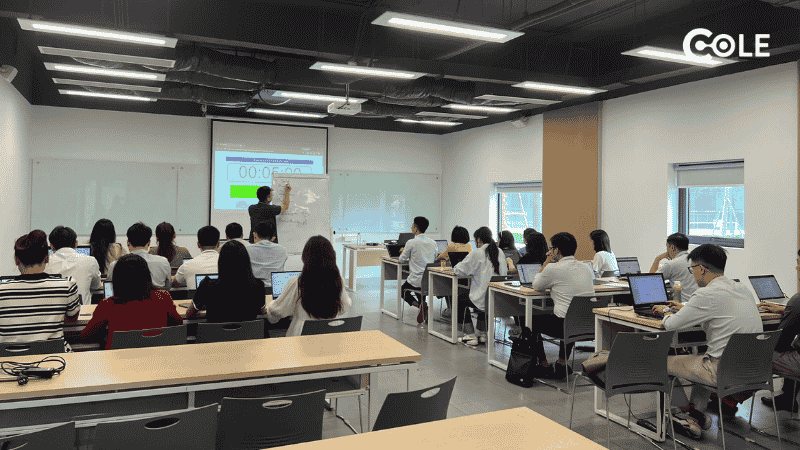
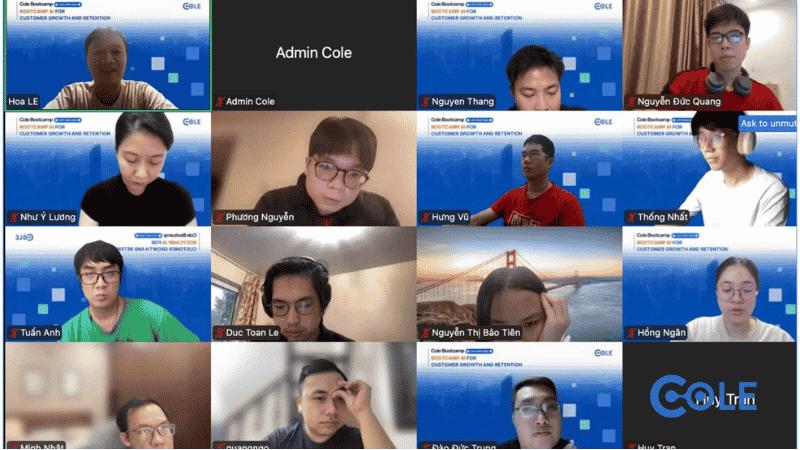
Hình ảnh lớp học