Phỏng vấn Data Engineer thường kiểm tra bốn nhóm năng lực: SQL, Python, thiết kế pipeline/Data Warehouse và khả năng xử lý sự cố thực tế. Dưới đây Cole sẽ tổng hợp 15 câu hỏi hay gặp, kèm câu trả lời mẫu, ý đồ của người phỏng vấn và câu hỏi đào sâu, từ mức cơ bản đến nâng cao.
Các câu trả lời mẫu được viết ngắn để bạn nắm ý chính. Khi phỏng vấn, hãy gắn với ví dụ từ dự án của chính bạn, vì đó là phần nhà tuyển dụng đánh giá cao nhất. Các câu hỏi phỏng vấn dưới đây chỉ dành để tham khảo và nắm được những ý chính để mình học hỏi thêm thôi, nên là bạn đọc lưu ý vấn đề này. Nếu bạn chưa nắm chắc nền tảng nghề, hãy xem trước bài Data Engineer là gì?.
1. Quy trình phỏng vấn Data Engineer thường gồm những vòng nào?
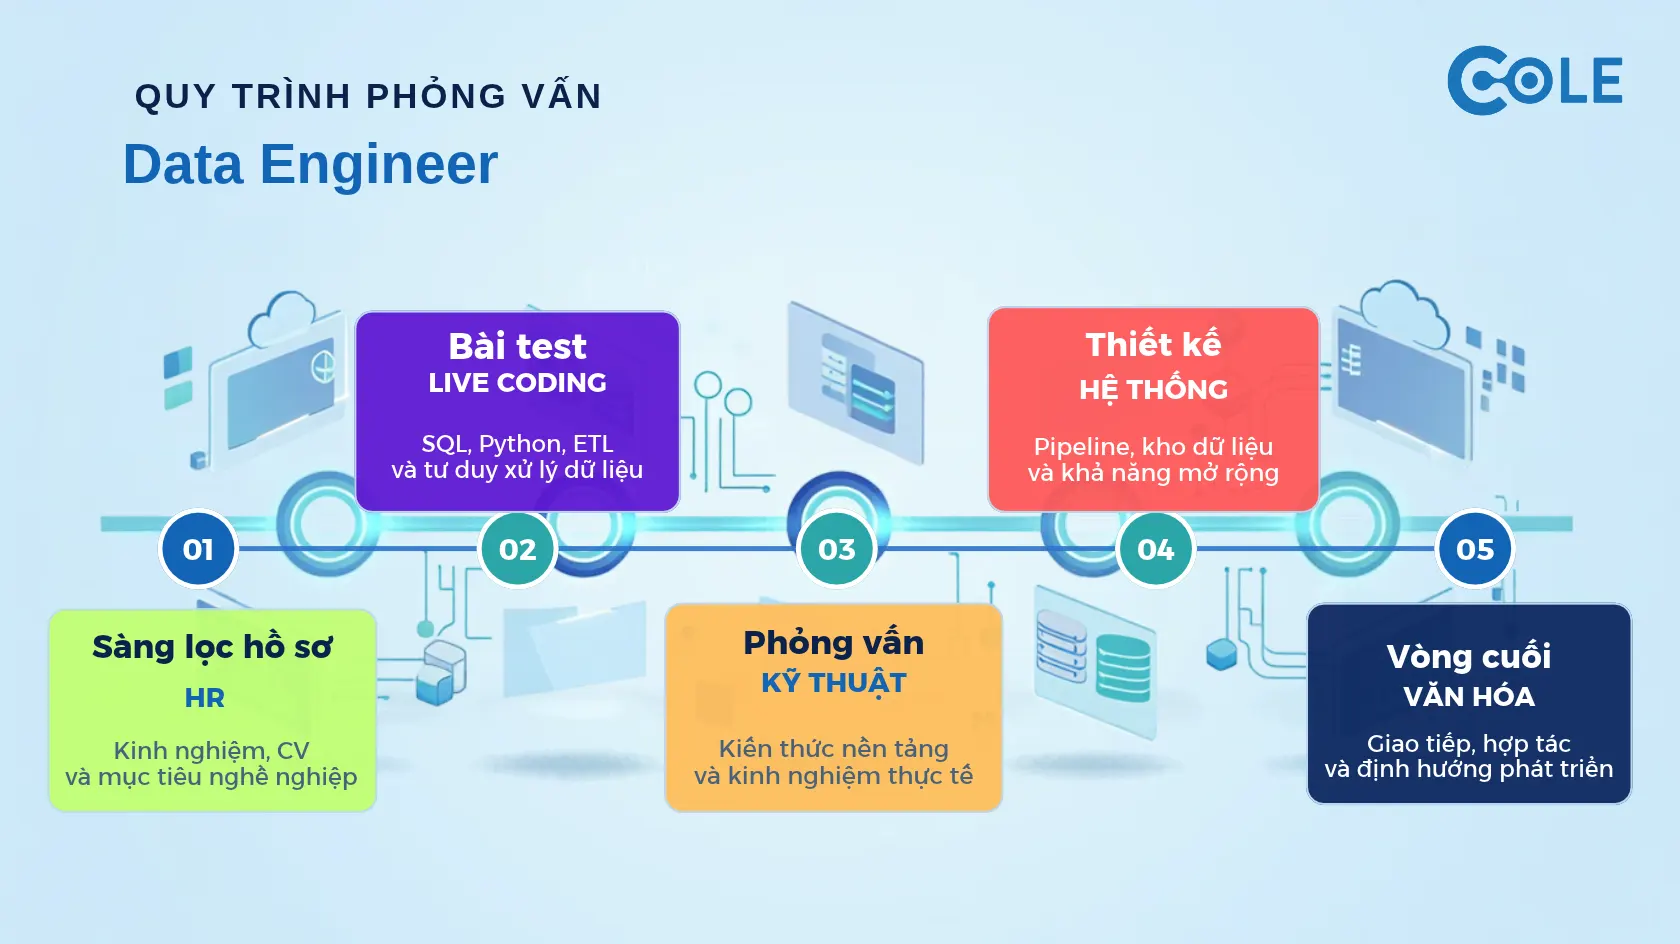
Quy trình khác nhau theo công ty, nhưng nhìn chung thì thường gồm các vòng sau:
| Vòng | Nội dung thường gặp | Điều được đánh giá |
|---|---|---|
| Sàng lọc hồ sơ / HR | Kinh nghiệm, công cụ đã dùng, kỳ vọng | Mức phù hợp cơ bản |
| Bài test hoặc live coding | SQL, Python, đôi khi bài xử lý dữ liệu | Kỹ năng nền tảng |
| Phỏng vấn kỹ thuật | ETL, Data Warehouse, Spark, cloud, dự án cũ | Chiều sâu kiến thức |
| Thiết kế hệ thống | Thiết kế pipeline cho một bài toán cụ thể | Tư duy hệ thống |
| Vòng cuối / văn hóa | Tình huống, làm việc nhóm, kỳ vọng | Mức phù hợp với đội |
Cấp độ càng cao thì tỷ trọng thiết kế hệ thống và câu hỏi tình huống càng lớn. Ví dụ Junior thường được hỏi nhiều về SQL và nền tảng hơn, tùy vào nhà tuyển dụng.
2. Câu hỏi phỏng vấn về SQL
Câu 1. Window function là gì? Khác gì với GROUP BY? (Cơ bản – trung cấp)
Trả lời mẫu: GROUP BY gộp nhiều dòng thành một dòng cho mỗi nhóm, còn window function tính toán trên một “cửa sổ” các dòng liên quan nhưng vẫn giữ nguyên từng dòng ban đầu. Nhờ đó ta có thể xếp hạng, tính tổng lũy kế hoặc so sánh với dòng trước đó mà không mất chi tiết. Ví dụ lấy 3 đơn hàng gần nhất của mỗi khách:
SELECT *
FROM (
  SELECT o.*,
         ROW_NUMBER() OVER (PARTITION BY customer_id ORDER BY order_date DESC) AS rn
  FROM orders o
) t
WHERE rn <= 3;
Người hỏi muốn kiểm tra: bạn có dùng được SQL ở mức phân tích nâng cao hay chỉ dừng ở JOIN và GROUP BY.
Câu đào sâu thường gặp: khác nhau giữa ROW_NUMBER, RANK, DENSE_RANK; dùng LAG/LEAD để tính chênh lệch giữa các kỳ.
Câu 2. Làm thế nào để tìm và loại bỏ bản ghi trùng? (Cơ bản – trung cấp)
Trả lời mẫu: Dùng GROUP BY ... HAVING COUNT(*) > 1 để phát hiện trùng. Để giữ lại một bản ghi cho mỗi khóa, đánh số thứ tự bằng ROW_NUMBER() rồi giữ dòng đầu tiên theo tiêu chí hợp lý (ví dụ bản mới nhất).
WITH ranked AS (
  SELECT *, ROW_NUMBER() OVER (PARTITION BY email ORDER BY updated_at DESC) AS rn
  FROM customers
)
SELECT * FROM ranked WHERE rn = 1;
Người hỏi muốn kiểm tra: khả năng xử lý dữ liệu bẩn, việc hằng ngày của Data Engineer. Hãy nói rõ tiêu chí chọn bản ghi giữ lại thay vì xóa tùy ý.
Câu 3. Một câu query chạy chậm, bạn tối ưu thế nào? (Trung cấp)
Trả lời mẫu: Trước hết xem kế hoạch thực thi (EXPLAIN) để biết điểm nghẽn: quét toàn bảng, JOIN lớn, sắp xếp tốn kém. Sau đó mới xử lý: lọc dữ liệu sớm nhất có thể, chỉ chọn cột cần thiết thay vì SELECT *, tạo index phù hợp (với cơ sở dữ liệu giao dịch), hoặc dùng partitioning/clustering (với warehouse như BigQuery, Snowflake) để giảm lượng dữ liệu quét.
Người hỏi muốn kiểm tra: bạn tối ưu có phương pháp (đo trước, sửa sau) hay chỉ đoán.
Câu đào sâu thường gặp: khi nào index không có tác dụng; sự khác nhau giữa tối ưu trên OLTP và trên warehouse.
3. Câu hỏi về Python và xử lý dữ liệu
Câu 4. File CSV lớn hơn RAM, bạn xử lý thế nào? (Cơ bản – trung cấp)
Trả lời mẫu: Không đọc toàn bộ file một lần. Có thể đọc theo từng khối (chunksize trong Pandas) hoặc dùng generator, chỉ đọc các cột cần thiết và khai báo kiểu dữ liệu gọn hơn. Nếu dữ liệu thật sự lớn hoặc cần xử lý song song, chuyển sang công cụ phù hợp như Spark, hoặc DuckDB/Polars cho khối lượng vừa.
Người hỏi muốn kiểm tra: bạn có ý thức về giới hạn bộ nhớ và biết chọn công cụ đúng quy mô.
Câu 5. Bạn viết code pipeline thế nào để dễ bảo trì và kiểm thử? (Trung cấp)
Trả lời mẫu: Tách logic thành các hàm nhỏ, dễ kiểm thử (đọc, biến đổi, ghi), tránh hard-code cấu hình và thông tin truy cập, dùng logging rõ ràng, viết unit test cho phần biến đổi và quản lý mã nguồn bằng Git với CI. Code pipeline cũng cần được đối xử như code sản phẩm.
Người hỏi muốn kiểm tra: bạn có tư duy kỹ sư phần mềm, không chỉ viết script chạy một lần.
4. Câu hỏi về ETL, Data Warehouse và thiết kế pipeline
Câu 6. ETL và ELT khác nhau thế nào? Khi nào dùng cái nào? (Cơ bản)
Trả lời mẫu: ETL biến đổi dữ liệu trước khi nạp vào đích, còn ELT nạp dữ liệu thô vào warehouse trước rồi biến đổi ngay bên trong (thường bằng SQL hoặc dbt). ELT phổ biến với warehouse cloud nhờ khả năng tính toán mạnh và linh hoạt. ETL vẫn phù hợp khi cần làm sạch hoặc che dữ liệu nhạy cảm trước khi lưu, hoặc khi đích không đủ sức tính toán.
Người hỏi muốn kiểm tra: hiểu bản chất, không học thuộc định nghĩa. Nên nêu ví dụ từ dự án của bạn. Xem thêm Quy trình ETL là gì?.
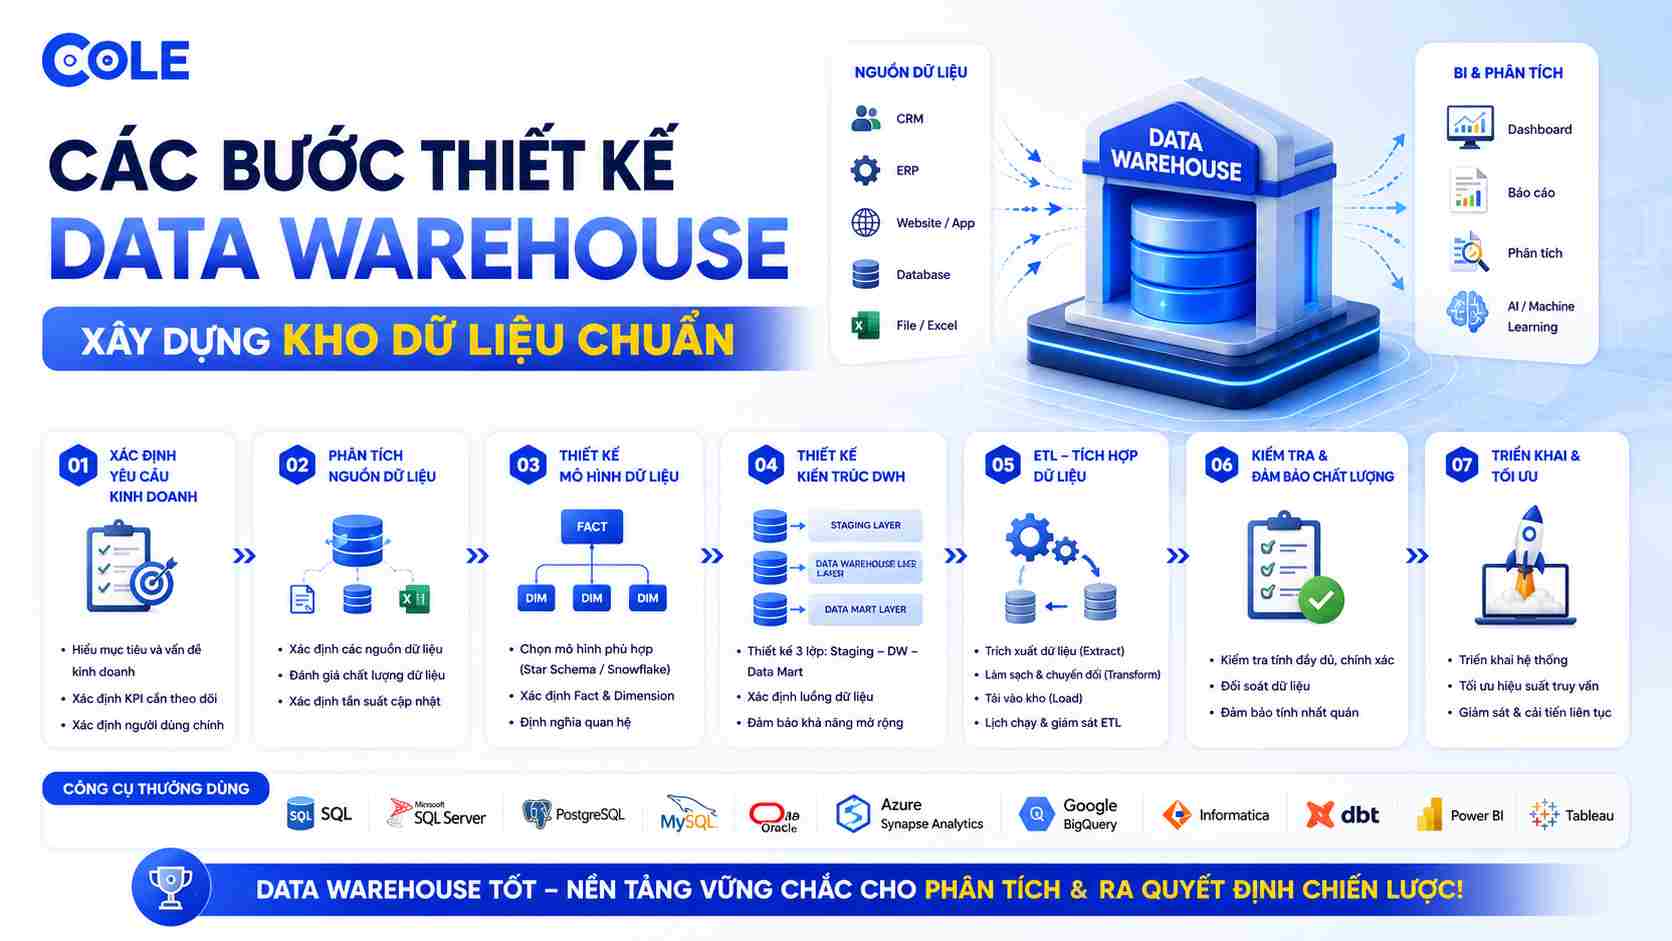
Câu 7. Star Schema là gì? Fact và Dimension khác nhau ra sao? (Cơ bản – trung cấp)
Trả lời mẫu: Star Schema gồm một bảng fact ở giữa, chứa các số đo của sự kiện (doanh thu, số lượng) và khóa ngoại, nối với các bảng dimension mô tả ngữ cảnh (khách hàng, sản phẩm, thời gian). Thiết kế này giúp truy vấn phân tích đơn giản và nhanh. Snowflake Schema chuẩn hóa thêm các dimension, tiết kiệm lưu trữ nhưng cần nhiều phép JOIN hơn.
Người hỏi muốn kiểm tra: nền tảng mô hình hóa dữ liệu. Câu đào sâu thường là “grain của bảng fact là gì?”. Xem thêm Các bước thiết kế Data Warehouse.
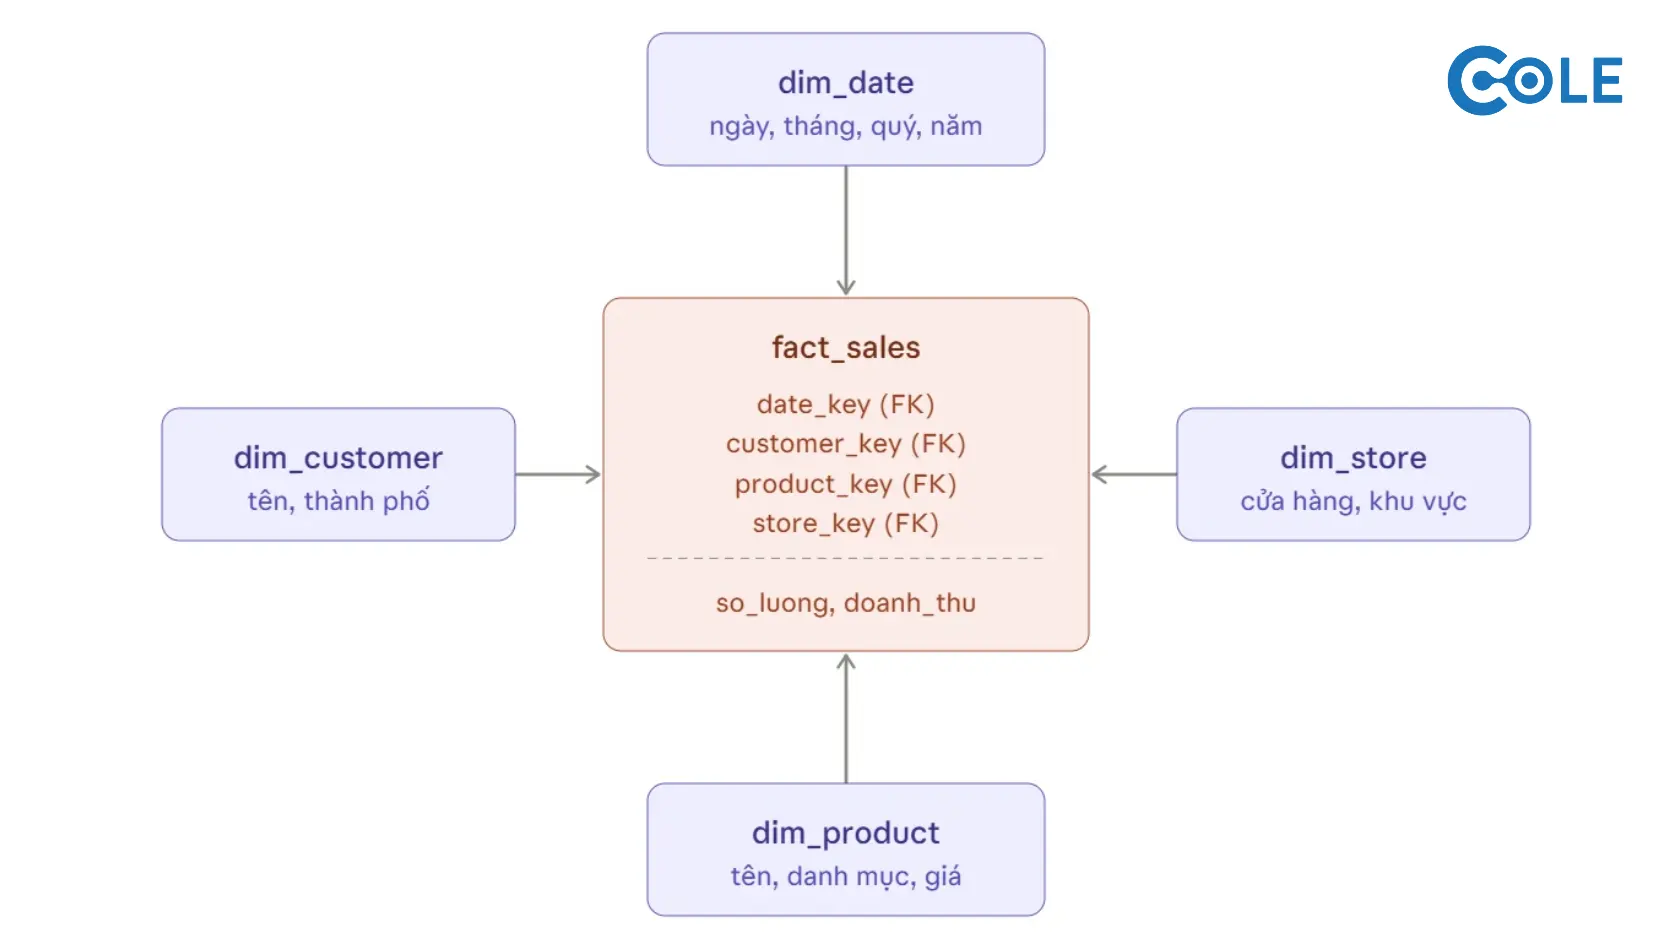
Câu 8. Slowly Changing Dimension (SCD) là gì? Bạn xử lý Type 2 thế nào? (Trung cấp – nâng cao)
Trả lời mẫu: SCD là cách xử lý khi thuộc tính của dimension thay đổi theo thời gian (ví dụ khách hàng đổi địa chỉ). Type 1 ghi đè, mất lịch sử. Type 2 giữ lịch sử bằng cách thêm một dòng mới cho mỗi thay đổi, kèm các cột như valid_from, valid_to và cờ is_current, để báo cáo quá khứ vẫn đúng theo thời điểm đó.
Người hỏi muốn kiểm tra: bạn hiểu bài toán lịch sử dữ liệu, một chủ đề rất hay hỏi ở vòng kỹ thuật.
Câu 9. Pipeline idempotent là gì? Vì sao quan trọng? (Trung cấp – nâng cao)
Trả lời mẫu: Pipeline idempotent là pipeline chạy lại nhiều lần với cùng đầu vào vẫn cho cùng kết quả, không tạo dữ liệu trùng hay sai lệch. Điều này rất quan trọng vì job lỗi và phải chạy lại (retry, backfill) là chuyện thường gặp. Cách làm phổ biến: ghi đè theo partition (ví dụ theo ngày), dùng MERGE/UPSERT theo khóa tự nhiên, và tránh append mù quáng.
Người hỏi muốn kiểm tra: kinh nghiệm vận hành thực tế. Đây là câu phân biệt khá rõ người từng chạy pipeline production với người chỉ học lý thuyết.
Câu 10. Làm sao bạn đảm bảo chất lượng dữ liệu trong pipeline? (Trung cấp)
Trả lời mẫu: Đặt các kiểm tra tự động ở những điểm then chốt: không null ở cột quan trọng, khóa duy nhất, giá trị trong khoảng hợp lệ, số dòng không biến động bất thường, dữ liệu đến đúng giờ. Công cụ có thể là test của dbt hoặc Great Expectations. Khi kiểm tra thất bại thì cảnh báo, và với lỗi nghiêm trọng nên dừng pipeline để dữ liệu sai không lan xuống báo cáo.
Người hỏi muốn kiểm tra: bạn có coi chất lượng dữ liệu là một phần của thiết kế hay chỉ sửa khi có người phàn nàn.
5. Câu hỏi về Big Data và Streaming
Câu 11. Data skew trong Spark là gì và xử lý thế nào? (Nâng cao)
Trả lời mẫu: Data skew xảy ra khi dữ liệu phân bố không đều giữa các partition, ví dụ một khóa chiếm phần lớn bản ghi, khiến một vài task chạy rất lâu trong khi các task khác đã xong. Cách xử lý thường gặp: dùng broadcast join khi một bên đủ nhỏ, thêm “muối” (salting) vào khóa bị lệch, tăng hoặc điều chỉnh số partition, và bật Adaptive Query Execution nếu phiên bản Spark hỗ trợ.
Người hỏi muốn kiểm tra: bạn đã từng gỡ lỗi hiệu năng Spark thật. Nên liên hệ với một job chậm mà bạn từng gặp.
Câu đào sâu thường gặp: shuffle là gì và vì sao tốn kém; khác nhau giữa narrow và wide transformation.
Câu 12. Khi nào dùng batch, khi nào dùng streaming? Kafka đóng vai trò gì? (Trung cấp – nâng cao)
Trả lời mẫu: Batch phù hợp khi độ trễ vài giờ hoặc một ngày là chấp nhận được (báo cáo định kỳ), đơn giản và rẻ hơn. Streaming dùng khi cần phản ứng gần realtime (phát hiện gian lận, theo dõi đơn hàng). Kafka là nền tảng truyền sự kiện: producer ghi vào topic, dữ liệu được chia thành partition và consumer đọc theo offset, giúp tách rời bên gửi và bên nhận. Cần nói rõ thêm về cách đảm bảo không mất hoặc không trùng dữ liệu (at-least-once, exactly-once) vì streaming thường phức tạp hơn batch nhiều.
Người hỏi muốn kiểm tra: bạn chọn kiến trúc theo yêu cầu kinh doanh chứ không chạy theo công nghệ.
6. Câu hỏi tình huống và thiết kế hệ thống
Câu 13. Thiết kế pipeline đưa dữ liệu đơn hàng từ MySQL về warehouse để làm báo cáo hằng ngày (Nâng cao)
Trả lời mẫu: Làm rõ yêu cầu trước: khối lượng dữ liệu, độ trễ chấp nhận, ai dùng báo cáo. Sau đó đề xuất: lấy dữ liệu tăng dần (incremental theo updated_at) hoặc CDC nếu cần bắt cả thay đổi và xóa, nạp vào khu vực staging, biến đổi và nạp vào các bảng fact/dimension, điều phối bằng Airflow, và cuối cùng đặt kiểm tra chất lượng, cảnh báo, cơ chế retry và backfill.
Người hỏi muốn kiểm tra: cách bạn tiếp cận bài toán mở: hỏi yêu cầu, nêu đánh đổi (trade-off), nghĩ tới vận hành. Câu trả lời “đúng tuyệt đối” không tồn tại, quá trình lập luận mới là điều được chấm.
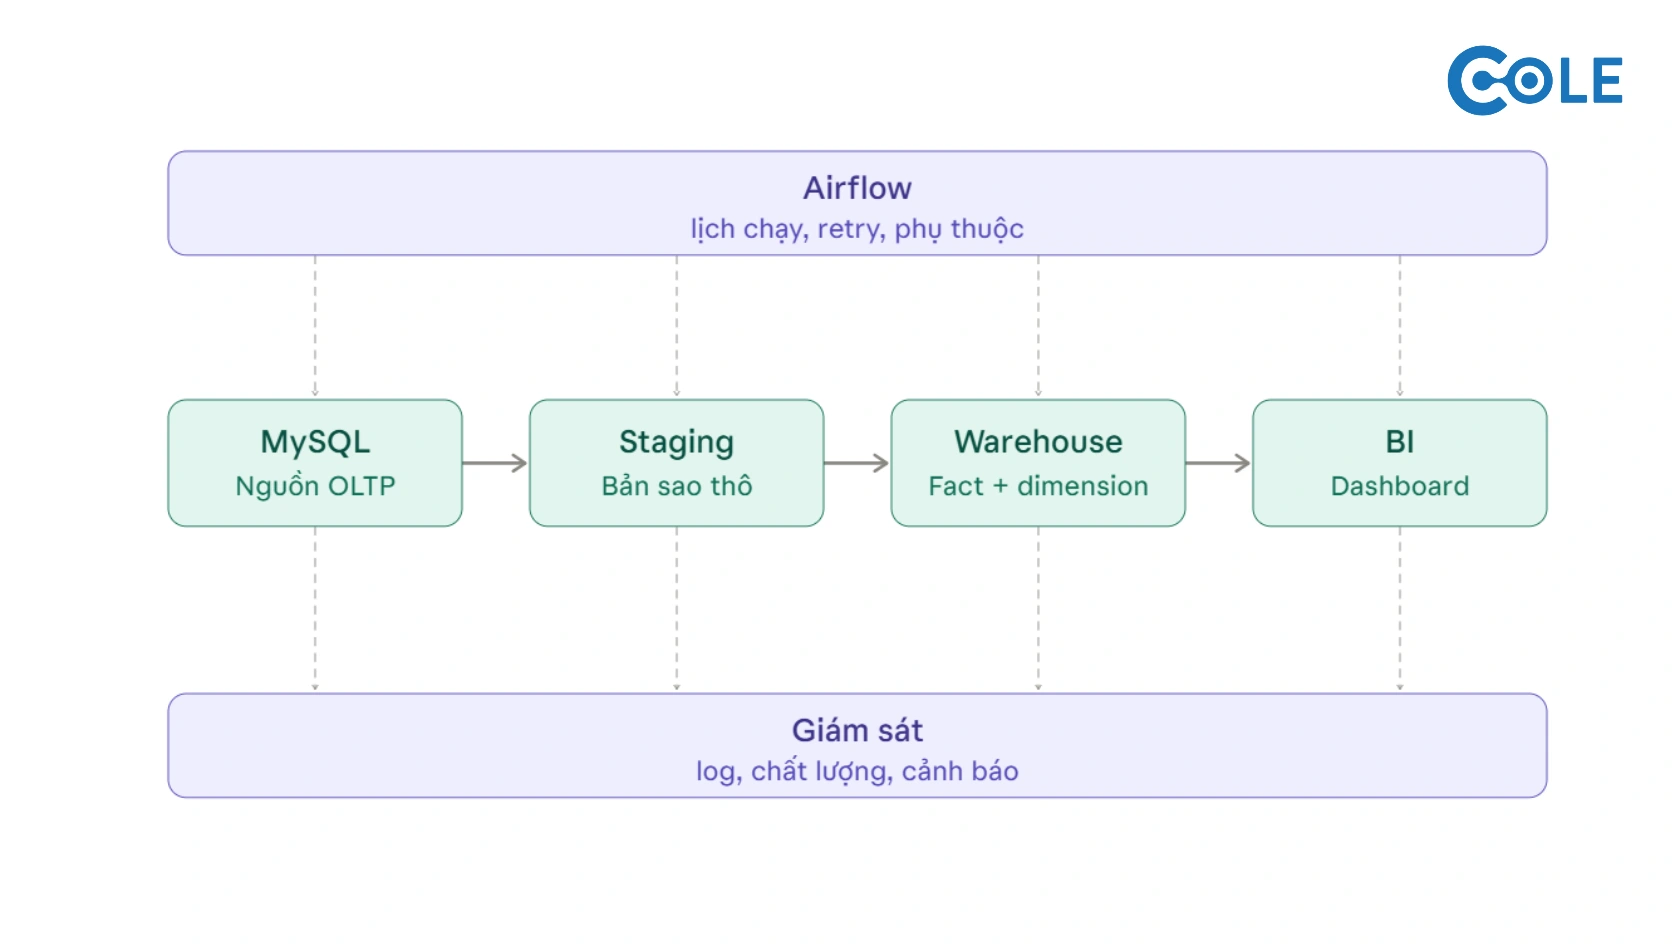
Câu 14. Sáng nay dashboard hiển thị doanh thu sai, bạn xử lý thế nào? (Trung cấp – nâng cao)
Trả lời mẫu: Thông báo sớm cho người dùng biết số liệu đang được kiểm tra để tránh quyết định dựa trên số sai. Sau đó truy vết ngược theo luồng: kiểm tra bảng báo cáo, bảng trung gian, rồi dữ liệu nguồn; xem job đêm qua có lỗi, trễ, hay chạy trùng không; xác định nguyên nhân gốc và sửa dữ liệu. Cuối cùng bổ sung kiểm tra tự động và cảnh báo để lỗi tương tự bị bắt sớm lần sau, và viết lại bài học (post-mortem) ngắn gọn.
Người hỏi muốn kiểm tra: khả năng giữ bình tĩnh, truy vết có hệ thống và giao tiếp với stakeholder, không chỉ kỹ năng sửa lỗi.
7. Câu hỏi hành vi (behavioral)
Câu 15. Kể về một lần pipeline bạn phụ trách gặp sự cố nghiêm trọng (Mọi cấp độ)
Cách trả lời: Dùng khung STAR: Situation (bối cảnh), Task (nhiệm vụ của bạn), Action (bạn đã làm gì, cụ thể), Result (kết quả và điều học được). Hãy trả lời bằng chuyện thật, có số liệu nếu có (thời gian khôi phục, mức ảnh hưởng), và nhấn mạnh phần bạn đã làm để ngăn lỗi lặp lại.
Người hỏi muốn kiểm tra: trách nhiệm, tư duy học hỏi từ sai sót và khả năng kể chuyện kỹ thuật rõ ràng. Nếu chưa có kinh nghiệm đi làm, bạn có thể dùng một sự cố trong dự án cá nhân hoặc dự án học tập.
Các câu hành vi khác hay gặp: bất đồng với đồng nghiệp hoặc stakeholder về yêu cầu dữ liệu; làm việc với deadline gấp; giải thích một vấn đề kỹ thuật cho người không chuyên.
8. Cách chuẩn bị và những lỗi nên tránh
Cách chuẩn bị hiệu quả
Củng cố SQL đến mức tự tin: luyện window function, CTE, JOIN phức tạp và tối ưu query trên bài tập thực tế.
Chuẩn bị kỹ 1–2 dự án của bản thân: vẽ lại sơ đồ pipeline, giải thích lý do chọn công cụ, các vấn đề đã gặp và cách xử lý. Phần lớn câu hỏi đào sâu sẽ xoay quanh đây.
Luyện thiết kế hệ thống nói thành lời: tập trình bày một pipeline từ yêu cầu đến vận hành trong 10–15 phút.
Nắm nền tảng cloud bạn ghi trong CV: đã ghi AWS/GCP/Azure thì phải trả lời được các dịch vụ dữ liệu cốt lõi.
Tìm hiểu công ty: họ dùng stack nào, dữ liệu thuộc lĩnh vực gì, để liên hệ câu trả lời.
Lỗi thường gặp
Liệt kê nhiều công cụ nhưng không giải thích được vì sao chọn và đánh đổi là gì.
Trả lời định nghĩa thuần túy, thiếu ví dụ thực tế.
Nhảy vào thiết kế ngay mà không hỏi lại yêu cầu bài toán.
Bỏ qua vận hành: giám sát, cảnh báo, retry, chi phí.
Ghi trong CV những công cụ chỉ mới nghe tên.
Nếu cần một lộ trình ôn luyện theo từng giai đoạn từ SQL đến Cloud, bạn có thể tham khảo Lộ trình Data Engineer thực chiến.
9. Câu hỏi thường gặp
Phỏng vấn Data Engineer có bắt buộc làm bài test code không?
Không bắt buộc, nhưng khá phổ biến. Nhiều công ty dùng bài test SQL và Python (đôi khi kèm bài xử lý dữ liệu nhỏ) để sàng lọc trước vòng phỏng vấn kỹ thuật. Hãy hỏi HR về hình thức bài test để chuẩn bị đúng.
Junior Data Engineer cần chuẩn bị gì nhất?
SQL vững, Python cơ bản đến trung cấp, hiểu ETL/ELT và mô hình hóa dữ liệu, cộng với ít nhất một dự án cá nhân có thể trình bày đầu đến cuối. Junior thường ít bị hỏi thiết kế hệ thống phức tạp nhưng được đánh giá cao nếu hiểu bản chất.
Không có kinh nghiệm làm việc thì nói gì khi được hỏi về sự cố thực tế?
Bạn có thể dùng dự án cá nhân hoặc dự án học tập: nêu vấn đề bạn đã gặp (dữ liệu trùng, job chạy chậm, lỗi schema), cách bạn tìm nguyên nhân và cách khắc phục. Điều quan trọng là trung thực và cho thấy cách suy nghĩ.
Có cần học thuộc đáp án mẫu không?
Không nên. Người phỏng vấn thường hỏi đào sâu từ câu trả lời của bạn, và câu trả lời học thuộc dễ bị lộ. Hãy hiểu bản chất và gắn với ví dụ riêng.
Về tác giả và tham vấn chuyên môn
Bài viết do đội ngũ nội dung Cole biên soạn, tham vấn chuyên môn bởi giảng viên Đỗ Đình Tấn - Giảng viên chính khóa học Data Engineer tại Cole, có nhiều năm kinh nghiệp làm việc thực tế tại nhiều dự án trong và ngoài nước.
Nội dung được rà soát định kỳ; lần cập nhật gần nhất: 10/11/2026
.jpg "Đào tạo Data cho doanh nghiệp: Làm chủ dữ liệu, tối ưu vận hành")