Theo nghiên cứu “Unlocking Vietnam’s AI Potential” của Amazon Web Services (AWS) và Strand Partners, mức độ ứng dụng AI tại Việt Nam đang tăng nhanh: 18% doanh nghiệp đã ứng dụng AI, tương đương gần 170.000 doanh nghiệp, tăng từ 13% của năm trước. Tuy nhiên, 74% doanh nghiệp đang ứng dụng AI mới tập trung vào các trường hợp sử dụng cơ bản, trong khi chỉ 9% đã đạt mức tích hợp AI mang tính chuyển đổi. Đáng chú ý, 55% doanh nghiệp cho biết thiếu nhân sự có kỹ năng là rào cản chính khi muốn mở rộng ứng dụng AI.
Điều này cho thấy bài toán của doanh nghiệp không còn đơn giản là “có nên ứng dụng AI hay không?”, mà là đội ngũ đã có đủ năng lực dữ liệu và công nghệ để đưa AI, BI và Analytics vào vận hành hay chưa.
Doanh nghiệp đang đối mặt với bài toán dữ liệu nào?
Dữ liệu doanh nghiệp hiện không chỉ đến từ một hệ thống.
Một doanh nghiệp có thể đồng thời sở hữu:
Website và ứng dụng.
CRM.
ERP.
Phần mềm bán hàng.
Hệ thống kho và logistics.
Database nội bộ.
Dữ liệu marketing.
Dữ liệu khách hàng.
Dữ liệu từ thiết bị hoặc hệ thống IoT.
Khi các nguồn dữ liệu phát triển độc lập, doanh nghiệp dễ xuất hiện những vấn đề quen thuộc:
Dữ liệu nằm ở nhiều hệ thống → khó kết nối → xử lý thủ công → báo cáo chậm → khó kiểm soát chất lượng → khó mở rộng sang Analytics và AI.
Quy mô dữ liệu cũng đang tăng rất nhanh. Theo IDC, trong năm 2025, các doanh nghiệp trên toàn cầu tạo ra khoảng 6,9 petabyte dữ liệu mỗi giây; đến năm 2029, con số này được dự báo tăng lên 17,1 petabyte/giây, tương đương khoảng 2,5 lần.
Vì vậy, vấn đề không chỉ là doanh nghiệp có bao nhiêu dữ liệu, mà là:
Doanh nghiệp có khả năng biến lượng dữ liệu đó thành dữ liệu có thể sử dụng hay không?
Đây chính là bài toán của Data Engineering.
5 dấu hiệu doanh nghiệp nên phát triển năng lực Data Engineering
Không phải doanh nghiệp nào cũng cần triển khai ngay Hadoop, Kafka hay Lakehouse. Data Engineering chỉ thực sự cần thiết khi doanh nghiệp bắt đầu gặp những vấn đề về quy mô, kết nối, chất lượng và khả năng vận hành dữ liệu.
Thay vì nhìn vào danh sách công nghệ cần học, doanh nghiệp nên bắt đầu từ một câu hỏi đơn giản: Dữ liệu hiện tại đang gây ra điểm nghẽn nào trong hoạt động?
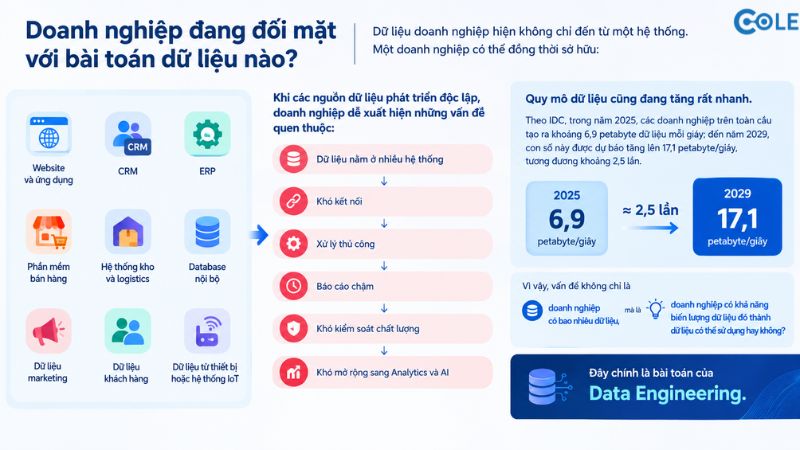
1. Dữ liệu nằm ở nhiều hệ thống và chưa được kết nối
CRM, ERP, phần mềm bán hàng, Excel, Database hay các hệ thống nội bộ có thể đều chứa dữ liệu quan trọng nhưng lại hoạt động tương đối độc lập. Khi cần lập báo cáo, nhân sự phải lấy dữ liệu từ nhiều nguồn, ghép lại và xử lý thủ công.
Đây là lúc Data Engineering đóng vai trò kết nối các nguồn dữ liệu, xây dựng Data Integration và Data Pipeline để dữ liệu có thể được thu thập, biến đổi và đưa về một hệ thống thống nhất.
Doanh nghiệp nhận được gì? Thay vì mỗi phòng ban tự tổng hợp dữ liệu theo cách riêng, doanh nghiệp có một dòng dữ liệu được kết nối và vận hành có hệ thống, tạo nền tảng cho báo cáo, BI và các bài toán phân tích phía sau.
2. Báo cáo vẫn phụ thuộc vào Excel và thao tác thủ công
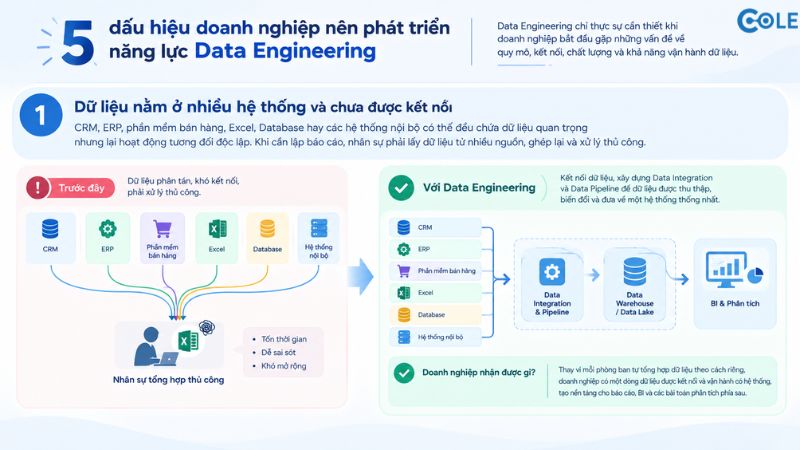
Nếu mỗi kỳ báo cáo đều phải xuất file, làm sạch dữ liệu, ghép nhiều bảng, kiểm tra lỗi rồi thực hiện lại hàng loạt bước bằng tay, doanh nghiệp không chỉ tốn thời gian mà còn khó mở rộng khi dữ liệu ngày càng lớn.
Data Engineering giúp chuyển những quy trình lặp lại thành các Pipeline tự động thông qua ETL/ELT và Workflow Automation. Dữ liệu có thể được lấy từ nguồn, xử lý theo quy tắc đã thiết lập và đưa đến hệ thống đích mà không cần thực hiện lại toàn bộ quy trình thủ công.
Doanh nghiệp nhận được gì? Giảm phụ thuộc vào thao tác thủ công, hạn chế lỗi trong quá trình tổng hợp và quan trọng hơn là biến quy trình báo cáo từ “làm lại mỗi lần” thành một quy trình có thể vận hành và mở rộng.
3. Database tăng nhanh nhưng hiệu năng ngày càng giảm
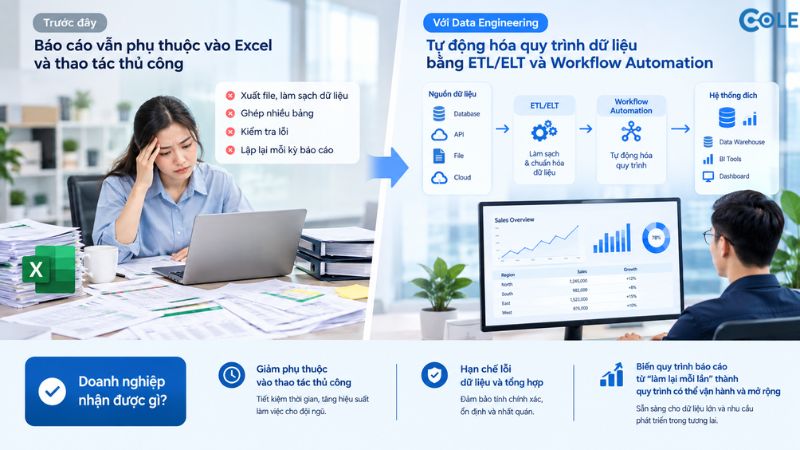
Khi lượng dữ liệu và số lượng người sử dụng tăng lên, những truy vấn từng chạy nhanh có thể bắt đầu chậm. Báo cáo mất nhiều thời gian hơn, hệ thống cần tối ưu liên tục và các truy vấn phức tạp có thể ảnh hưởng đến hiệu năng chung.
Lúc này, Data Engineering không chỉ là xây thêm hệ thống mà còn phải tổ chức và tối ưu cách dữ liệu được lưu trữ, truy vấn và khai thác.
Nhân sự cần hiểu Database Design, SQL Optimization, Index, Execution Plan, Query Performance và các phương pháp xử lý dữ liệu phù hợp với quy mô hệ thống.
Doanh nghiệp nhận được gì? Hệ thống dữ liệu có khả năng đáp ứng tốt hơn khi dữ liệu tăng, giảm các điểm nghẽn về truy vấn và tạo nền tảng ổn định hơn cho các ứng dụng, báo cáo và hệ thống phân tích.
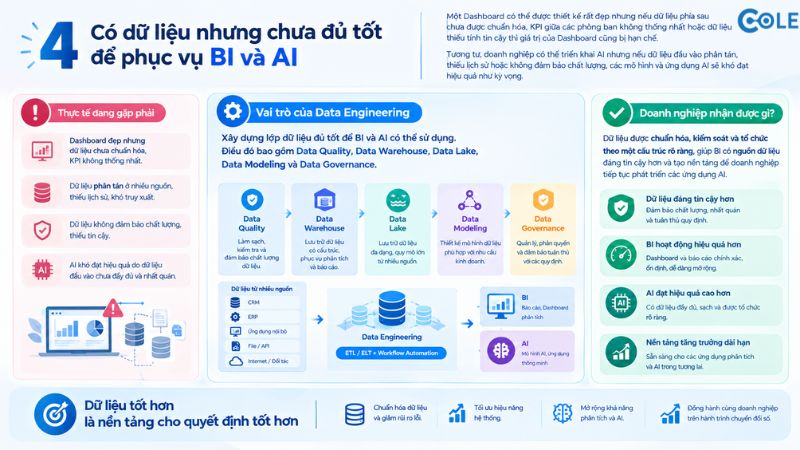
4. Có dữ liệu nhưng chưa đủ tốt để phục vụ BI và AI
Một Dashboard có thể được thiết kế rất đẹp nhưng nếu dữ liệu phía sau chưa được chuẩn hóa, KPI giữa các phòng ban không thống nhất hoặc dữ liệu thiếu tính tin cậy thì giá trị của Dashboard cũng bị hạn chế.
Tương tự, doanh nghiệp có thể triển khai AI nhưng nếu dữ liệu đầu vào phân tán, thiếu lịch sử hoặc không đảm bảo chất lượng, các mô hình và ứng dụng AI sẽ khó đạt hiệu quả như kỳ vọng.
Vai trò của Data Engineering lúc này là xây dựng lớp dữ liệu đủ tốt để BI và AI có thể sử dụng. Điều đó bao gồm Data Quality, Data Warehouse, Data Lake, Data Modeling và Data Governance.
Doanh nghiệp nhận được gì? Dữ liệu được chuẩn hóa, kiểm soát và tổ chức theo một cấu trúc rõ ràng, giúp BI có nguồn dữ liệu đáng tin cậy hơn và tạo nền tảng để doanh nghiệp tiếp tục phát triển các ứng dụng AI.
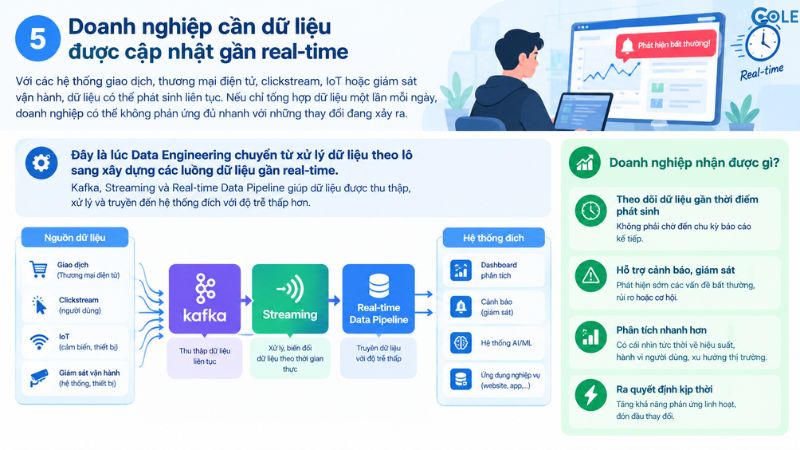
5. Doanh nghiệp cần dữ liệu được cập nhật gần real-time
Với các hệ thống giao dịch, thương mại điện tử, clickstream, IoT hoặc giám sát vận hành, dữ liệu có thể phát sinh liên tục. Nếu chỉ tổng hợp dữ liệu một lần mỗi ngày, doanh nghiệp có thể không phản ứng đủ nhanh với những thay đổi đang xảy ra.
Đây là lúc Data Engineering chuyển từ xử lý dữ liệu theo lô sang xây dựng các luồng dữ liệu gần real-time.
Kafka, Streaming và Real-time Data Pipeline giúp dữ liệu được thu thập, xử lý và truyền đến hệ thống đích với độ trễ thấp hơn.
Doanh nghiệp nhận được gì? Doanh nghiệp có thể theo dõi dữ liệu gần với thời điểm phát sinh, hỗ trợ cảnh báo, giám sát, phân tích và ra quyết định nhanh hơn thay vì phải chờ đến chu kỳ báo cáo tiếp theo.
Data Engineering thực chất giải quyết bài toán gì cho doanh nghiệp?
Nhìn riêng từng công nghệ, Data Engineering có thể bao gồm rất nhiều thành phần: SQL, Database, ETL/ELT, Data Warehouse, Data Lake, Cloud, Big Data, Streaming, Airflow, Data Quality...
Nhưng mục tiêu cuối cùng không phải là để doanh nghiệp “có thêm một loạt công nghệ”.
Mục tiêu là xây dựng một dòng chảy dữ liệu có thể vận hành ổn định:
Dữ liệu phát sinh → Thu thập → Tích hợp → Xử lý → Lưu trữ → Kiểm soát chất lượng → Phục vụ BI/AI → Hỗ trợ ra quyết định
Khi nhìn theo cách này, doanh nghiệp sẽ dễ xác định mình đang thiếu mắt xích nào và nên đào tạo Data Engineering ở mức nào, thay vì học dàn trải tất cả công nghệ.
Doanh nghiệp cần Data Engineer để giải quyết vấn đề gì?
Một chương trình đào tạo không nên bắt đầu bằng câu hỏi:
“Nhân sự sẽ học SQL, Spark hay Kafka trong bao nhiêu buổi?”
Câu hỏi quan trọng hơn là:
“Sau đào tạo, đội ngũ có thể giải quyết bài toán dữ liệu nào của doanh nghiệp?”
| Bài toán | Hệ quả | Năng lực cần phát triển |
|---|---|---|
| Dữ liệu nằm ở nhiều hệ thống | Khó tạo một nguồn dữ liệu thống nhất | Data Integration |
| Báo cáo xử lý thủ công | Tốn thời gian, khó mở rộng | ETL/ELT |
| Database ngày càng lớn | Truy vấn và xử lý chậm | SQL & Database Optimization |
| Dữ liệu không đồng nhất | Báo cáo thiếu nhất quán | Data Quality |
| Cần dữ liệu tập trung | Khó phân tích đa nguồn | Data Warehouse |
| Cần phân tích theo nhiều chiều | Khó phục vụ BI | Data Modeling & OLAP |
| Dữ liệu phát sinh liên tục | Batch không đáp ứng | Kafka & Streaming |
| Khối lượng dữ liệu lớn | Công cụ truyền thống khó mở rộng | Hadoop & Spark |
| Pipeline chạy thủ công | Phụ thuộc nhân sự | Airflow |
| Hạ tầng cần mở rộng | Khó đáp ứng tốc độ tăng trưởng | Cloud Data Engineering |
| Batch và Real-time cùng tồn tại | Kiến trúc dữ liệu phức tạp | Data Lake/Lakehouse |
| Hệ thống cần triển khai ổn định | Khó kiểm soát thay đổi | DataOps & CI/CD |
Đây cũng là lý do không nên áp dụng một giáo trình Data Engineer giống nhau cho mọi doanh nghiệp.
Nội dung đào tạo cần được lựa chọn dựa trên nguồn dữ liệu, hệ thống hiện tại, năng lực đội ngũ và mục tiêu kinh doanh.
Đào tạo Data Engineer cho doanh nghiệp cần tập trung vào 5 nhóm năng lực
Thay vì bắt đầu bằng danh sách công nghệ, chương trình đào tạo Data Engineer cho doanh nghiệp nên được xây dựng theo 5 lớp năng lực, đi từ nền tảng dữ liệu đến xây dựng hệ thống, xử lý dữ liệu lớn và vận hành Data Platform.
1. Xây dựng nền tảng dữ liệu
Năng lực đầu tiên là khả năng thiết kế, tổ chức và khai thác dữ liệu ở tầng Database. Nhân sự được đào tạo về Relational Database, SQL, Database Design, JOIN, CTE, Window Function, Stored Procedure, Function và Transaction; đồng thời đi sâu vào Lock, Deadlock, Index, Execution Plan và SQL Tuning. Mục tiêu không chỉ dừng ở việc viết được câu SQL mà là hiểu cách dữ liệu được tổ chức, truy vấn và tối ưu để tạo nền tảng ổn định cho các hệ thống dữ liệu phía trên.
2. Tích hợp dữ liệu và xây dựng Data Warehouse
Khi dữ liệu được tạo ra từ nhiều hệ thống khác nhau, doanh nghiệp cần có khả năng thu thập, biến đổi và đưa dữ liệu về một kiến trúc thống nhất phục vụ phân tích. Nội dung đào tạo tập trung vào Data Warehouse, ETL/ELT, Data Integration, Staging, SSIS, Slowly Changing Dimension và OLAP, đồng thời rèn luyện cách xử lý lỗi, Scheduling và Rerun Pipeline. Qua đó, nhân sự có thể xây dựng và kiểm soát dòng chảy từ nguồn dữ liệu → ETL → Data Warehouse → dữ liệu sẵn sàng cho phân tích, thay vì phụ thuộc vào việc tổng hợp báo cáo thủ công từ nhiều nguồn.
3. Xử lý dữ liệu lớn và dữ liệu thời gian thực
Khi khối lượng dữ liệu tăng lên hoặc doanh nghiệp cần xử lý dữ liệu gần như theo thời gian thực, Data Engineer cần có năng lực làm việc với hệ thống xử lý phân tán. Chương trình có thể triển khai từ Python và Pandas đến Hadoop, HDFS, Hive, HBase, Sqoop, Spark, PySpark và Spark SQL; đồng thời mở rộng sang Kafka, Spark Streaming, Structured Streaming và Debezium/CDC. Qua quá trình thực hành, học viên hiểu và triển khai được hai mô hình xử lý quan trọng là Batch Processing và Real-time Processing, từ đó lựa chọn kiến trúc phù hợp với từng bài toán dữ liệu.
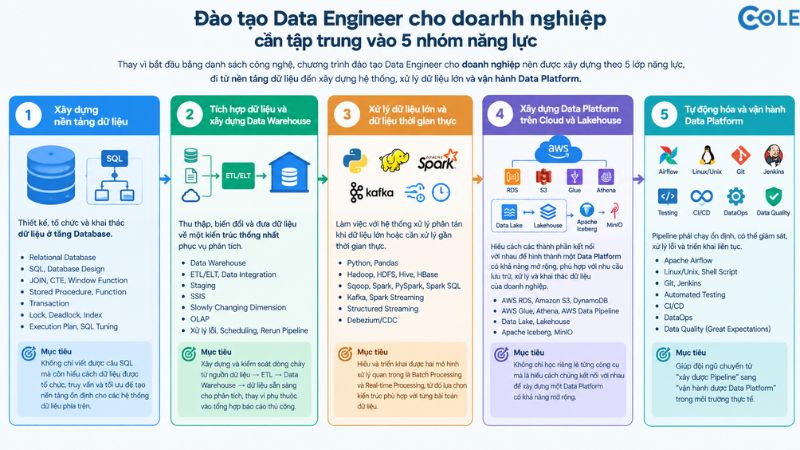
4. Xây dựng Data Platform trên Cloud và Lakehouse
Data Platform hiện đại không chỉ xoay quanh một Database mà thường bao gồm nhiều thành phần phục vụ lưu trữ, xử lý và truy vấn dữ liệu. Vì vậy, chương trình đào tạo có thể mở rộng sang các kiến trúc và công nghệ như AWS RDS, Amazon S3, DynamoDB, AWS Glue, Athena, AWS Data Pipeline, Data Lake, Lakehouse, Apache Iceberg và MinIO. Trọng tâm không nằm ở việc học riêng lẻ từng công cụ mà là hiểu cách các thành phần kết nối với nhau để hình thành một Data Platform có khả năng mở rộng, phù hợp với nhu cầu lưu trữ, xử lý và khai thác dữ liệu của doanh nghiệp.
5. Tự động hóa và vận hành Data Platform
Xây dựng được một Pipeline mới chỉ là bước đầu; trong môi trường doanh nghiệp, Pipeline còn phải chạy ổn định, có thể giám sát, xử lý lỗi và triển khai liên tục. Nội dung đào tạo tập trung vào Apache Airflow, Linux/Unix, Shell Script, Git, Jenkins, Automated Testing, CI/CD, DataOps và Data Quality với Great Expectations. Nhân sự được rèn luyện khả năng quản lý dependency, scheduling, monitoring, phát hiện và xử lý lỗi, kiểm thử cũng như triển khai Pipeline. Đây là lớp năng lực giúp đội ngũ chuyển từ “xây được Pipeline” sang “vận hành được Data Platform” trong môi trường thực tế.
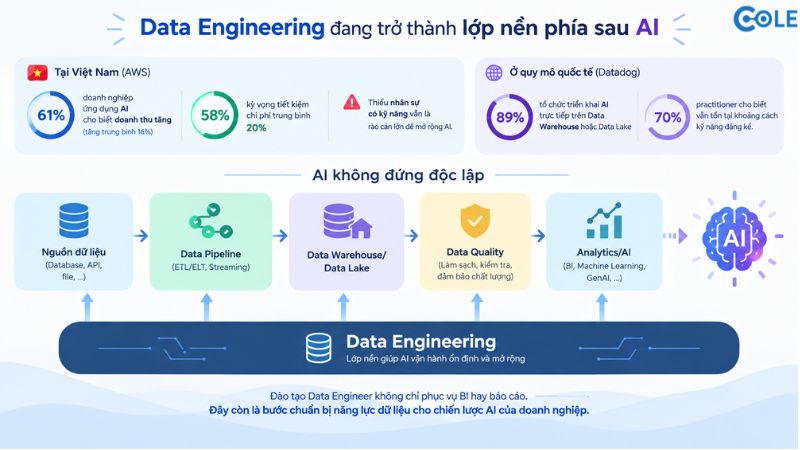
Data Engineering đang trở thành lớp nền phía sau AI
AI đang được ứng dụng nhanh tại Việt Nam nhưng mức độ trưởng thành vẫn còn chênh lệch.
Theo AWS, 61% doanh nghiệp Việt Nam đã ứng dụng AI cho biết doanh thu tăng, với mức tăng trung bình 16%; 58% kỳ vọng tiết kiệm chi phí trung bình 20%. Tuy nhiên, thiếu nhân sự có kỹ năng vẫn là rào cản lớn đối với việc mở rộng AI.
Ở quy mô quốc tế, khảo sát Datadog cho thấy 89% tổ chức được khảo sát triển khai AI trực tiếp trên Data Warehouse hoặc Data Lake, trong khi 70% practitioner cho biết vẫn tồn tại khoảng cách kỹ năng đáng kể.
Điều này cho thấy AI không đứng độc lập.
Một kiến trúc AI doanh nghiệp có thể cần:
Nguồn dữ liệu → Data Pipeline → Data Warehouse/Data Lake → Data Quality → Analytics/AI
Nếu lớp dữ liệu phía dưới thiếu ổn định, việc mở rộng AI cũng trở nên khó khăn hơn.
Vì vậy, đào tạo Data Engineer không chỉ phục vụ BI hay báo cáo.
Đây còn là một bước chuẩn bị năng lực dữ liệu cho chiến lược AI của doanh nghiệp.
COLE đào tạo Data Engineer theo mô hình End-to-End
Một Data Engineer giỏi không được đánh giá bằng việc biết bao nhiêu công nghệ. Quan trọng hơn là khi dữ liệu đi vào hệ thống, người đó có biết phải đưa nó đi đâu, xử lý ở đâu và làm thế nào để dữ liệu luôn sẵn sàng cho người sử dụng hay không.
Đó là lý do chương trình đào tạo Data Engineer tại COLE được xây dựng theo tư duy End-to-End. Thay vì tách SQL, Python, Spark, Kafka, Airflow hay Cloud thành những phần kiến thức độc lập, chương trình đặt chúng vào đúng vị trí trong một kiến trúc dữ liệu hoàn chỉnh.
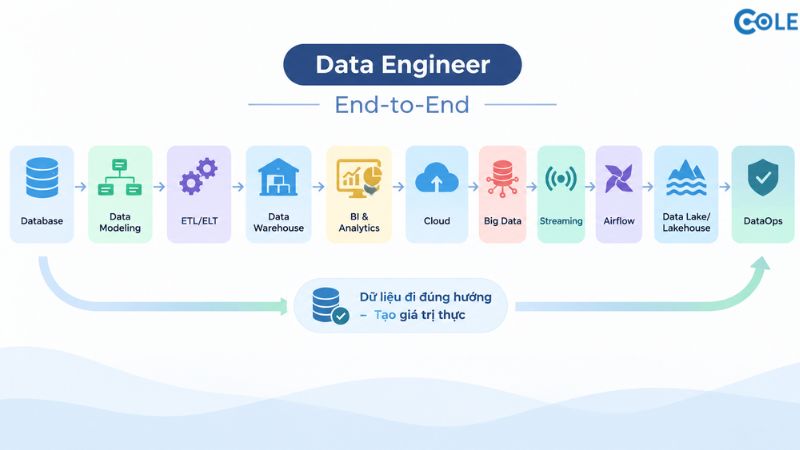
Dữ liệu có thể bắt đầu từ Database, được tổ chức qua Data Modeling, thu thập và biến đổi bằng ETL/ELT, đưa vào Data Warehouse, sau đó phục vụ BI và phân tích. Khi quy mô tăng lên, hệ thống có thể mở rộng với Cloud, Big Data và Streaming; các Pipeline được điều phối bằng Airflow, dữ liệu được tổ chức trên Data Lake/Lakehouse và cuối cùng được kiểm soát, kiểm thử, triển khai thông qua các nguyên tắc DataOps.
Dữ liệu không dừng lại ở từng công cụ riêng lẻ, mà được dẫn qua một chuỗi năng lực xuyên suốt:
Database → Data Modeling → ETL/ELT → Data Warehouse → BI → Cloud → Big Data → Streaming → Airflow → Data Lake/Lakehouse → DataOps
Điểm quan trọng nằm ở mối liên kết giữa các lớp. SQL không chỉ dừng ở truy vấn dữ liệu; ETL không chỉ là một bước chuyển dữ liệu; Airflow không đơn thuần là công cụ đặt lịch. Mỗi thành phần giải quyết một mắt xích trong bài toán lớn hơn: làm thế nào để dữ liệu từ lúc phát sinh có thể đi qua hệ thống, được xử lý đúng, lưu trữ đúng, phục vụ đúng và vận hành ổn định.
Nhờ cách tiếp cận này, học viên không chỉ biết “công nghệ này dùng để làm gì” mà còn hiểu “công nghệ này nằm ở đâu trong toàn bộ hệ thống dữ liệu”.
Đó chính là tư duy End-to-End mà một chương trình đào tạo Data Engineer cho doanh nghiệp cần hướng tới: không học từng công cụ rời rạc, mà học cách xây dựng và vận hành một dòng chảy dữ liệu hoàn chỉnh.
7 nhóm dự án Data Engineering từ Database đến Cloud
Một điểm nổi bật trong chương trình COLE là hệ thống project trải dài qua nhiều lớp của Data Engineering.
Project 1: Database và SQL
Xây dựng Database theo các bài toán như:
E-commerce.
Hotel Booking.
Event.
HR.
Học viên thực hành thiết kế dữ liệu, SQL và xây dựng báo cáo.
Năng lực đầu ra
Business Problem → Database Design → SQL → Report
Project 2: Data Warehouse, ETL và Power BI
Từ dữ liệu nghiệp vụ, đội ngũ xây dựng:
Database → ETL → Data Warehouse → Power BI
Nội dung này giúp kết nối Data Engineering với nhu cầu BI và báo cáo của doanh nghiệp.
Project 3: Hadoop, HBase và Sqoop
Đội ngũ tiếp tục làm việc với hệ sinh thái Big Data để hiểu cách thu thập, lưu trữ và xử lý dữ liệu ở quy mô lớn.
Project 4: PySpark ETL
Thực hành Pipeline xử lý dữ liệu bằng PySpark, kết nối các hệ thống dữ liệu và thực hiện biến đổi dữ liệu.
Project 5: Kafka và Spark Streaming
Xây dựng bài toán xử lý dữ liệu real-time:
Data Source → Kafka → Spark Streaming → Analytics
Phù hợp với các bài toán cần cập nhật dữ liệu liên tục.
Project 6: Data Lake/Lakehouse
Kết hợp dữ liệu batch và real-time với:
Kafka + RDS → Iceberg + MinIO → Analytics
Qua đó tiếp cận kiến trúc Data Lake/Lakehouse hiện đại.
Project 7: AWS Data Platform
Triển khai bài toán Data Warehouse/Data Lake trên AWS và kết nối dữ liệu từ nhiều nguồn.
Điểm khác biệt của hệ thống project
Các project không chỉ nhằm tạo portfolio cá nhân.
Với đào tạo doanh nghiệp, cấu trúc project có thể được sử dụng như khung thực hành để mô phỏng hoặc điều chỉnh theo bài toán dữ liệu thực tế của doanh nghiệp.
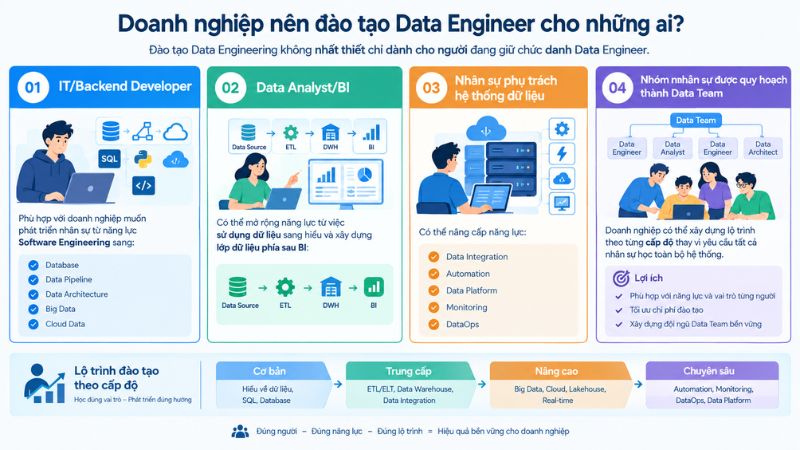
Doanh nghiệp nên đào tạo Data Engineer cho những ai?
Đào tạo Data Engineering không nhất thiết chỉ dành cho người đang giữ chức danh Data Engineer.
IT/Backend Developer
Phù hợp với doanh nghiệp muốn phát triển nhân sự từ năng lực Software Engineering sang:
Database.
Data Pipeline.
Data Architecture.
Big Data.
Cloud Data.
Data Analyst/BI
Có thể mở rộng năng lực từ việc sử dụng dữ liệu sang hiểu và xây dựng lớp dữ liệu phía sau BI:
Data Source → ETL → DWH → BI
Nhân sự phụ trách hệ thống dữ liệu
Có thể nâng cấp năng lực:
Data Integration.
Automation.
Data Platform.
Monitoring.
DataOps.
Nhóm nhân sự được quy hoạch thành Data Team
Doanh nghiệp có thể xây dựng lộ trình theo từng cấp độ thay vì yêu cầu tất cả nhân sự học toàn bộ hệ thống.
Đào tạo Data Engineer In-house: Đào tạo theo đúng bài toán của doanh nghiệp
Một doanh nghiệp bán lẻ và một doanh nghiệp sản xuất có thể sử dụng những kiến trúc dữ liệu hoàn toàn khác nhau.
Ví dụ:
Bán lẻ:
POS → E-commerce → CRM → DWH → BI
Sản xuất:
ERP → IoT → Production Data → Data Lake → Analytics
Doanh nghiệp dịch vụ:
CRM → Website → Transaction → DWH → Customer Analytics
Vì vậy, đào tạo In-house nên bắt đầu bằng khảo sát bài toán dữ liệu, thay vì đưa ngay một giáo trình cố định.
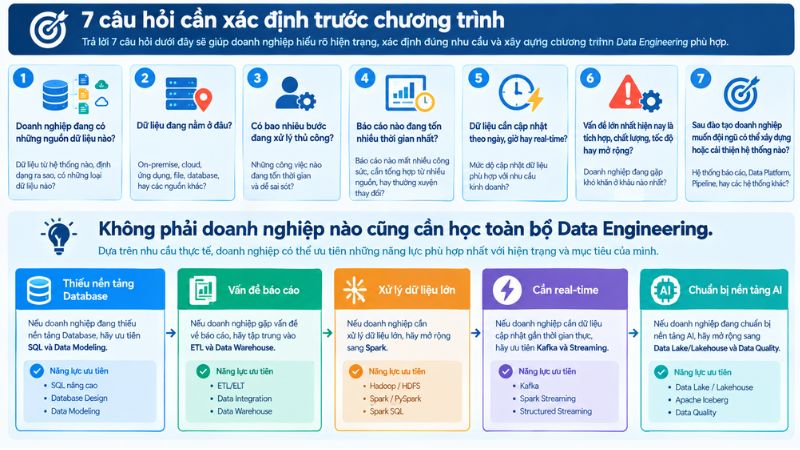
7 câu hỏi cần xác định trước chương trình
Doanh nghiệp đang có những nguồn dữ liệu nào?
Dữ liệu đang nằm ở đâu?
Có bao nhiêu bước đang xử lý thủ công?
Báo cáo nào đang tốn nhiều thời gian nhất?
Dữ liệu cần cập nhật theo ngày, giờ hay real-time?
Vấn đề lớn nhất hiện nay là tích hợp, chất lượng, tốc độ hay mở rộng?
Sau đào tạo doanh nghiệp muốn đội ngũ có thể xây dựng hoặc cải thiện hệ thống nào?
Từ đó, chương trình có thể ưu tiên những năng lực thực sự cần thiết.
Không phải doanh nghiệp nào cũng cần học toàn bộ Data Engineering.
Doanh nghiệp đang thiếu nền tảng Database có thể ưu tiên SQL và Data Modeling.
Doanh nghiệp đang gặp vấn đề báo cáo có thể tập trung vào ETL và Data Warehouse.
Doanh nghiệp cần xử lý dữ liệu lớn có thể mở rộng sang Spark.
Doanh nghiệp cần real-time có thể ưu tiên Kafka và Streaming.
Doanh nghiệp đang chuẩn bị nền tảng AI có thể mở rộng sang Data Lake/Lakehouse và Data Quality.
Doanh nghiệp nhận được gì sau đào tạo?
Mục tiêu của chương trình không phải để nhân sự “biết thêm 10 công nghệ”.
Mục tiêu là xây dựng năng lực có thể sử dụng trong công việc:
| Năng lực | Giá trị đối với doanh nghiệp |
|---|---|
| Database & SQL | Tổ chức và khai thác dữ liệu hiệu quả |
| ETL/ELT | Tự động hóa luồng dữ liệu |
| Data Warehouse | Tập trung dữ liệu phục vụ phân tích |
| Data Modeling | Tạo cấu trúc dữ liệu dễ mở rộng |
| BI | Biến dữ liệu thành báo cáo và thông tin |
| Big Data | Xử lý dữ liệu quy mô lớn |
| Streaming | Xử lý dữ liệu gần real-time |
| Cloud | Xây dựng hạ tầng dữ liệu có khả năng mở rộng |
| Lakehouse | Kết hợp nhiều loại dữ liệu và workload |
| DataOps | Kiểm soát và vận hành hệ thống dữ liệu |
Từ đó, doanh nghiệp hướng tới việc hình thành một đội ngũ có thể:
Kết nối dữ liệu → xử lý → lưu trữ → kiểm soát chất lượng → phân tích → tự động hóa → mở rộng → vận hành.
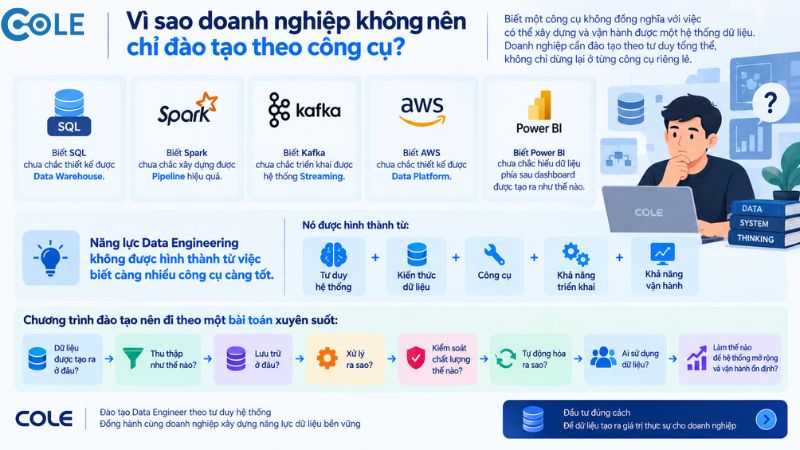
Vì sao doanh nghiệp không nên chỉ đào tạo theo công cụ?
Một nhân sự biết SQL chưa chắc thiết kế được Data Warehouse.
Biết Spark chưa chắc xây dựng được Pipeline hiệu quả.
Biết Kafka chưa chắc triển khai được hệ thống Streaming.
Biết AWS chưa chắc thiết kế được Data Platform.
Biết Power BI chưa chắc hiểu dữ liệu phía sau dashboard được tạo ra như thế nào.
Năng lực Data Engineering không được hình thành từ việc biết càng nhiều công cụ càng tốt.
Nó được hình thành từ:
Tư duy hệ thống + kiến thức dữ liệu + công cụ + khả năng triển khai + khả năng vận hành.
Đây là lý do chương trình đào tạo nên đi theo một bài toán xuyên suốt:
Dữ liệu được tạo ra ở đâu?→ Thu thập như thế nào?→ Lưu trữ ở đâu?→ Xử lý ra sao?→ Kiểm soát chất lượng thế nào?→ Tự động hóa ra sao?→ Ai sử dụng dữ liệu?→ Làm thế nào để hệ thống mở rộng và vận hành ổn định?
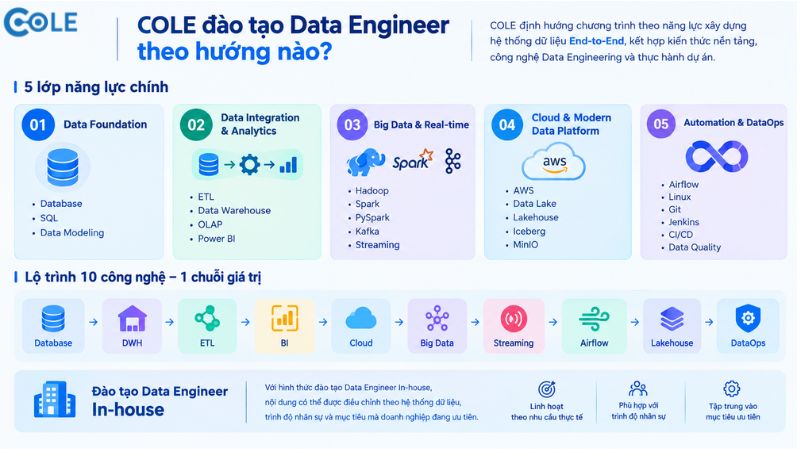
COLE đào tạo Data Engineer theo hướng nào?
COLE định hướng chương trình theo năng lực xây dựng hệ thống dữ liệu End-to-End, kết hợp kiến thức nền tảng, công nghệ Data Engineering và thực hành dự án.
5 lớp năng lực chính
01. Data FoundationDatabase, SQL, Data Modeling.
02. Data Integration & AnalyticsETL, Data Warehouse, OLAP, Power BI.
03. Big Data & Real-timeHadoop, Spark, PySpark, Kafka, Streaming.
04. Cloud & Modern Data PlatformAWS, Data Lake, Lakehouse, Iceberg, MinIO.
05. Automation & DataOpsAirflow, Linux, Git, Jenkins, CI/CD, Data Quality.
Điểm quan trọng là các lớp năng lực này không đứng độc lập mà tạo thành một chuỗi:
Database → DWH → ETL → BI → Cloud → Big Data → Streaming → Airflow → Lakehouse → DataOps
Với hình thức đào tạo Data Engineer In-house, nội dung có thể được điều chỉnh theo hệ thống dữ liệu, trình độ nhân sự và mục tiêu mà doanh nghiệp đang ưu tiên.
FAQ về đào tạo Data Engineer cho doanh nghiệp
Đào tạo Data Engineer cho doanh nghiệp là gì?
Đây là chương trình phát triển năng lực cho đội ngũ trong việc xây dựng, tích hợp, xử lý, lưu trữ, phân tích và vận hành hệ thống dữ liệu, từ Database và ETL đến Big Data, Cloud, Streaming và Lakehouse.
Doanh nghiệp chưa có Data Engineer có nên đào tạo không?
Có. Doanh nghiệp có thể bắt đầu từ nhóm IT, Backend, BI hoặc nhân sự đang phụ trách Database và hệ thống dữ liệu, sau đó phát triển dần thành năng lực Data Engineering nội bộ.
Doanh nghiệp có cần học toàn bộ SQL, Spark, Kafka, AWS và Airflow không?
Không nhất thiết. Nội dung nên được lựa chọn dựa trên bài toán thực tế. Doanh nghiệp đang gặp vấn đề về báo cáo có thể ưu tiên SQL, ETL và Data Warehouse; doanh nghiệp cần real-time mới cần mở rộng sang Kafka và Streaming.
Data Engineer có liên quan gì đến AI?
Data Engineering tạo ra lớp hạ tầng để thu thập, xử lý, chuẩn hóa và cung cấp dữ liệu cho Analytics, Machine Learning và AI. Khảo sát Datadog cho thấy 89% tổ chức được khảo sát đã triển khai AI trực tiếp trên Data Warehouse hoặc Data Lake.
Đào tạo Data Engineer In-house có thể điều chỉnh theo doanh nghiệp không?
Có. Chương trình có thể được xây dựng dựa trên nguồn dữ liệu, hệ thống hiện tại, năng lực nhân sự và bài toán mà doanh nghiệp muốn giải quyết.
COLE có đào tạo theo dự án không?
Có. Chương trình hiện có các nhóm project trải dài từ Database, Data Warehouse, ETL, BI đến Hadoop, PySpark, Kafka, Lakehouse và AWS, giúp người học tiếp cận nhiều lớp của hệ thống Data Engineering.


.png)

