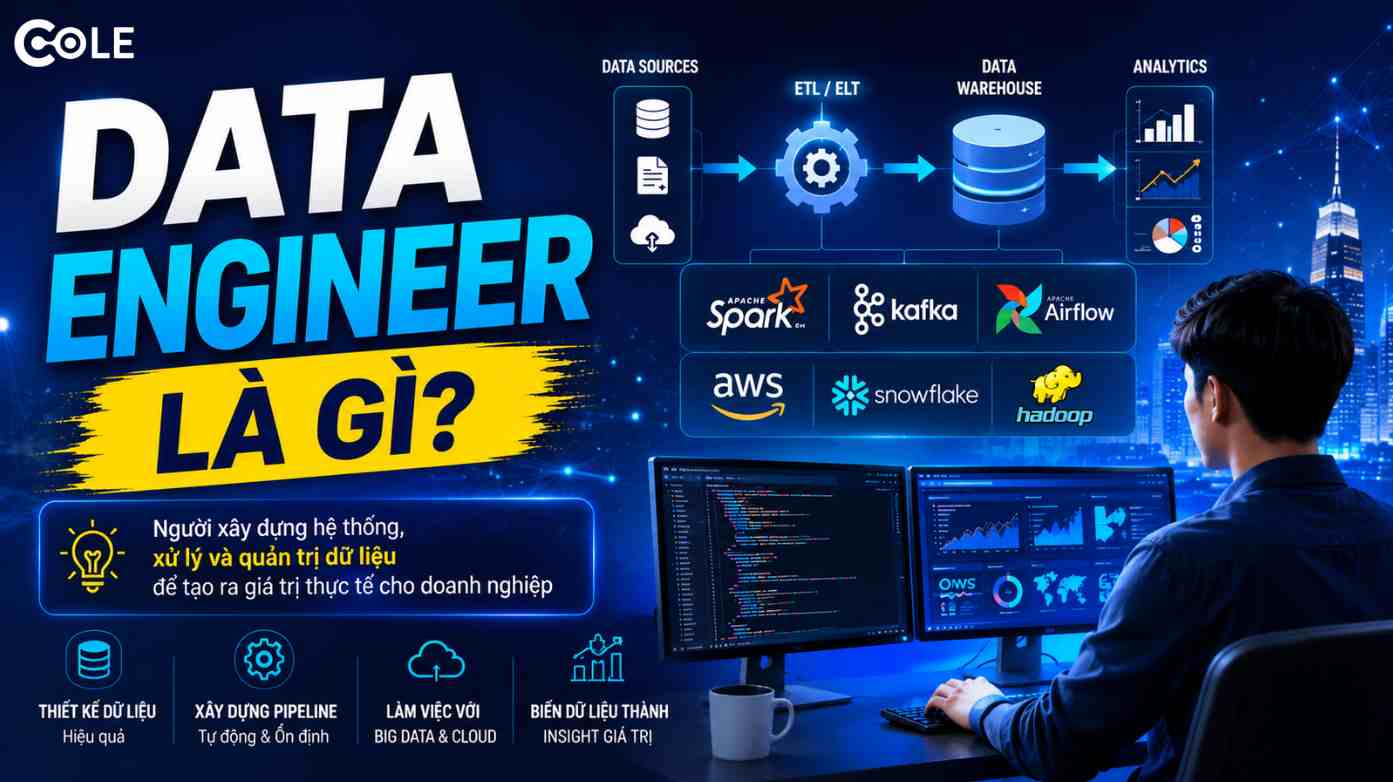
Quy trình ETL là phương pháp xử lý dữ liệu gồm ba bước Extract (trích xuất), Transform (chuyển đổi) và Load (nạp dữ liệu). Quy trình này giúp doanh nghiệp thu thập dữ liệu từ nhiều nguồn, chuẩn hóa thông tin và đưa vào hệ thống lưu trữ phục vụ phân tích, báo cáo và ra quyết định.
Trong bối cảnh dữ liệu doanh nghiệp tăng theo cấp số nhân và các công ty đẩy mạnh chuyển đổi số, ETL không còn là một kỹ thuật phụ trợ mà đã trở thành xương sống của mọi Data Platform hiện đại. Đây cũng là kỹ năng đầu tiên và bắt buộc với bất kỳ ai theo đuổi nghề Data Engineer.
Bài viết này sẽ đi từ gốc: ETL là gì, vận hành ra sao trong một pipeline thực tế, công việc hằng ngày của Data Engineer xoay quanh ETL, và lộ trình học tập cụ thể nếu bạn muốn bắt đầu từ con số 0.
Quy trình ETL là gì?
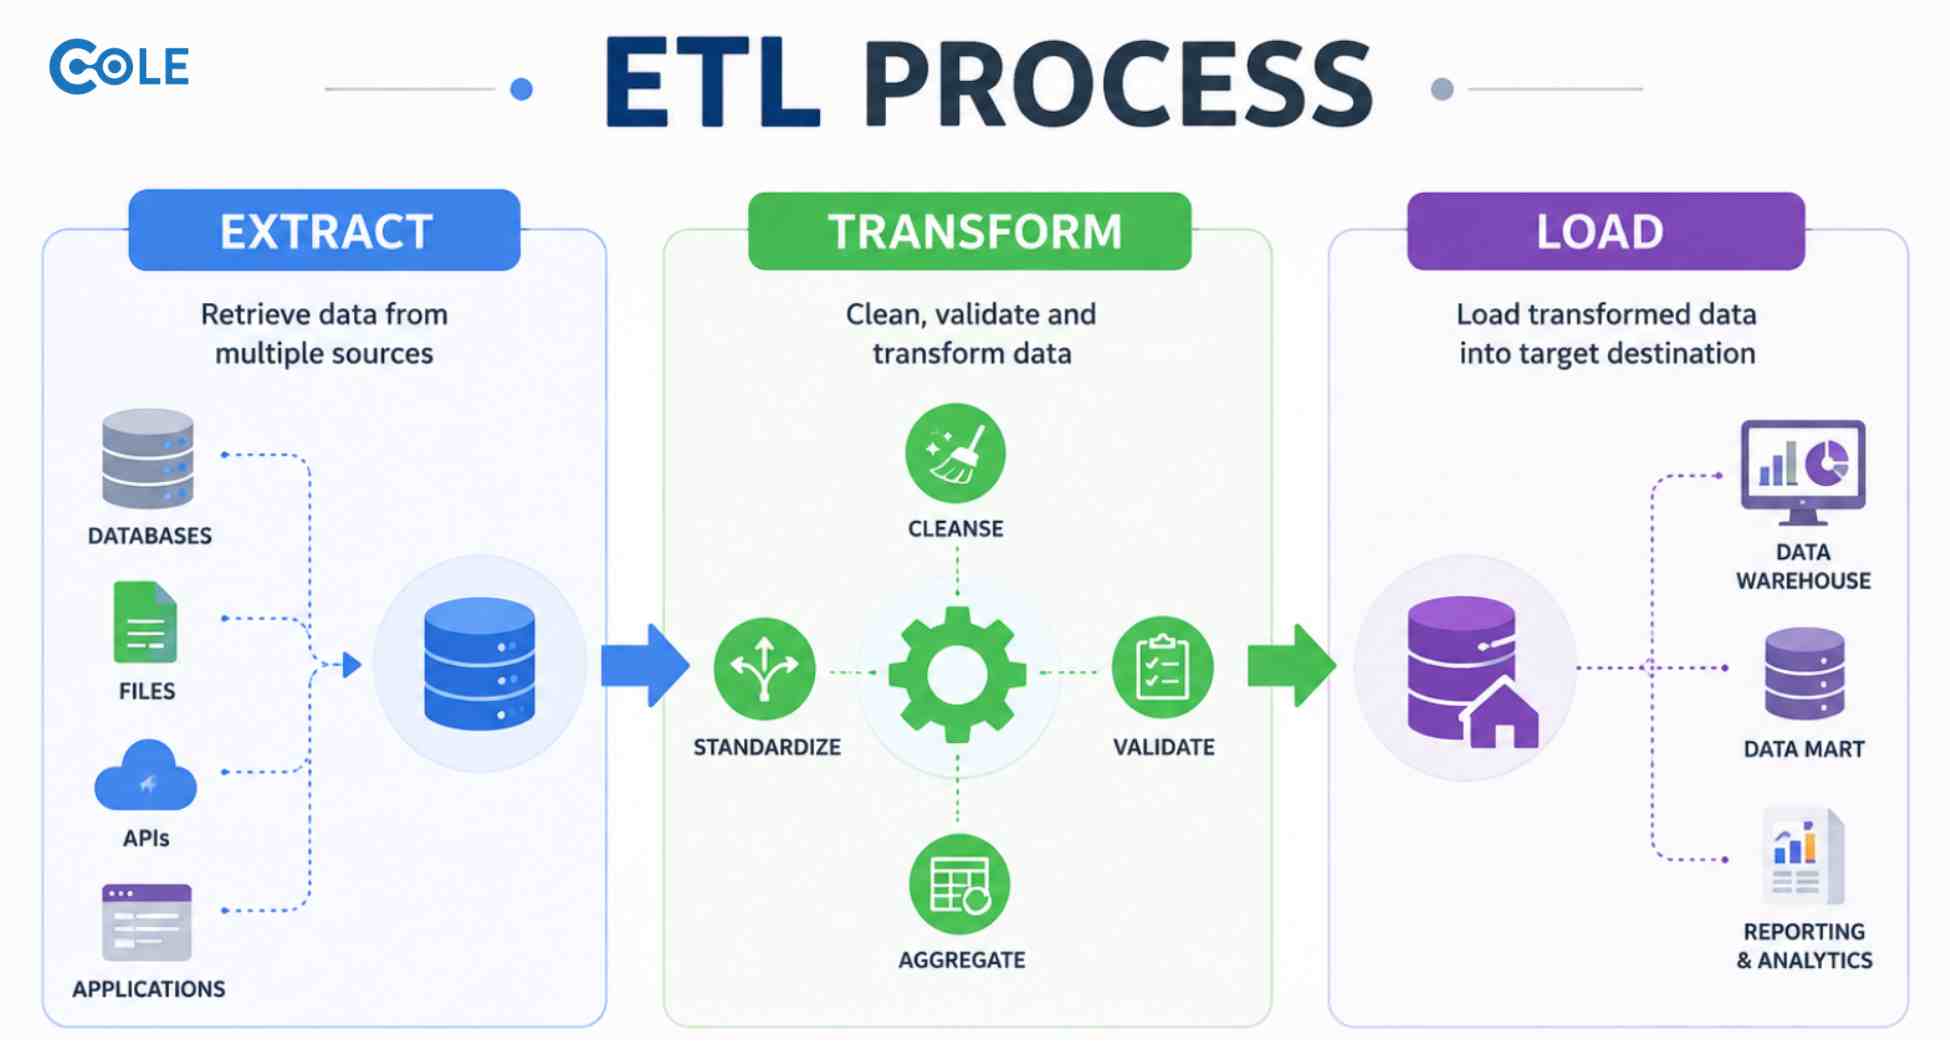
ETL là viết tắt của ba giai đoạn xử lý dữ liệu diễn ra tuần tự:
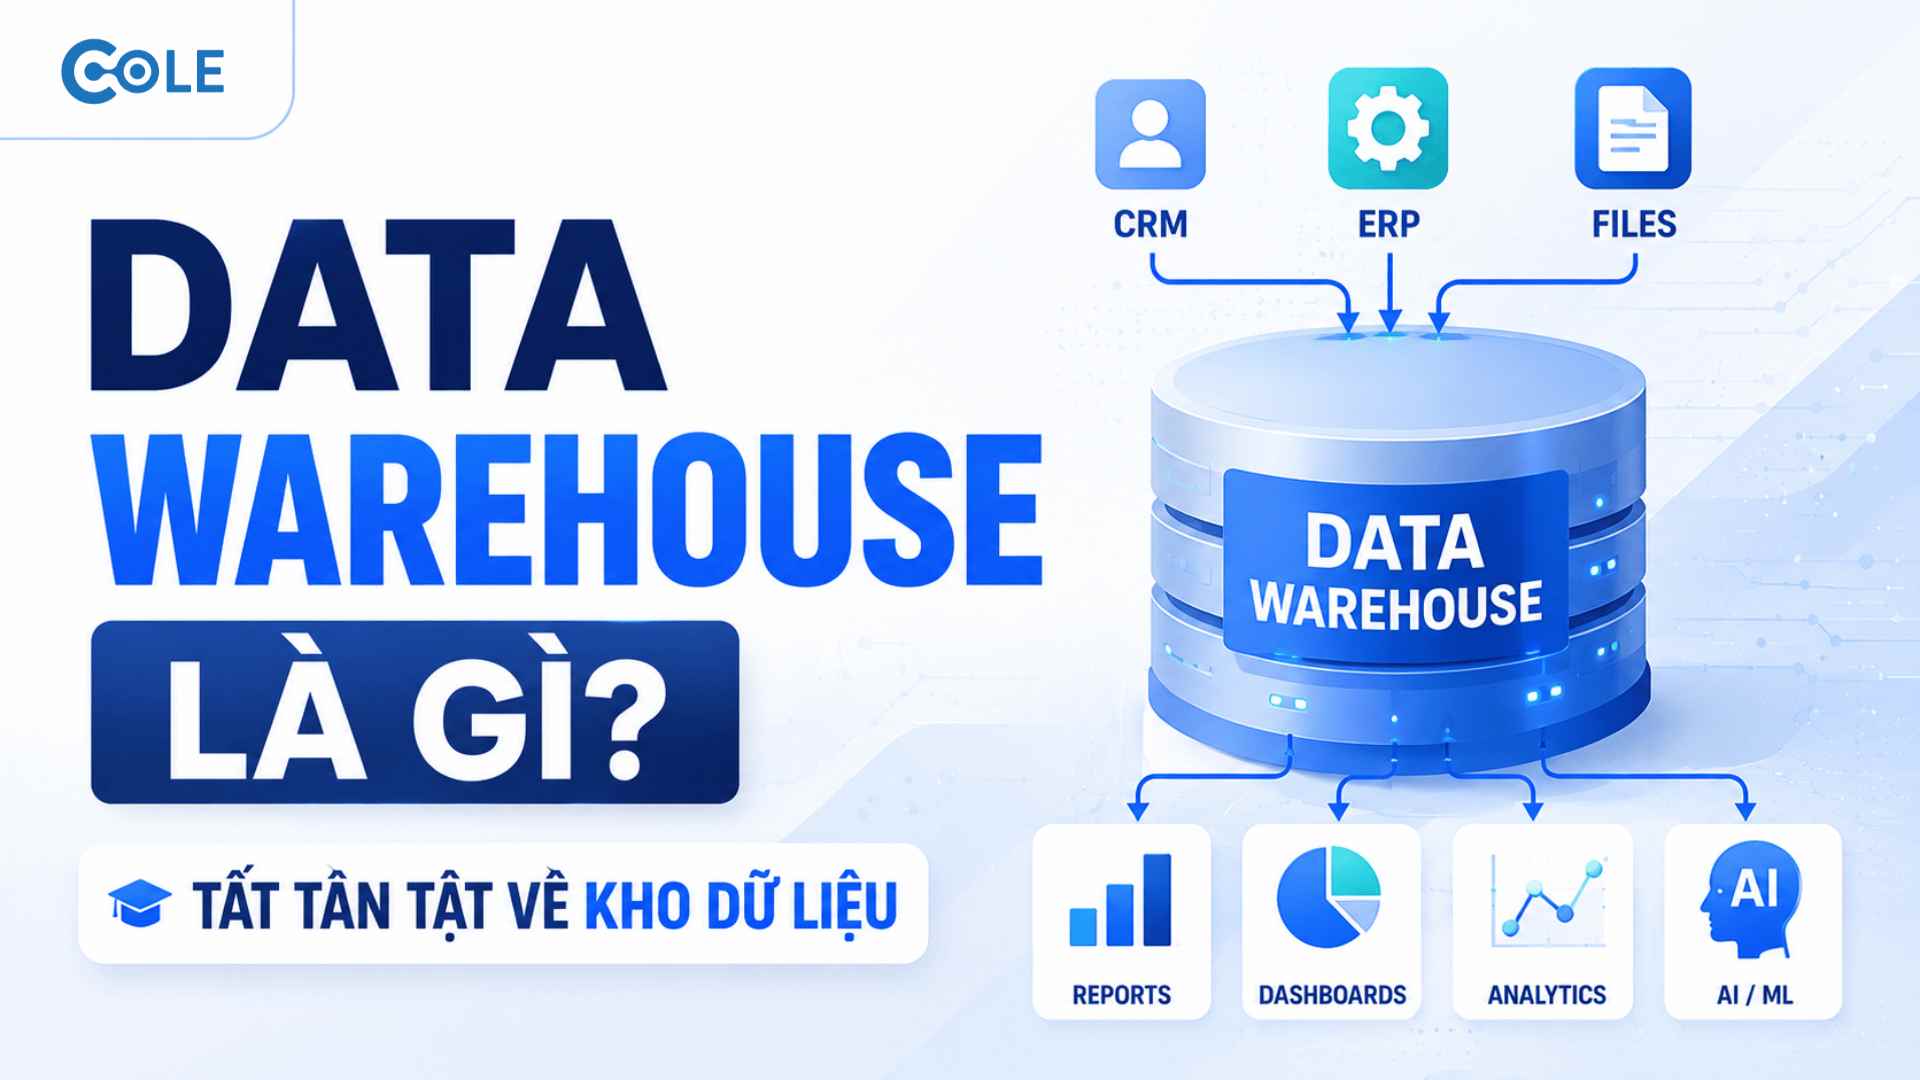
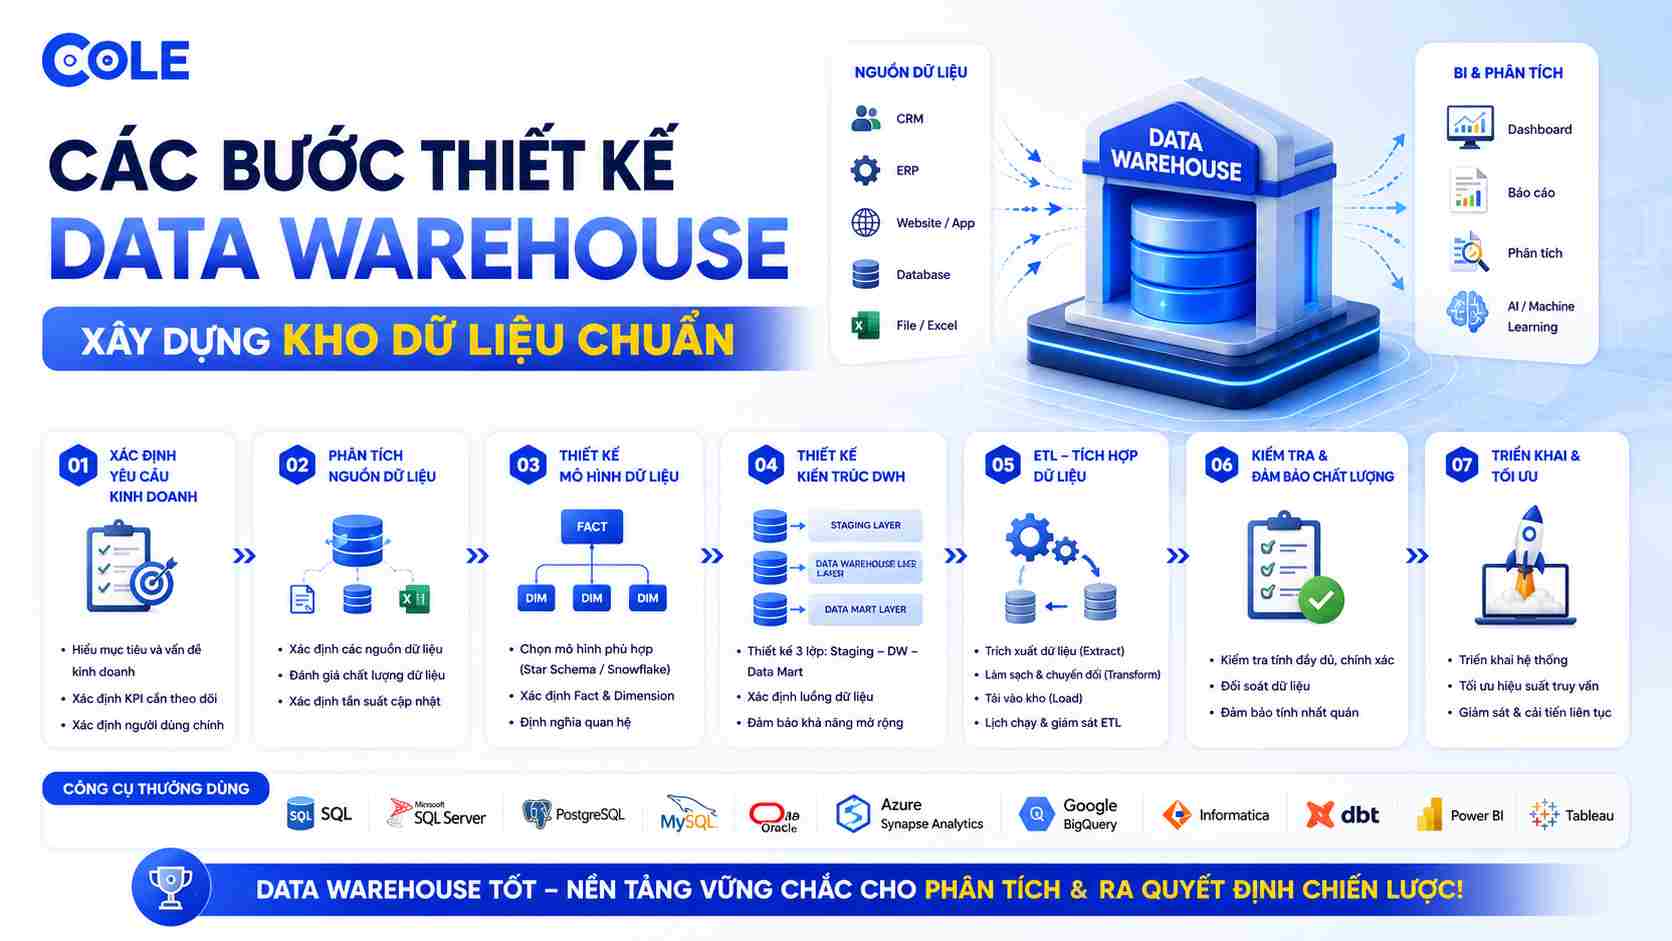
Extract (Trích xuất): Lấy dữ liệu thô từ nhiều nguồn khác nhau — cơ sở dữ liệu (Database), API bên thứ ba, file CSV/JSON, hoặc các hệ thống nghiệp vụ như CRM, ERP.
Transform (Biến đổi): Làm sạch, chuẩn hóa, kết hợp (join) và áp dụng logic nghiệp vụ (business logic) lên dữ liệu vừa trích xuất.
Load (Tải): Đưa dữ liệu đã qua xử lý vào Data Warehouse hoặc Data Lake để phục vụ truy vấn và phân tích.
Về bản chất, ETL là cầu nối biến dữ liệu thô, rời rạc và thiếu nhất quán thành dữ liệu có cấu trúc, đáng tin cậy — sẵn sàng cho Business Intelligence (BI), Machine Learning hoặc các báo cáo ra quyết định hằng ngày.
Tại sao ETL quan trọng trong Data Engineering?
Trên thực tế triển khai, dữ liệu doanh nghiệp gần như luôn ở trong tình trạng "lộn xộn" trước khi qua ETL:
Phân tán ở nhiều hệ thống khác nhau (bán hàng, marketing, vận hành, tài chính…)
Không đồng nhất về định dạng (ngày tháng, tiền tệ, mã khách hàng…)
Chứa lỗi, giá trị thiếu hoặc bản ghi trùng lặp
ETL xử lý triệt để những vấn đề này bằng cách:
Chuẩn hóa dữ liệu về một định dạng thống nhất, dễ đối chiếu
Đảm bảo chất lượng dữ liệu (Data Quality) trước khi đưa vào phân tích
Tối ưu hiệu năng truy vấn cho các hệ thống báo cáo, dashboard
Giúp doanh nghiệp ra quyết định dựa trên số liệu chính xác, thay vì cảm tính
Chính vì vậy, ETL luôn nằm trong nhóm kỹ năng cốt lõi mà một Data Engineer phải nắm vững — và cũng là phần chiếm tỷ trọng lớn trong bất kỳ lộ trình Data Engineer bài bản nào.
Quy trình ETL hoạt động như thế nào trong thực tế?
Để hiểu rõ bản chất ETL, hãy đi qua từng bước như trong một pipeline dữ liệu thực tế tại doanh nghiệp.
1. Extract – Thu thập dữ liệu
Data Engineer kết nối tới nhiều nguồn dữ liệu khác nhau, ví dụ:
Database quan hệ: MySQL, PostgreSQL, Oracle
API từ hệ thống bên thứ ba (thanh toán, quảng cáo, CRM…)
File tĩnh: log hệ thống, CSV, JSON
Dữ liệu streaming thời gian thực qua Kafka
Mục tiêu quan trọng nhất ở bước này là lấy dữ liệu ổn định, đúng, đủ mà không gây áp lực hoặc làm gián đoạn hệ thống nguồn — vì hệ thống nguồn thường vẫn đang phục vụ người dùng thật.
2. Transform – Xử lý và chuẩn hóa dữ liệu
Đây là bước phức tạp và tốn nhiều công sức nhất trong ETL. Các công việc điển hình gồm:
Làm sạch dữ liệu: loại bỏ giá trị null, bản ghi trùng lặp
Chuẩn hóa định dạng: ngày tháng, đơn vị tiền tệ, chuỗi văn bản
Kết hợp (join) dữ liệu từ nhiều bảng, nhiều nguồn
Áp dụng logic nghiệp vụ, ví dụ: tính doanh thu theo tháng, phân loại nhóm khách hàng
Xây dựng data model phục vụ cho việc phân tích và báo cáo
Các công cụ thường dùng ở bước này là SQL, Python (Pandas, PySpark), cùng các framework xử lý dữ liệu quy mô lớn như Spark hoặc dbt.
3. Load – Lưu trữ dữ liệu
Sau khi được xử lý, dữ liệu sẽ được nạp vào:
Data Warehouse: BigQuery, Snowflake, Redshift
Data Lake: Amazon S3, HDFS
Data Mart phục vụ riêng cho từng team BI
Mục tiêu cuối cùng là đảm bảo dữ liệu dễ truy vấn, tối ưu hiệu năng và luôn sẵn sàng phục vụ dashboard, báo cáo cho các bộ phận trong công ty.
ETL vs ELT – Sự khác biệt quan trọng
ETL và ELT đều phục vụ quá trình tích hợp dữ liệu nhưng khác nhau ở thời điểm thực hiện bước chuyển đổi.
| Tiêu chí | ETL | ELT |
|---|---|---|
| Thứ tự xử lý | Extract → Transform → Load | Extract → Load → Transform |
| Thời điểm chuyển đổi | Trước khi nạp vào hệ thống đích | Sau khi nạp vào hệ thống đích |
| Nơi xử lý | Công cụ hoặc môi trường xử lý trung gian | Thường sử dụng năng lực xử lý của hệ thống đích |
| Ưu điểm | Có thể kiểm soát dữ liệu trước khi nạp | Linh hoạt trong việc xử lý lại dữ liệu đã lưu |
| Lưu ý | Cần thiết kế tốt bước biến đổi và nạp | Cần quản lý dữ liệu thô, quyền truy cập và chi phí xử lý |
| Trường hợp phù hợp | Khi cần xử lý dữ liệu trước khi đưa vào hệ thống đích | Khi nền tảng đích có năng lực xử lý và lưu trữ phù hợp |
ELT thường được sử dụng với các nền tảng kho dữ liệu hiện đại có khả năng mở rộng tài nguyên xử lý. Trong khi đó, ETL vẫn phù hợp với những hệ thống cần biến đổi dữ liệu trước khi nạp hoặc có các yêu cầu kiến trúc đặc thù.
Không có mô hình nào luôn tốt hơn mô hình còn lại. Doanh nghiệp cần lựa chọn dựa trên khối lượng dữ liệu, yêu cầu bảo mật, chi phí, hạ tầng và cách vận hành.
Công việc của Data Engineer liên quan đến ETL
Trong công việc hằng ngày, một Data Engineer thường đảm nhận:
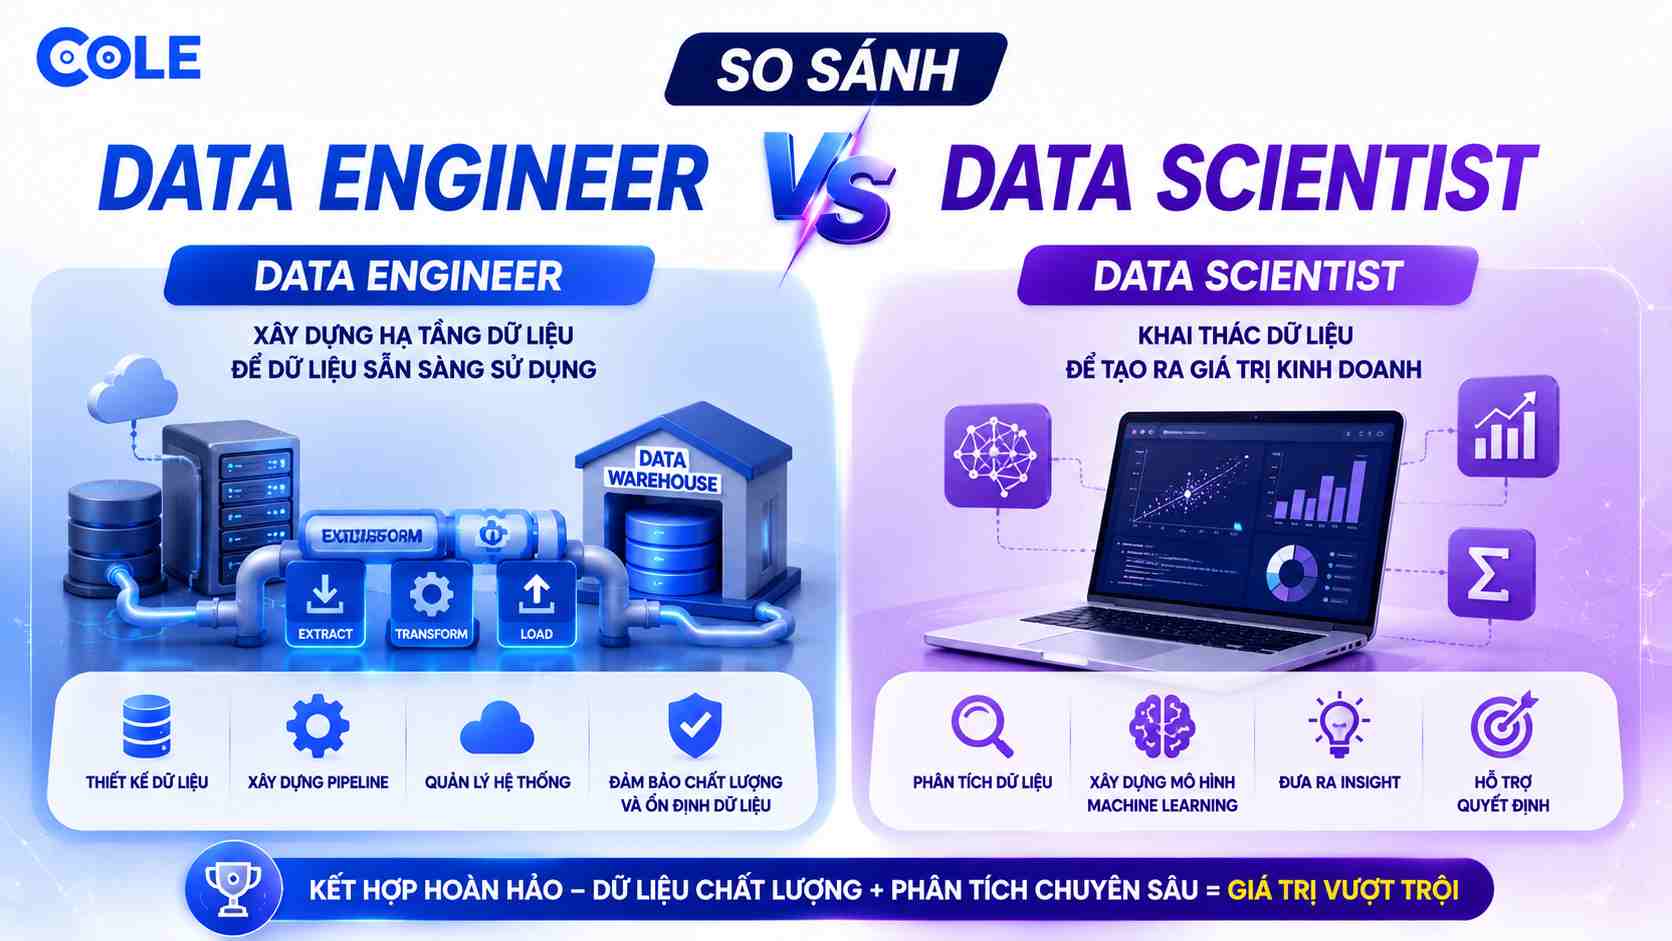
Thiết kế và xây dựng pipeline ETL/ELT
Xây dựng hệ thống ingest dữ liệu theo cả hai mô hình batch và streaming
Tối ưu hiệu năng (performance) của pipeline khi dữ liệu tăng trưởng
Giám sát và đảm bảo chất lượng dữ liệu (data quality & monitoring)
Phối hợp chặt chẽ với Data Analyst, đội BI và Product team để hiểu đúng nhu cầu dữ liệu
Bộ công cụ phổ biến nhất trong hệ sinh thái ETL/ELT hiện nay gồm: Airflow (điều phối pipeline), Spark (xử lý dữ liệu lớn), Kafka (streaming), dbt (transform trong warehouse), cùng SQL và Python làm nền tảng.
Bộ kỹ năng cần có để làm ETL
Kỹ năng kỹ thuật (Hard Skills)
SQL — kỹ năng bắt buộc, dùng gần như mỗi ngày
Python cho xử lý và biến đổi dữ liệu
Hiểu về Data Warehouse và Data Modeling
Kiến thức nền về hệ thống phân tán (Spark, Hadoop)
Làm việc được với ít nhất một nền tảng Cloud: AWS, GCP hoặc Azure
Kỹ năng tư duy (Soft Skills)
Tư duy hệ thống (System Thinking) để hình dung toàn bộ luồng dữ liệu
Khả năng debug pipeline khi dữ liệu bị lỗi hoặc chậm
Hiểu logic nghiệp vụ để biến đổi dữ liệu đúng mục đích sử dụng
Kỹ năng làm việc liên phòng ban, vì ETL luôn phục vụ nhiều team khác nhau
Lộ trình học ETL cho người mới bắt đầu
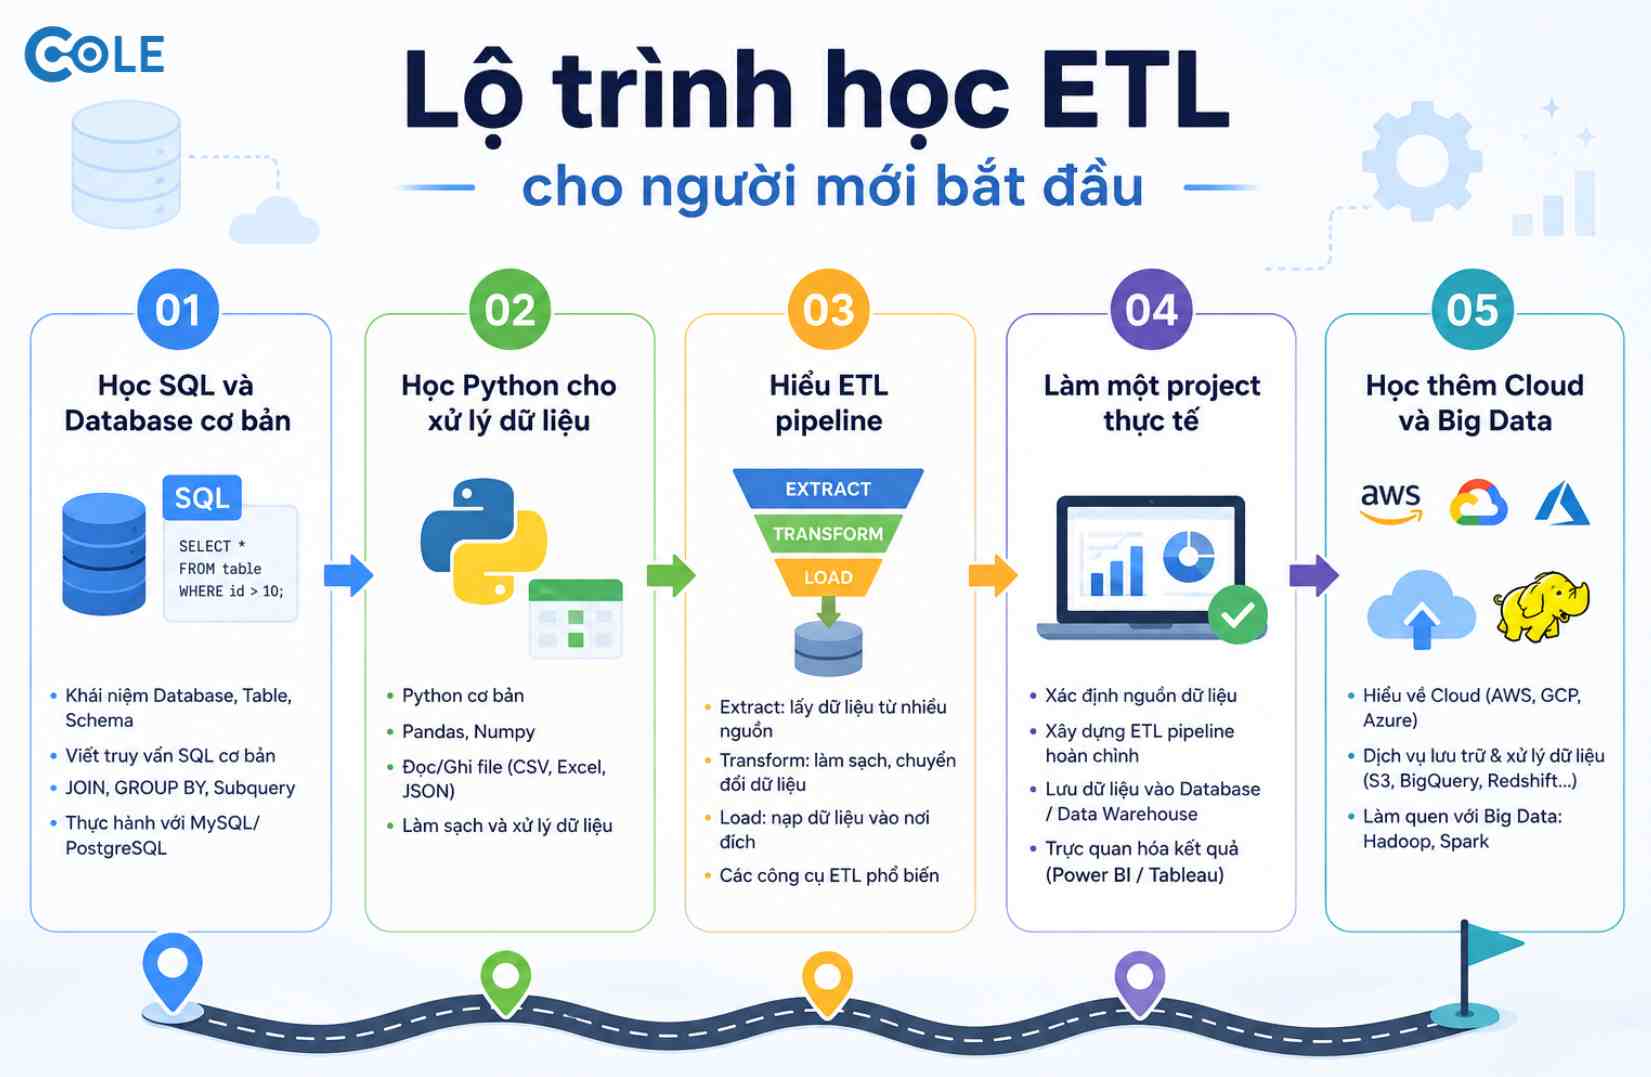
Nếu mục tiêu của bạn là trở thành Data Engineer, đây là lộ trình học ETL theo thứ tự hợp lý nhất:
Học SQL và Database cơ bản — nền tảng bắt buộc trước khi học bất kỳ công cụ ETL nào
Học Python cho xử lý dữ liệu — đặc biệt là Pandas để làm quen với thao tác biến đổi dữ liệu
Hiểu ETL pipeline ở cả hai mô hình batch và streaming
Làm một project thực tế — tự xây một pipeline end-to-end, từ Extract đến Load
Học thêm Cloud và Big Data như Spark, Kafka để xử lý dữ liệu quy mô lớn
Câu hỏi thường gặp về ETL
1. Không biết code có học ETL được không?
Có thể bắt đầu, nhưng bạn bắt buộc phải học SQL và Python ở mức cơ bản trong quá trình học. ETL là công việc thiên về kỹ thuật nên không thể tránh hoàn toàn việc viết code.
2. ETL có phải là Data Engineer không?
Không hoàn toàn. ETL chỉ là một phần công việc của Data Engineer, nhưng lại là phần quan trọng nhất. Nắm vững ETL đồng nghĩa với việc bạn đã đi được phần lớn chặng đường để trở thành Data Engineer.
3. Nên học ETL tool nào trước?
Người mới nên bắt đầu theo thứ tự: SQL, Python, sau đó là Airflow và dbt để hiểu cách điều phối và biến đổi dữ liệu. Khi đã vững nền tảng, hãy học tiếp Spark và các hệ thống xử lý dữ liệu quy mô lớn hơn.
4. Học ETL mất bao lâu thì có thể đi làm được?
Với người có nền tảng lập trình cơ bản, học tập trung và thực hành song song bằng project thật, việc nắm vững ETL đủ để ứng tuyển vị trí Data Engineer junior thường mất khoảng 3–6 tháng.
Kết luận
Quy trình ETL không đơn thuần là một khái niệm kỹ thuật mà còn là nền tảng quan trọng trong các hệ thống dữ liệu hiện đại. Hiểu rõ ETL là gì và biết cách xây dựng pipeline dữ liệu thực tế sẽ giúp bạn từng bước phát triển kỹ năng cần thiết để trở thành Data Engineer.
Trong kỷ nguyên dữ liệu, khả năng xây dựng, tối ưu và vận hành ETL pipeline giúp doanh nghiệp khai thác dữ liệu hiệu quả hơn, đồng thời mở ra nhiều cơ hội phát triển cho người làm trong lĩnh vực Data Engineering.
Nếu bạn đang bắt đầu theo đuổi lĩnh vực này, hãy xây dựng nền tảng SQL, Python, xử lý dữ liệu và ETL trước khi tiếp cận các công nghệ nâng cao. Bạn cũng có thể tham khảo khóa học Data Engineer & Big Data tại Cole để tìm hiểu lộ trình học tập và định hướng phát triển kỹ năng phù hợp với mục tiêu nghề nghiệp của mình.
.jpg "Đào tạo Data cho doanh nghiệp: Làm chủ dữ liệu, tối ưu vận hành")