Machine Learning (học máy) là một lĩnh vực của trí tuệ nhân tạo (AI), cho phép máy tính học hỏi từ dữ liệu để nhận diện quy luật và đưa ra dự đoán mà không cần lập trình sẵn từng quy tắc cho mọi tình huống. Công nghệ này đang được ứng dụng trong nhiều lĩnh vực như thương mại điện tử, tài chính, y tế, giáo dục và sản xuất.
Vậy Machine Learning hoạt động như thế nào? Có những loại học máy và thuật toán nào phổ biến? Người mới cần học gì để bắt đầu với lĩnh vực này? Bài viết dưới đây sẽ giúp bạn hiểu rõ từ khái niệm cơ bản đến quy trình xây dựng một mô hình Machine Learning thực tế.
Machine Learning là gì?
Machine Learning (ML), hay học máy, là phương pháp giúp máy tính sử dụng dữ liệu để học các quy luật, từ đó thực hiện dự đoán hoặc đưa ra quyết định trên những dữ liệu mới.
Thay vì phải viết một chương trình với hàng loạt điều kiện cố định, người phát triển cung cấp dữ liệu và lựa chọn thuật toán phù hợp. Mô hình sẽ tìm ra mối quan hệ giữa các thông tin trong dữ liệu thông qua quá trình huấn luyện.
Ví dụ, một cửa hàng thương mại điện tử muốn dự đoán khách hàng có khả năng mua sản phẩm hay không. Thay vì đặt quy tắc thủ công như “khách xem sản phẩm 3 lần thì sẽ mua”, cửa hàng có thể sử dụng dữ liệu lịch sử để huấn luyện mô hình.
Mô hình có thể phân tích các yếu tố như:
Số lần khách hàng truy cập website.
Số sản phẩm đã xem.
Số lần thêm sản phẩm vào giỏ hàng.
Giá trị đơn hàng trước đó.
Tần suất mua sắm.
Sau khi học từ dữ liệu lịch sử, mô hình có thể ước tính khả năng mua hàng của một khách hàng mới.
Những thành phần cơ bản trong Machine Learning
Để hiểu cách Machine Learning hoạt động, trước tiên cần nắm được một số thuật ngữ quan trọng:
| Thuật ngữ | Ý nghĩa | Ví dụ trong dự đoán mua hàng |
|---|---|---|
| Dataset | Tập dữ liệu dùng để xây dựng và đánh giá mô hình | Lịch sử truy cập, giỏ hàng và đơn mua |
| Feature | Đặc trưng đầu vào mà mô hình sử dụng | Số lần truy cập, số sản phẩm đã xem |
| Label | Kết quả mục tiêu cần dự đoán trong học có giám sát | Khách có mua hàng hay không |
| Algorithm | Thuật toán dùng để học quy luật từ dữ liệu | Logistic Regression, Random Forest |
| Model | Mô hình được tạo ra sau quá trình huấn luyện | Mô hình dự đoán khả năng mua hàng |
Có thể hiểu đơn giản: Feature là thông tin đầu vào, Label là kết quả cần dự đoán, Algorithm là phương pháp học và Model là sản phẩm thu được sau khi huấn luyện.
Machine Learning hoạt động như thế nào?
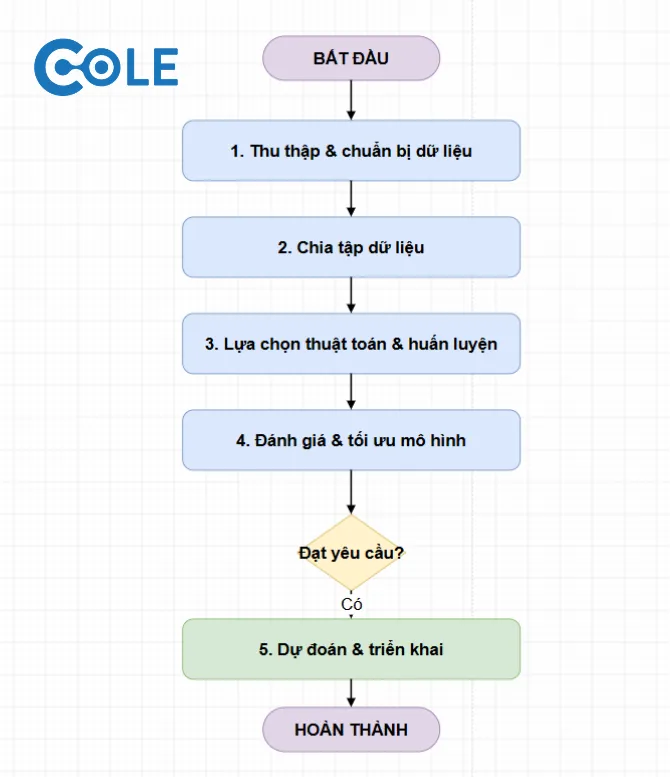
Một quy trình Machine Learning cơ bản thường bao gồm các bước từ thu thập dữ liệu, xử lý, huấn luyện đến đánh giá và triển khai mô hình.
Bước 1: Thu thập và chuẩn bị dữ liệu
Dữ liệu là nền tảng của Machine Learning. Nguồn dữ liệu có thể đến từ hệ thống bán hàng, website, ứng dụng, cảm biến, khảo sát hoặc các cơ sở dữ liệu doanh nghiệp.
Sau khi thu thập, dữ liệu cần được kiểm tra và xử lý. Những công việc thường gặp gồm loại bỏ bản ghi trùng lặp, xử lý dữ liệu thiếu, chuẩn hóa định dạng và chuyển đổi dữ liệu dạng chữ thành dạng số khi cần thiết.
Chẳng hạn, dữ liệu khách hàng có thể chứa các trường như độ tuổi, số lần truy cập, số sản phẩm đã xem và trạng thái mua hàng. Các trường thông tin này cần được chuẩn bị phù hợp trước khi đưa vào mô hình.
Bước 2: Chia dữ liệu thành các tập huấn luyện và đánh giá
Không nên sử dụng toàn bộ dữ liệu để huấn luyện rồi đánh giá mô hình trên chính dữ liệu đó. Cách làm này có thể khiến kết quả đánh giá không phản ánh đúng khả năng dự đoán trên dữ liệu mới.
Thông thường, dữ liệu được chia thành ba tập:
| Tập dữ liệu | Mục đích |
|---|---|
| Training set | Dùng để huấn luyện mô hình và học các quy luật từ dữ liệu |
| Validation set | Dùng để đánh giá trong quá trình phát triển và điều chỉnh mô hình |
| Test set | Dùng để đánh giá cuối cùng trên dữ liệu mô hình chưa từng sử dụng |
Một cách chia minh họa là 70% dữ liệu cho Training, 15% cho Validation và 15% cho Test. Tuy nhiên, tỷ lệ phù hợp còn phụ thuộc vào quy mô, đặc điểm và mục tiêu của từng bộ dữ liệu.
Với dữ liệu theo thời gian, chẳng hạn lịch sử giao dịch, cần cân nhắc chia theo thứ tự thời gian thay vì xáo trộn ngẫu nhiên để tránh sử dụng thông tin tương lai khi dự đoán quá khứ.
Bước 3: Lựa chọn thuật toán và huấn luyện mô hình
Sau khi chuẩn bị dữ liệu, người phát triển lựa chọn thuật toán phù hợp với bài toán.
Ví dụ:
Linear Regression: dự đoán một giá trị liên tục như doanh thu.
Logistic Regression: phân loại khách hàng có khả năng mua hàng hay không.
Decision Tree: phân loại hoặc dự đoán dựa trên các điều kiện phân nhánh.
K-Means: phân nhóm khách hàng theo đặc điểm tương đồng.
Trong quá trình huấn luyện, thuật toán phân tích dữ liệu đầu vào để tìm ra các mối quan hệ và điều chỉnh tham số của mô hình nhằm giảm sai số dự đoán.
Bước 4: Đánh giá và tối ưu mô hình
Sau khi huấn luyện, mô hình cần được đánh giá bằng dữ liệu chưa dùng để huấn luyện. Một số chỉ số thường gặp gồm:
| Chỉ số | Ý nghĩa |
|---|---|
| Accuracy | Tỷ lệ dự đoán đúng trên tổng số dự đoán |
| Precision | Trong số trường hợp mô hình dự đoán là dương tính, có bao nhiêu trường hợp thực sự dương tính |
| Recall | Trong số trường hợp thực sự dương tính, mô hình phát hiện được bao nhiêu |
| F1-score | Trung bình điều hòa giữa Precision và Recall |
| MAE / MSE | Đo mức độ sai lệch giữa giá trị dự đoán và giá trị thực tế trong bài toán hồi quy |
Không phải bài toán nào cũng phù hợp với Accuracy. Ví dụ, khi phát hiện giao dịch gian lận có tỷ lệ rất thấp, một mô hình dự đoán tất cả giao dịch đều hợp lệ vẫn có thể đạt Accuracy cao nhưng gần như không phát hiện được gian lận. Khi đó, Precision, Recall và F1-score có thể cung cấp góc nhìn hữu ích hơn.
Bước 5: Dự đoán và triển khai
Khi mô hình đạt chất lượng phù hợp, doanh nghiệp có thể tích hợp nó vào website, ứng dụng hoặc hệ thống nội bộ để xử lý dữ liệu mới.
Ví dụ, hệ thống thương mại điện tử có thể sử dụng mô hình để dự đoán khả năng mua hàng, hỗ trợ cá nhân hóa gợi ý sản phẩm hoặc xác định nhóm khách hàng cần được chăm sóc.
Mô hình không tự động trở nên chính xác hơn chỉ vì có thêm dữ liệu. Doanh nghiệp cần theo dõi hiệu suất, kiểm tra dữ liệu mới và thực hiện huấn luyện lại khi cần thiết.
Các loại Machine Learning phổ biến
Machine Learning thường được phân thành bốn nhóm chính dựa trên cách mô hình tiếp nhận dữ liệu và học hỏi.
1. Supervised Learning – Học có giám sát
Supervised Learning là phương pháp huấn luyện mô hình bằng dữ liệu đã có nhãn (Label). Mỗi mẫu dữ liệu đầu vào đi kèm với một kết quả đúng để mô hình học cách dự đoán.
Ví dụ, ngân hàng sử dụng dữ liệu giao dịch đã được phân loại để xây dựng mô hình nhận diện giao dịch có dấu hiệu gian lận. Mô hình học từ các đặc trưng của giao dịch và nhãn tương ứng để dự đoán những trường hợp mới.
Hai dạng bài toán phổ biến:
Classification (phân loại): dự đoán một đối tượng thuộc nhóm nào, chẳng hạn email spam hay không spam.
Regression (hồi quy): dự đoán một giá trị liên tục, chẳng hạn giá nhà hoặc doanh thu.
2. Unsupervised Learning – Học không giám sát
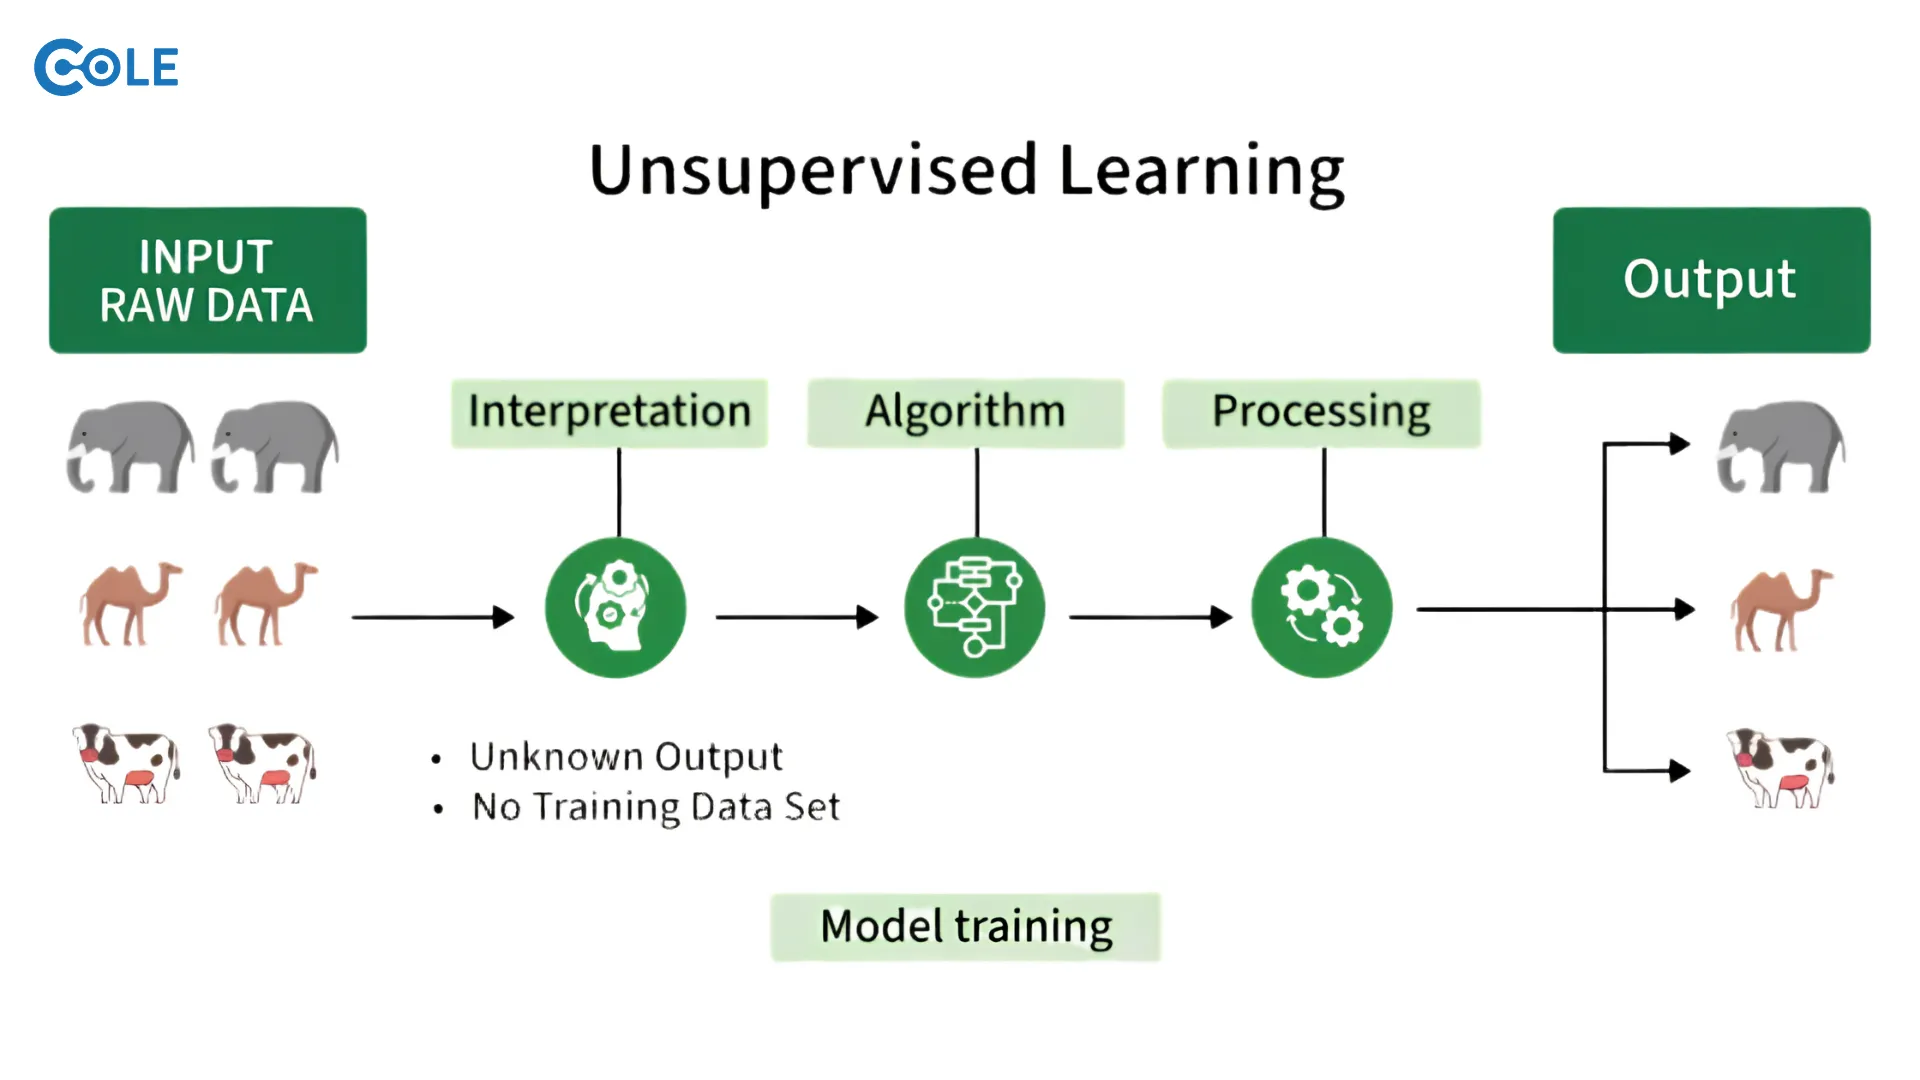
Unsupervised Learning sử dụng dữ liệu chưa có nhãn. Mô hình tự tìm kiếm cấu trúc, mối quan hệ hoặc nhóm dữ liệu có đặc điểm tương đồng.
Ví dụ, một doanh nghiệp bán lẻ có thể phân tích lịch sử mua hàng để chia khách hàng thành các nhóm dựa trên tần suất mua, giá trị đơn hàng và loại sản phẩm thường lựa chọn.
Một số kỹ thuật phổ biến gồm:
Clustering: phân cụm dữ liệu.
Dimensionality Reduction: giảm số chiều dữ liệu.
Anomaly Detection: phát hiện các điểm dữ liệu bất thường.
3. Semi-supervised Learning – Học bán giám sát
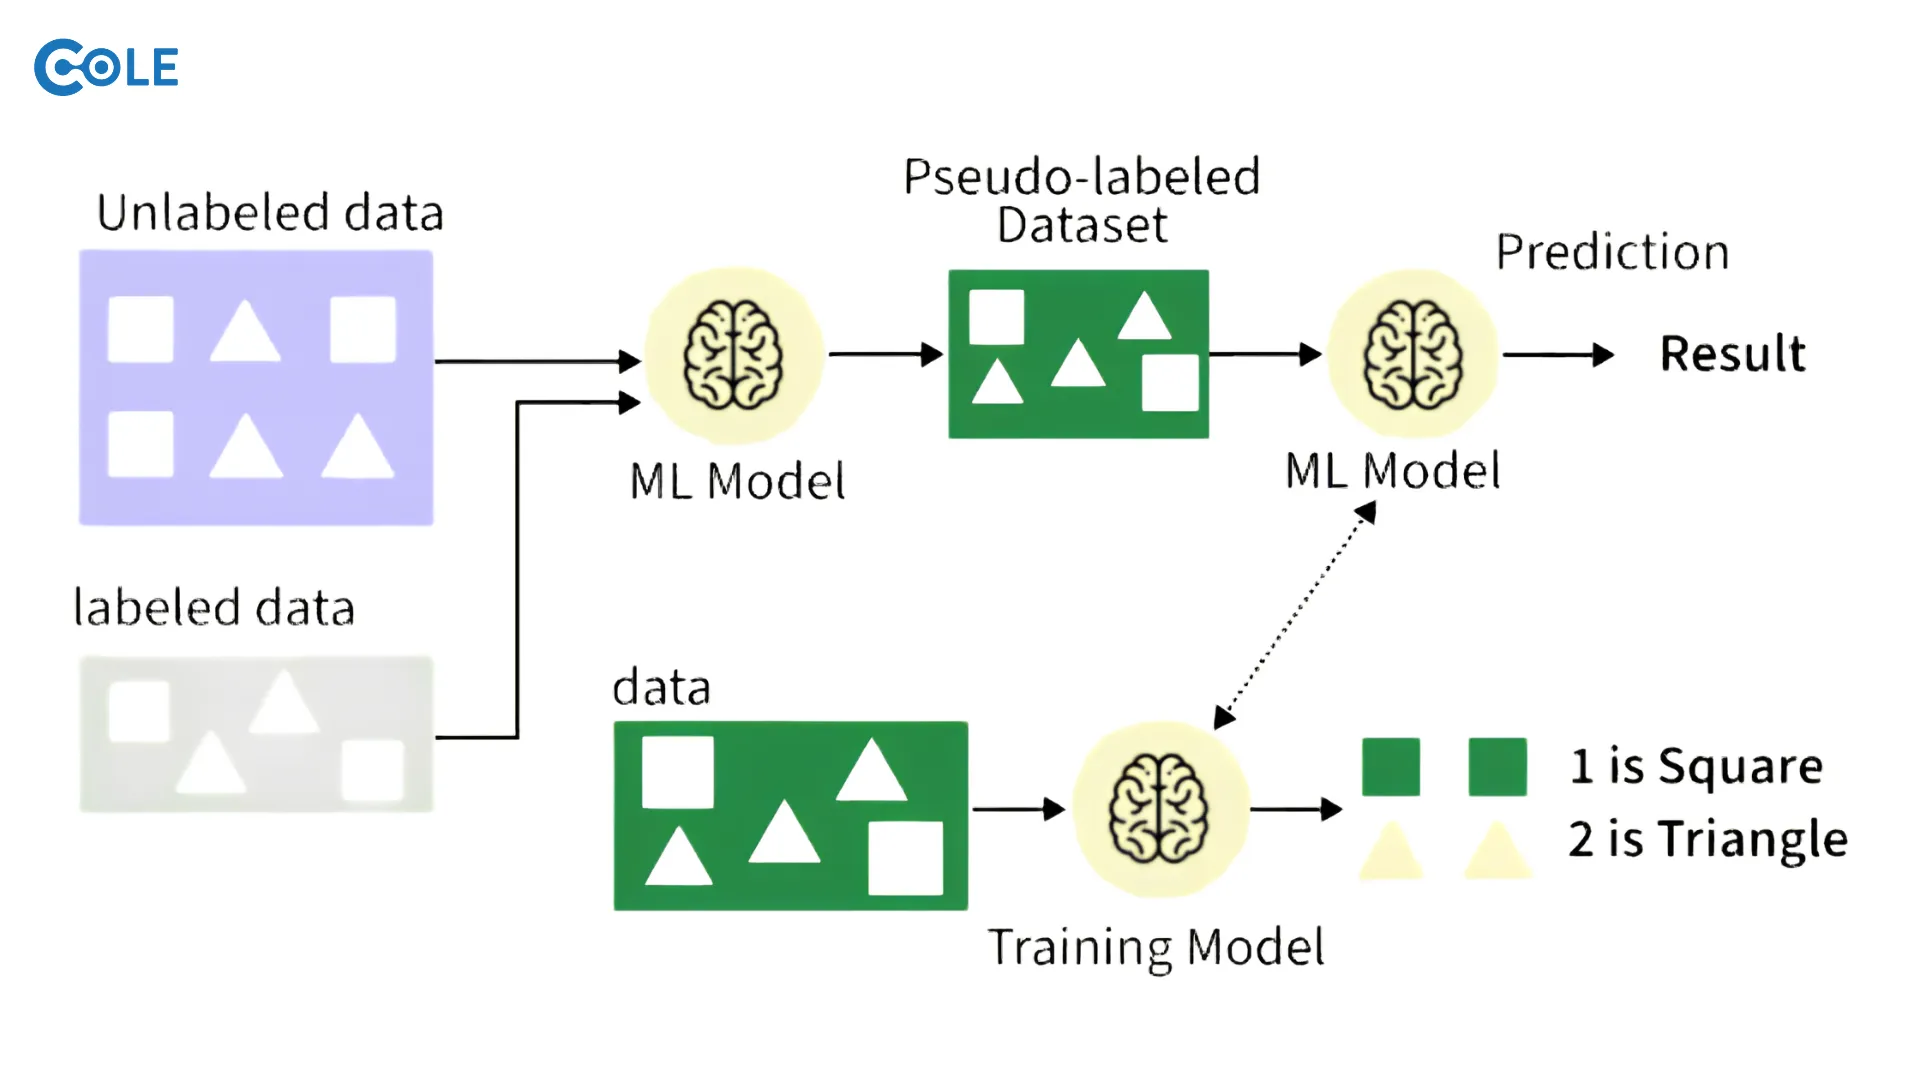
Semi-supervised Learning kết hợp một lượng nhỏ dữ liệu có nhãn với lượng lớn dữ liệu chưa có nhãn để huấn luyện mô hình.
Phương pháp này hữu ích khi việc gán nhãn dữ liệu tốn nhiều thời gian hoặc chi phí. Ví dụ, doanh nghiệp có hàng nghìn hình ảnh sản phẩm nhưng chỉ một phần nhỏ được chuyên gia phân loại thủ công.
Mô hình có thể tận dụng cả dữ liệu đã gán nhãn và dữ liệu chưa gán nhãn để cải thiện khả năng học.
4. Reinforcement Learning – Học tăng cường
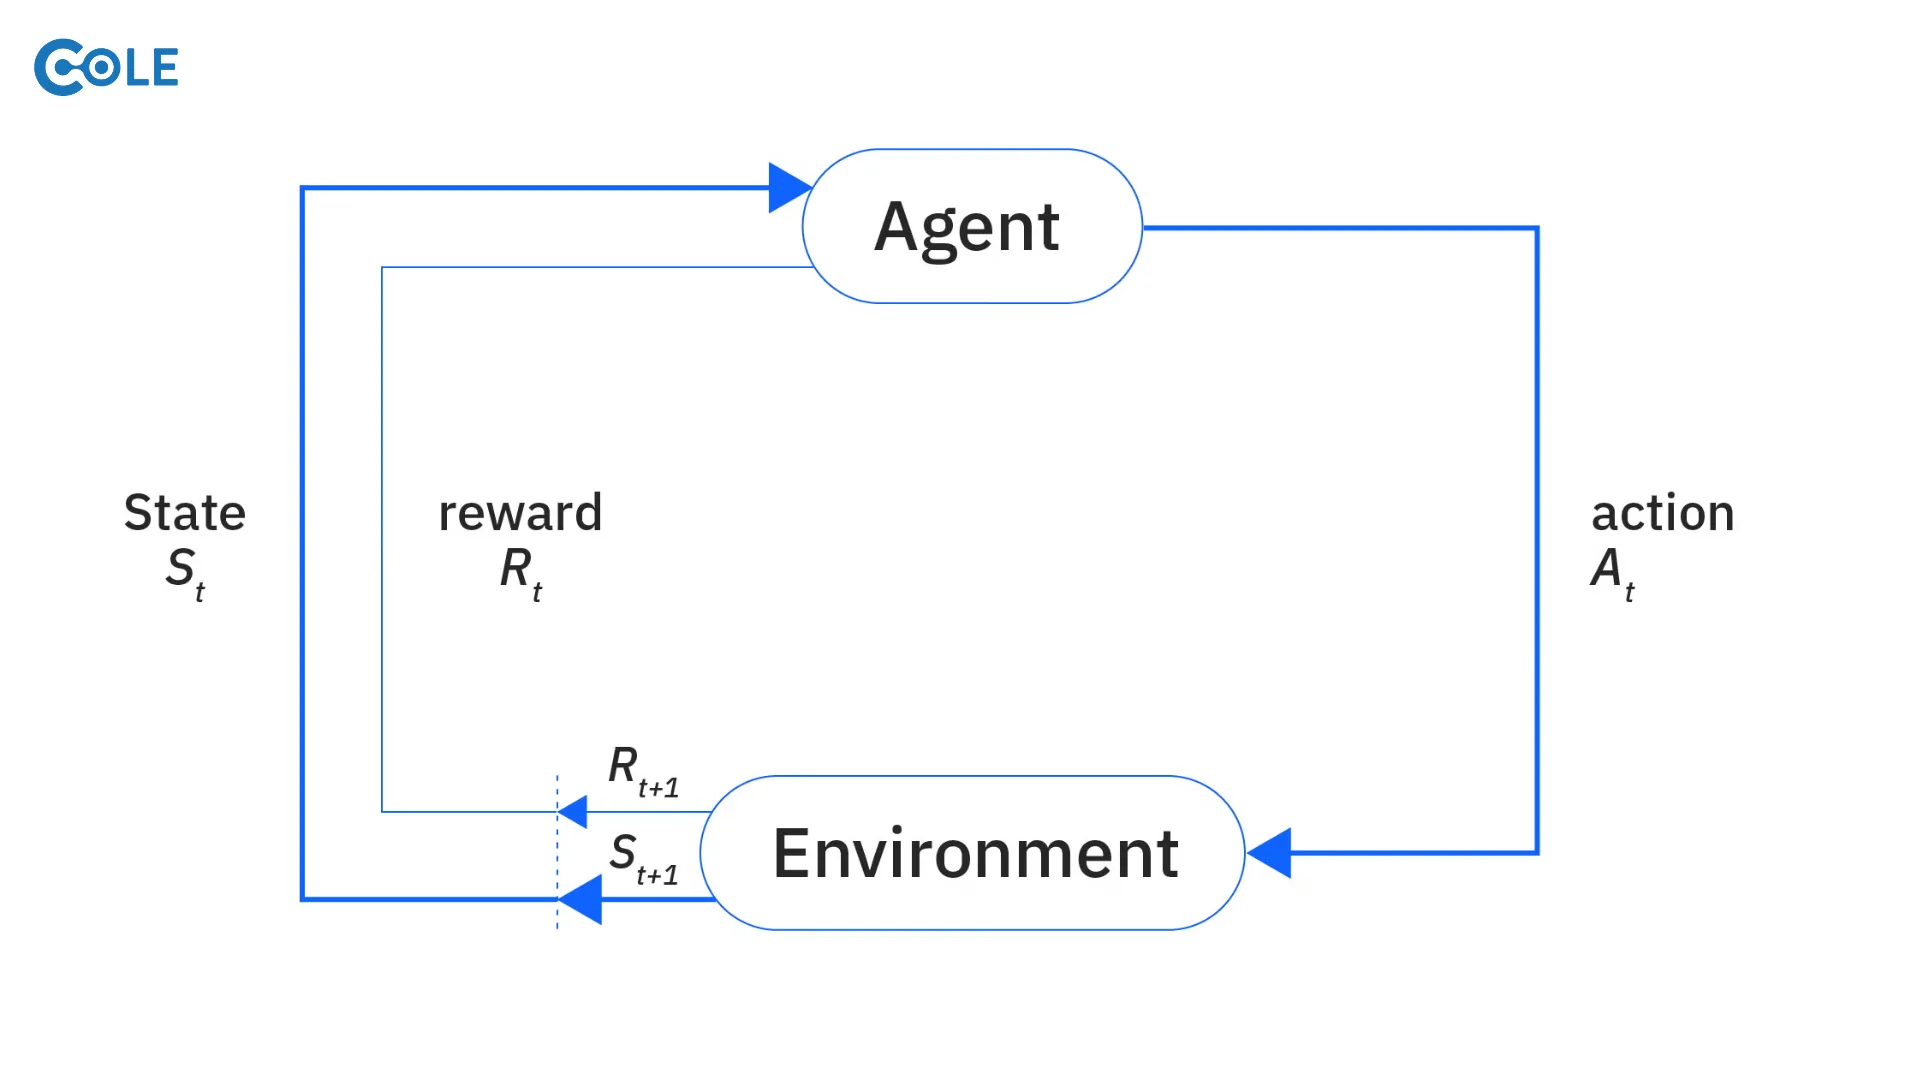
Reinforcement Learning là phương pháp để một tác nhân (Agent) học cách đưa ra hành động thông qua tương tác với môi trường. Sau mỗi hành động, Agent nhận được phần thưởng hoặc hình phạt và điều chỉnh chiến lược nhằm tối đa hóa tổng phần thưởng theo thời gian.
Ví dụ, một chương trình điều khiển robot có thể thử nhiều cách di chuyển. Những hành động giúp robot tiến gần mục tiêu được ghi nhận bằng phần thưởng, trong khi hành động gây va chạm có thể nhận hình phạt.
Reinforcement Learning thường được nghiên cứu trong robot, trò chơi, tối ưu hóa điều khiển và một số hệ thống ra quyết định.
Bảng so sánh các loại Machine Learning
| Loại học máy | Dữ liệu sử dụng | Mục tiêu | Ví dụ |
|---|---|---|---|
| Supervised Learning | Có nhãn | Dự đoán kết quả | Phân loại email spam |
| Unsupervised Learning | Không có nhãn | Tìm cấu trúc dữ liệu | Phân nhóm khách hàng |
| Semi-supervised Learning | Ít dữ liệu có nhãn, nhiều dữ liệu chưa nhãn | Tận dụng dữ liệu chưa gán nhãn | Phân loại hình ảnh |
| Reinforcement Learning | Tương tác và phần thưởng | Tìm chiến lược hành động | Robot học cách di chuyển |
Ngoài bốn nhóm trên, Self-supervised Learning (học tự giám sát) cũng rất quan trọng trong các hệ thống AI hiện đại. Phương pháp này tạo tín hiệu huấn luyện từ chính dữ liệu, thay vì phụ thuộc hoàn toàn vào nhãn do con người gán. Nhiều mô hình ngôn ngữ lớn hiện nay sử dụng các kỹ thuật tự giám sát trong quá trình tiền huấn luyện.
Các thuật toán Machine Learning phổ biến
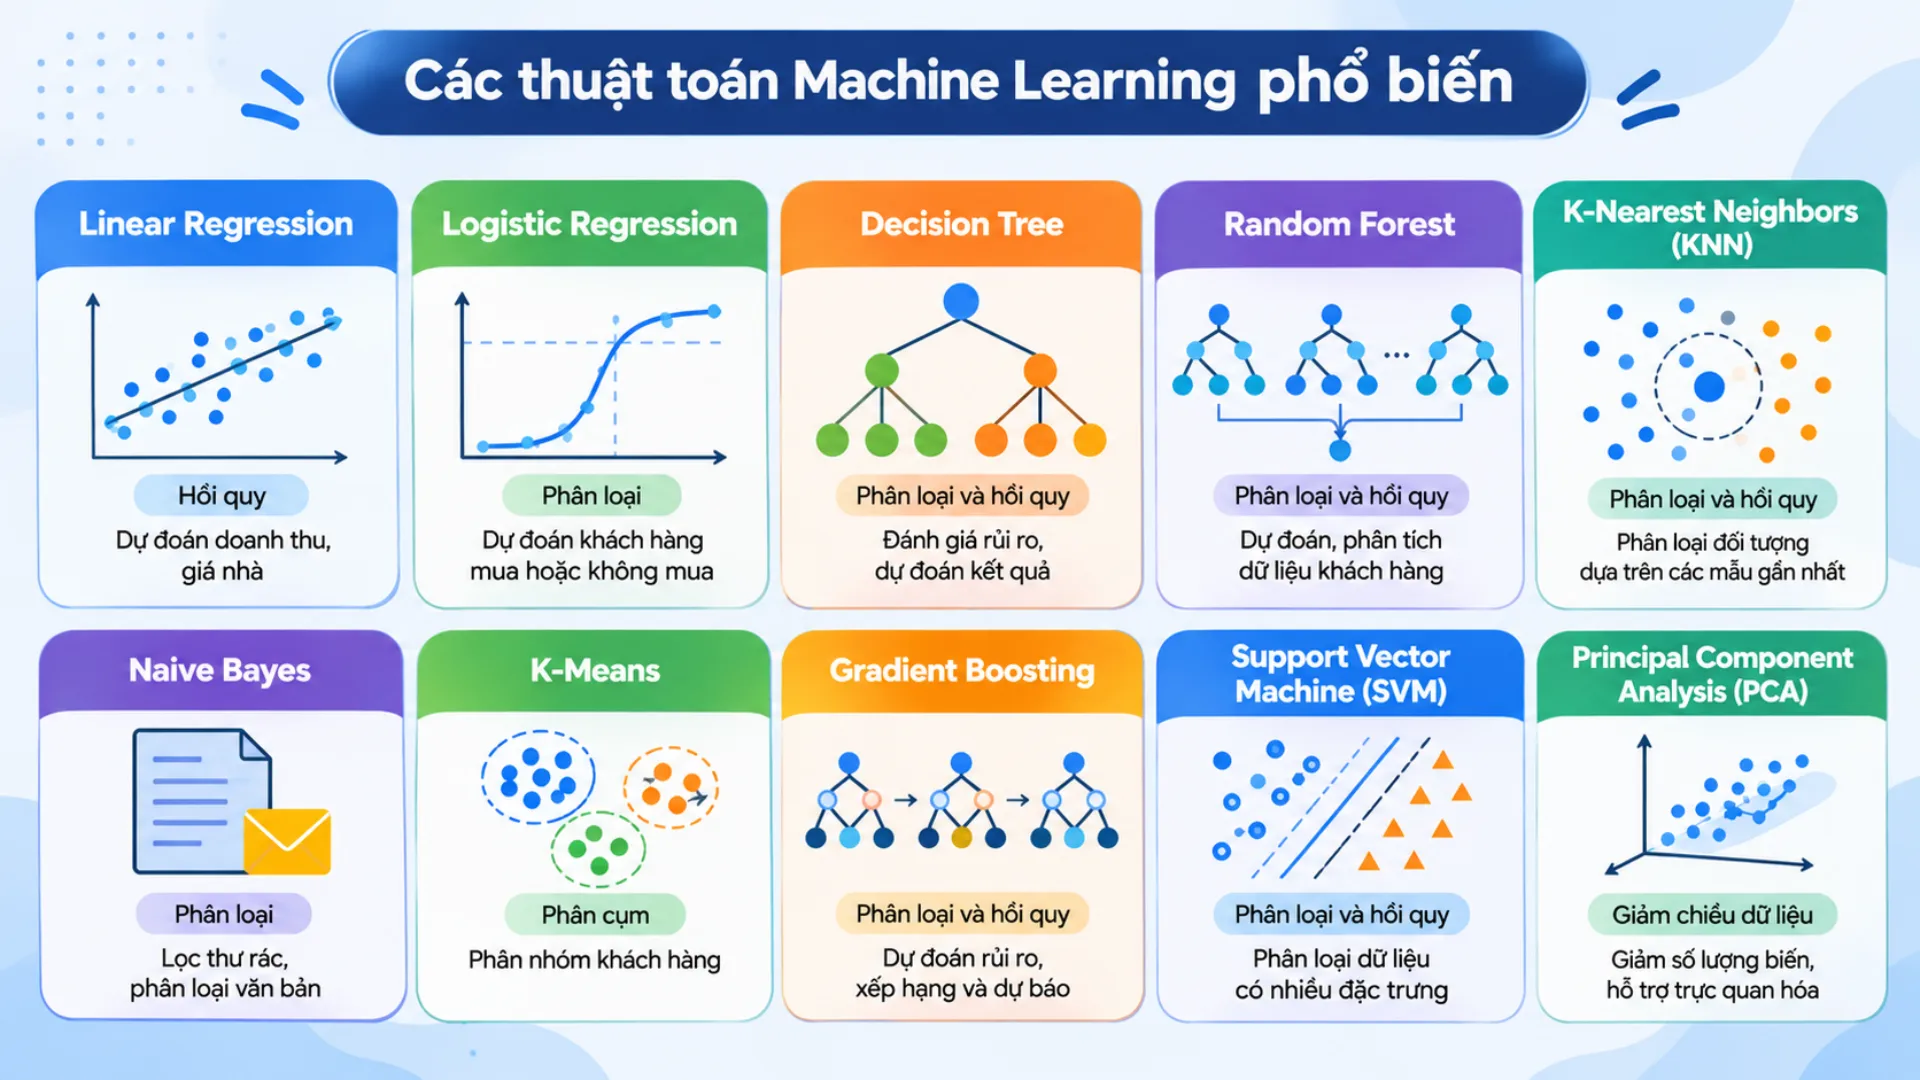
Thuật toán Machine Learning là phương pháp giúp mô hình học quy luật từ dữ liệu. Mỗi thuật toán có cách hoạt động, ưu điểm và phạm vi ứng dụng riêng.
| Thuật toán | Nhóm bài toán thường gặp | Ứng dụng |
|---|---|---|
| Linear Regression | Hồi quy | Dự đoán doanh thu, giá nhà |
| Logistic Regression | Phân loại | Dự đoán khách hàng mua hoặc không mua |
| Decision Tree | Phân loại và hồi quy | Đánh giá rủi ro, dự đoán kết quả |
| Random Forest | Phân loại và hồi quy | Dự đoán, phân tích dữ liệu khách hàng |
| K-Nearest Neighbors (KNN) | Phân loại và hồi quy | Phân loại đối tượng dựa trên các mẫu gần nhất |
| Naive Bayes | Phân loại | Lọc thư rác, phân loại văn bản |
| K-Means | Phân cụm | Phân nhóm khách hàng |
| Gradient Boosting | Phân loại và hồi quy | Dự đoán rủi ro, xếp hạng và dự báo |
| Support Vector Machine (SVM) | Phân loại và hồi quy | Phân loại dữ liệu có nhiều đặc trưng |
| Principal Component Analysis (PCA) | Giảm chiều dữ liệu | Giảm số lượng biến, hỗ trợ trực quan hóa |
Một số thuật toán tiêu biểu
Linear Regression (Hồi quy tuyến tính)
Linear Regression được sử dụng để dự đoán giá trị liên tục dựa trên mối quan hệ giữa các biến đầu vào và biến mục tiêu.
Công thức đơn giản:
[ y = ax + b ]
Trong đó:
(y): giá trị cần dự đoán.
(x): biến đầu vào.
(a): hệ số thể hiện mức độ thay đổi của (y) theo (x).
(b): hằng số.
Ví dụ, doanh nghiệp có thể sử dụng số tiền quảng cáo để ước tính doanh thu. Trong thực tế, bài toán có thể cần nhiều biến đầu vào hơn một biến duy nhất.
Logistic Regression (Hồi quy Logistic)
Mặc dù có tên là hồi quy, Logistic Regression thường được sử dụng cho bài toán phân loại. Thuật toán ước tính xác suất một mẫu thuộc về một lớp, sau đó sử dụng ngưỡng phù hợp để đưa ra kết quả phân loại.
Ví dụ, mô hình dự đoán xác suất một khách hàng mua sản phẩm là 0,8. Nếu ngưỡng phân loại được đặt ở 0,5, mô hình sẽ xếp khách hàng vào nhóm có khả năng mua.
Decision Tree (Cây quyết định)
Decision Tree mô phỏng quá trình ra quyết định bằng các nhánh điều kiện. Mỗi nút thể hiện một điều kiện, mỗi nhánh là kết quả của điều kiện và nút lá đưa ra dự đoán cuối cùng.
Ví dụ, mô hình có thể phân loại khách hàng dựa trên số lần truy cập, lịch sử mua hàng và giá trị giỏ hàng.
Random Forest (Rừng ngẫu nhiên)
Random Forest kết hợp nhiều cây quyết định thay vì chỉ sử dụng một cây duy nhất. Kết quả dự đoán được tổng hợp từ các cây, giúp mô hình thường ổn định hơn so với một cây quyết định đơn lẻ.
Thuật toán này có thể xử lý cả bài toán phân loại và hồi quy.
K-Means
K-Means là thuật toán phân cụm, giúp chia dữ liệu thành một số nhóm dựa trên mức độ tương đồng. Người sử dụng cần xác định số cụm (K) trước khi huấn luyện trong phiên bản cơ bản của thuật toán.
Ví dụ, doanh nghiệp có thể phân nhóm khách hàng thành các cụm dựa trên mức chi tiêu và tần suất mua hàng để xây dựng chiến dịch marketing phù hợp.
Gradient Boosting
Gradient Boosting xây dựng mô hình theo từng bước, trong đó các mô hình mới tập trung cải thiện những sai số mà các mô hình trước đó mắc phải.
Các thư viện như XGBoost, LightGBM và CatBoost là những công cụ phổ biến thuộc họ thuật toán này, được sử dụng trong nhiều bài toán dự đoán trên dữ liệu dạng bảng.
PCA (Principal Component Analysis)
PCA là kỹ thuật giảm chiều dữ liệu, giúp chuyển đổi tập hợp nhiều biến thành một số thành phần mới, đồng thời cố gắng giữ lại phần lớn phương sai của dữ liệu.
PCA thường được sử dụng để hỗ trợ trực quan hóa, giảm độ phức tạp dữ liệu và phục vụ các bước xử lý trước khi huấn luyện mô hình.
Ví dụ Machine Learning bằng Python
Để hình dung rõ hơn cách triển khai, có thể sử dụng Python và thư viện Scikit-learn để xây dựng một mô hình phân loại đơn giản.
Ví dụ dưới đây mô phỏng bài toán dự đoán một khách hàng có thuộc nhóm mua hàng hay không. Dữ liệu được tạo giả lập để minh họa quy trình, không phải dữ liệu giao dịch thực tế của doanh nghiệp.
from sklearn.datasets import make_classification
from sklearn.model_selection import train_test_split
from sklearn.pipeline import make_pipeline
from sklearn.preprocessing import StandardScaler
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import accuracy_score, classification_report
# Tạo dữ liệu giả lập cho bài toán phân loại
X, y = make_classification(
    n_samples=1000,
    n_features=5,
    n_informative=3,
    n_redundant=0,
    random_state=42
)
# Chia dữ liệu thành tập huấn luyện và kiểm tra
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.2, random_state=42, stratify=y
)
# Xây dựng quy trình chuẩn hóa và huấn luyện mô hình
model = make_pipeline(
    StandardScaler(),
    LogisticRegression()
)
model.fit(X_train, y_train)
# Dự đoán trên dữ liệu kiểm tra
y_pred = model.predict(X_test)
# Đánh giá kết quả
print("Accuracy:", accuracy_score(y_test, y_pred))
print(classification_report(y_test, y_pred))
Trong ví dụ này, quy trình được thực hiện như sau:
make_classification() tạo dữ liệu giả lập cho bài toán phân loại.
train_test_split() chia dữ liệu thành tập huấn luyện và tập kiểm tra.
StandardScaler() chuẩn hóa dữ liệu đầu vào.
LogisticRegression() xây dựng mô hình phân loại.
model.fit() huấn luyện mô hình từ dữ liệu huấn luyện.
model.predict() dự đoán kết quả trên dữ liệu kiểm tra.
accuracy_score() và classification_report() đánh giá hiệu quả dự đoán.
Điểm quan trọng là mô hình không được đánh giá trên chính dữ liệu đã dùng để huấn luyện. Trong một dự án thực tế, người phát triển còn cần kiểm tra chất lượng dữ liệu, lựa chọn đặc trưng phù hợp, điều chỉnh tham số và đánh giá mô hình bằng những chỉ số phù hợp với mục tiêu kinh doanh.
Ứng dụng của Machine Learning trong thực tế
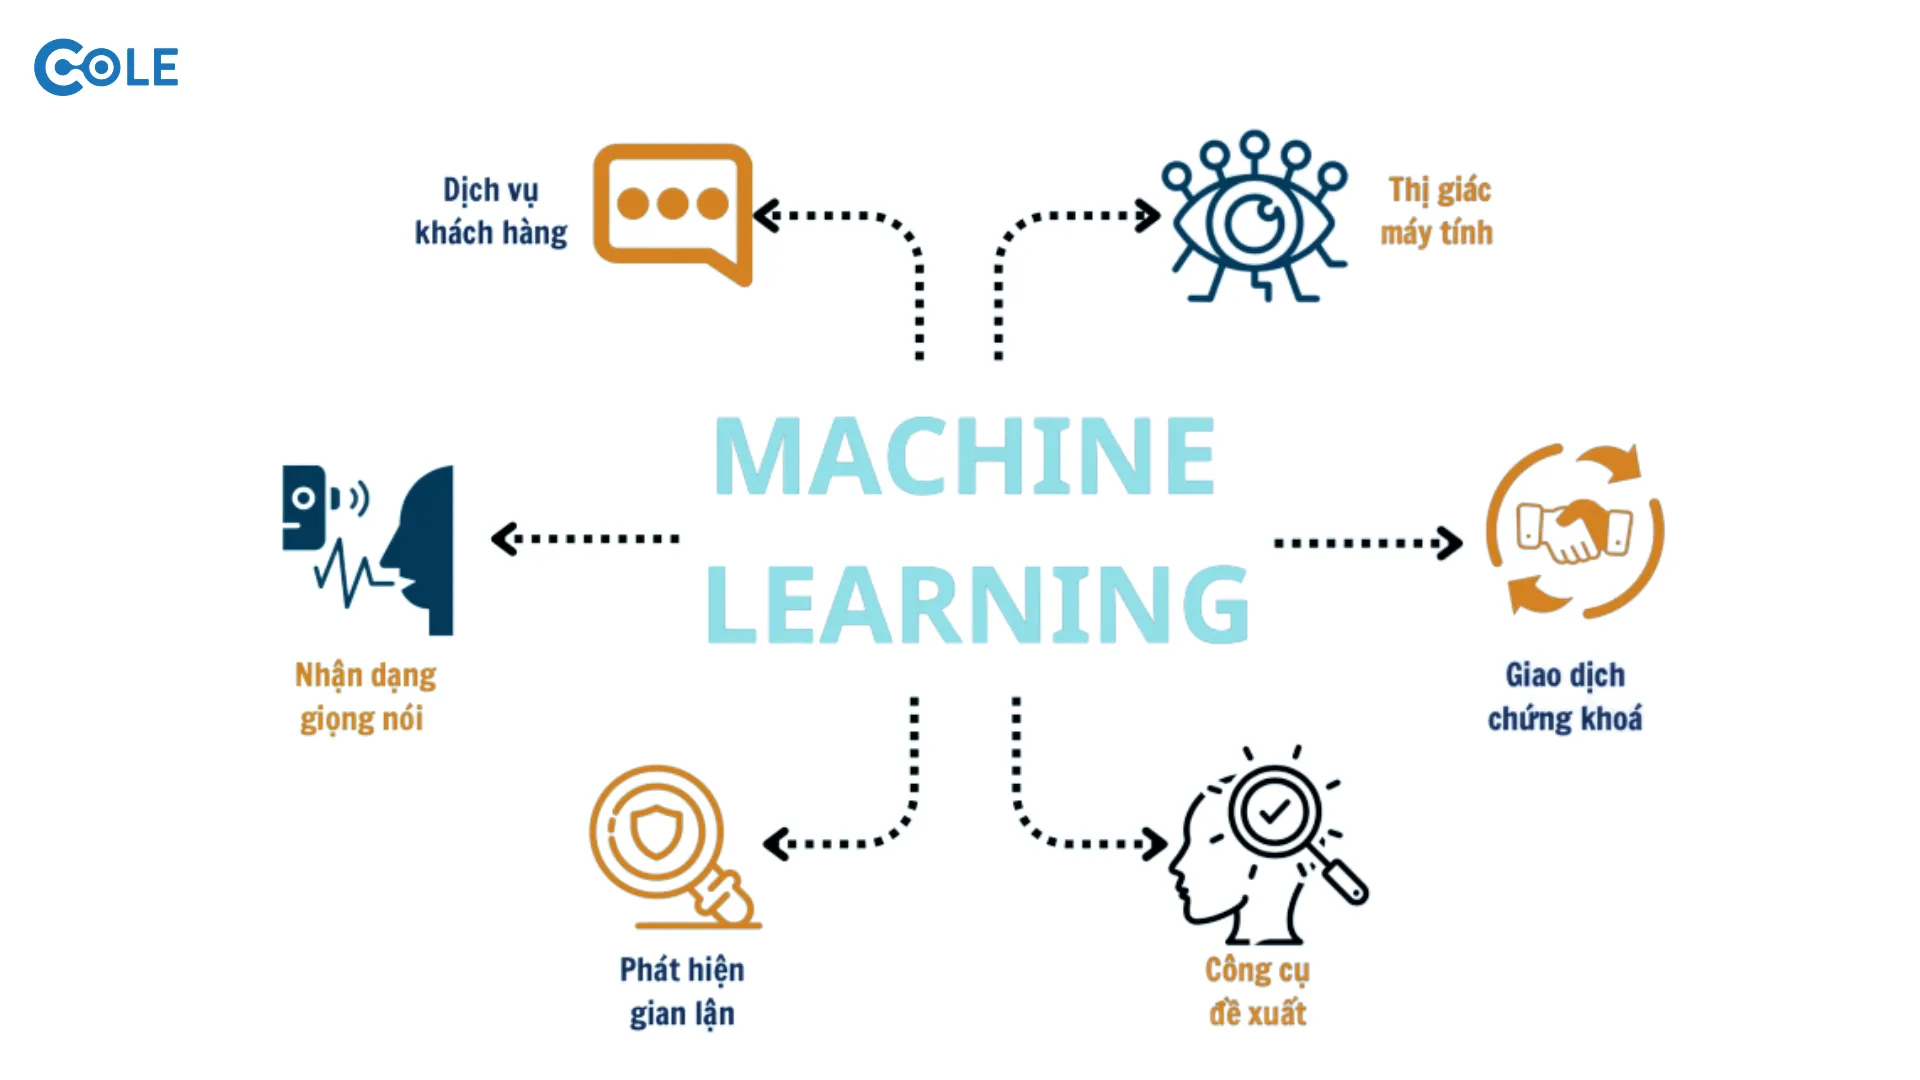
Machine Learning đang được ứng dụng trong nhiều lĩnh vực nhờ khả năng phân tích dữ liệu, nhận diện mẫu và dự đoán xu hướng.
1. Thương mại điện tử và Marketing
Trong thương mại điện tử, Machine Learning hỗ trợ doanh nghiệp phân tích hành vi người dùng và cá nhân hóa trải nghiệm mua sắm.
Một số ứng dụng phổ biến:
Gợi ý sản phẩm dựa trên lịch sử xem và mua hàng.
Dự đoán khả năng khách hàng mua sản phẩm.
Phân nhóm khách hàng theo hành vi.
Dự báo nhu cầu và lượng hàng cần nhập.
Phát hiện các giao dịch có dấu hiệu bất thường.
Ví dụ, khi khách hàng thường xuyên tìm kiếm giày chạy bộ, hệ thống gợi ý có thể ưu tiên hiển thị các sản phẩm cùng danh mục hoặc có đặc điểm tương đồng.
2. Tài chính và ngân hàng
Các tổ chức tài chính sử dụng Machine Learning để phân tích giao dịch, đánh giá rủi ro và hỗ trợ phát hiện hành vi bất thường.
Ví dụ, mô hình có thể phân tích giá trị giao dịch, thời gian, vị trí và lịch sử sử dụng tài khoản để phát hiện giao dịch có dấu hiệu gian lận. Kết quả dự đoán có thể được sử dụng để cảnh báo hoặc chuyển giao dịch sang bước kiểm tra bổ sung.
Machine Learning cũng được ứng dụng trong chấm điểm tín dụng, dự báo rủi ro và hỗ trợ đánh giá khả năng trả nợ. Tuy nhiên, các quyết định tài chính cần có cơ chế kiểm soát, giải thích và tuân thủ quy định liên quan.
3. Y tế
Trong lĩnh vực y tế, Machine Learning có thể hỗ trợ phân tích hình ảnh y khoa, dữ liệu xét nghiệm và hồ sơ bệnh án.
Ví dụ, mô hình thị giác máy tính có thể phân tích ảnh X-quang hoặc ảnh chụp y khoa để phát hiện những dấu hiệu bất thường cần được bác sĩ xem xét.
Công nghệ này đóng vai trò hỗ trợ chuyên môn, không thay thế việc chẩn đoán và quyết định điều trị của nhân viên y tế.
4. Giao thông và vận tải
Machine Learning có thể phân tích dữ liệu về lưu lượng phương tiện, thời gian di chuyển và tình trạng giao thông để dự đoán ùn tắc hoặc hỗ trợ tối ưu tuyến đường.
Ví dụ, ứng dụng bản đồ có thể sử dụng dữ liệu giao thông theo thời gian để ước tính thời gian đến nơi và đề xuất tuyến đường phù hợp hơn.
5. Sản xuất và vận hành
Trong nhà máy, Machine Learning được sử dụng để phân tích dữ liệu từ cảm biến và thiết bị nhằm phát hiện dấu hiệu bất thường.
Một ứng dụng tiêu biểu là bảo trì dự đoán (Predictive Maintenance). Mô hình phân tích nhiệt độ, độ rung và các thông số vận hành để ước tính nguy cơ thiết bị gặp sự cố, từ đó hỗ trợ doanh nghiệp lên kế hoạch bảo trì.
6. Giáo dục
Trong giáo dục, Machine Learning có thể phân tích kết quả học tập, tiến độ và hành vi học tập để hỗ trợ cá nhân hóa nội dung.
Ví dụ, nền tảng học trực tuyến có thể gợi ý bài học phù hợp với trình độ hiện tại hoặc nhận diện những nội dung mà người học thường xuyên gặp khó khăn.
Phân biệt AI, Machine Learning và Deep Learning
AI, Machine Learning và Deep Learning là ba khái niệm có liên quan nhưng không đồng nghĩa.
Artificial Intelligence (AI): lĩnh vực nghiên cứu và phát triển hệ thống có khả năng thực hiện những nhiệm vụ thường cần trí thông minh của con người.
Machine Learning (ML): một nhánh của AI, tập trung vào việc giúp máy tính học từ dữ liệu.
Deep Learning (DL): một nhánh của Machine Learning, sử dụng mạng nơ-ron nhân tạo nhiều lớp để học các đặc trưng phức tạp.
Có thể hình dung mối quan hệ giữa ba khái niệm như sau:
AI bao gồm Machine Learning, còn Deep Learning là một phần của Machine Learning.
| Tiêu chí | AI | Machine Learning | Deep Learning |
|---|---|---|---|
| Phạm vi | Rộng nhất | Một nhánh của AI | Một nhánh của ML |
| Cách tiếp cận | Có thể dựa trên luật, tìm kiếm, suy luận hoặc học từ dữ liệu | Học quy luật từ dữ liệu | Học đặc trưng qua mạng nơ-ron nhiều lớp |
| Dữ liệu | Tùy phương pháp | Thường cần dữ liệu để huấn luyện | Thường cần nhiều dữ liệu và tài nguyên tính toán hơn |
| Ứng dụng | Hệ chuyên gia, trợ lý thông minh, robot | Dự đoán, phân loại, phân cụm | Nhận diện hình ảnh, xử lý giọng nói, mô hình ngôn ngữ |
Không phải mọi hệ thống AI đều sử dụng Machine Learning. Một hệ thống dựa trên các quy tắc được lập trình sẵn vẫn có thể được xem là một dạng AI, dù không học từ dữ liệu theo cách của ML.
Ưu điểm và hạn chế của Machine Learning
Machine Learning giúp xử lý dữ liệu ở quy mô lớn và hỗ trợ tự động hóa nhiều hoạt động. Tuy nhiên, công nghệ này cũng có những giới hạn cần được cân nhắc khi triển khai.
Ưu điểm
Phân tích dữ liệu quy mô lớn: Mô hình có thể xử lý lượng dữ liệu lớn để tìm ra những mối quan hệ khó nhận diện bằng phương pháp thủ công.
Tự động hóa dự đoán: Sau khi được huấn luyện và triển khai, mô hình có thể tiếp nhận dữ liệu mới để đưa ra dự đoán mà không cần con người xử lý từng trường hợp.
Cá nhân hóa trải nghiệm: Machine Learning hỗ trợ phân tích hành vi để đề xuất sản phẩm, nội dung hoặc dịch vụ phù hợp hơn với từng nhóm người dùng.
Cải thiện theo quy trình huấn luyện: Khi có dữ liệu phù hợp và được huấn luyện, đánh giá lại đúng cách, mô hình có thể được cải thiện để thích ứng với những thay đổi của bài toán.
Hạn chế
Phụ thuộc vào chất lượng dữ liệu: Dữ liệu thiếu, sai lệch hoặc không đại diện có thể khiến mô hình đưa ra dự đoán không chính xác.
Chi phí triển khai: Một số bài toán yêu cầu hạ tầng lưu trữ, năng lực tính toán và đội ngũ chuyên môn, làm tăng chi phí phát triển.
Khó giải thích kết quả: Những mô hình phức tạp, đặc biệt là Deep Learning, có thể khó giải thích vì sao đưa ra một dự đoán cụ thể.
Nguy cơ thiên lệch: Nếu dữ liệu huấn luyện chứa định kiến hoặc không đại diện cho các nhóm đối tượng, mô hình có thể tạo ra kết quả thiếu công bằng.
Không phù hợp với mọi bài toán: Với những vấn đề có quy tắc rõ ràng, dữ liệu ít hoặc không cần dự đoán, một chương trình dựa trên luật có thể đơn giản và hiệu quả hơn.
Underfitting và Overfitting trong Machine Learning là gì?
Trong quá trình huấn luyện, mô hình có thể gặp hai vấn đề phổ biến là Underfitting và Overfitting. Đây là những nguyên nhân khiến khả năng dự đoán trên dữ liệu mới không đạt kỳ vọng.
Underfitting – Mô hình chưa học đủ
Underfitting xảy ra khi mô hình quá đơn giản hoặc chưa học được những quy luật quan trọng trong dữ liệu. Vì vậy, kết quả dự đoán thường kém cả trên dữ liệu huấn luyện lẫn dữ liệu mới.
Ví dụ, doanh nghiệp muốn dự đoán doanh thu dựa trên nhiều yếu tố như ngân sách quảng cáo, mùa vụ và số lượng khách hàng. Nhưng mô hình chỉ sử dụng một biến đầu vào đơn giản, khiến kết quả không phản ánh được mối quan hệ thực tế.
Một số cách khắc phục:
Lựa chọn mô hình có khả năng biểu diễn phù hợp hơn.
Bổ sung những đặc trưng có giá trị.
Huấn luyện mô hình đủ lâu nếu thuật toán cần nhiều vòng học.
Giảm mức độ điều chuẩn khi mô hình đang bị ràng buộc quá mạnh.
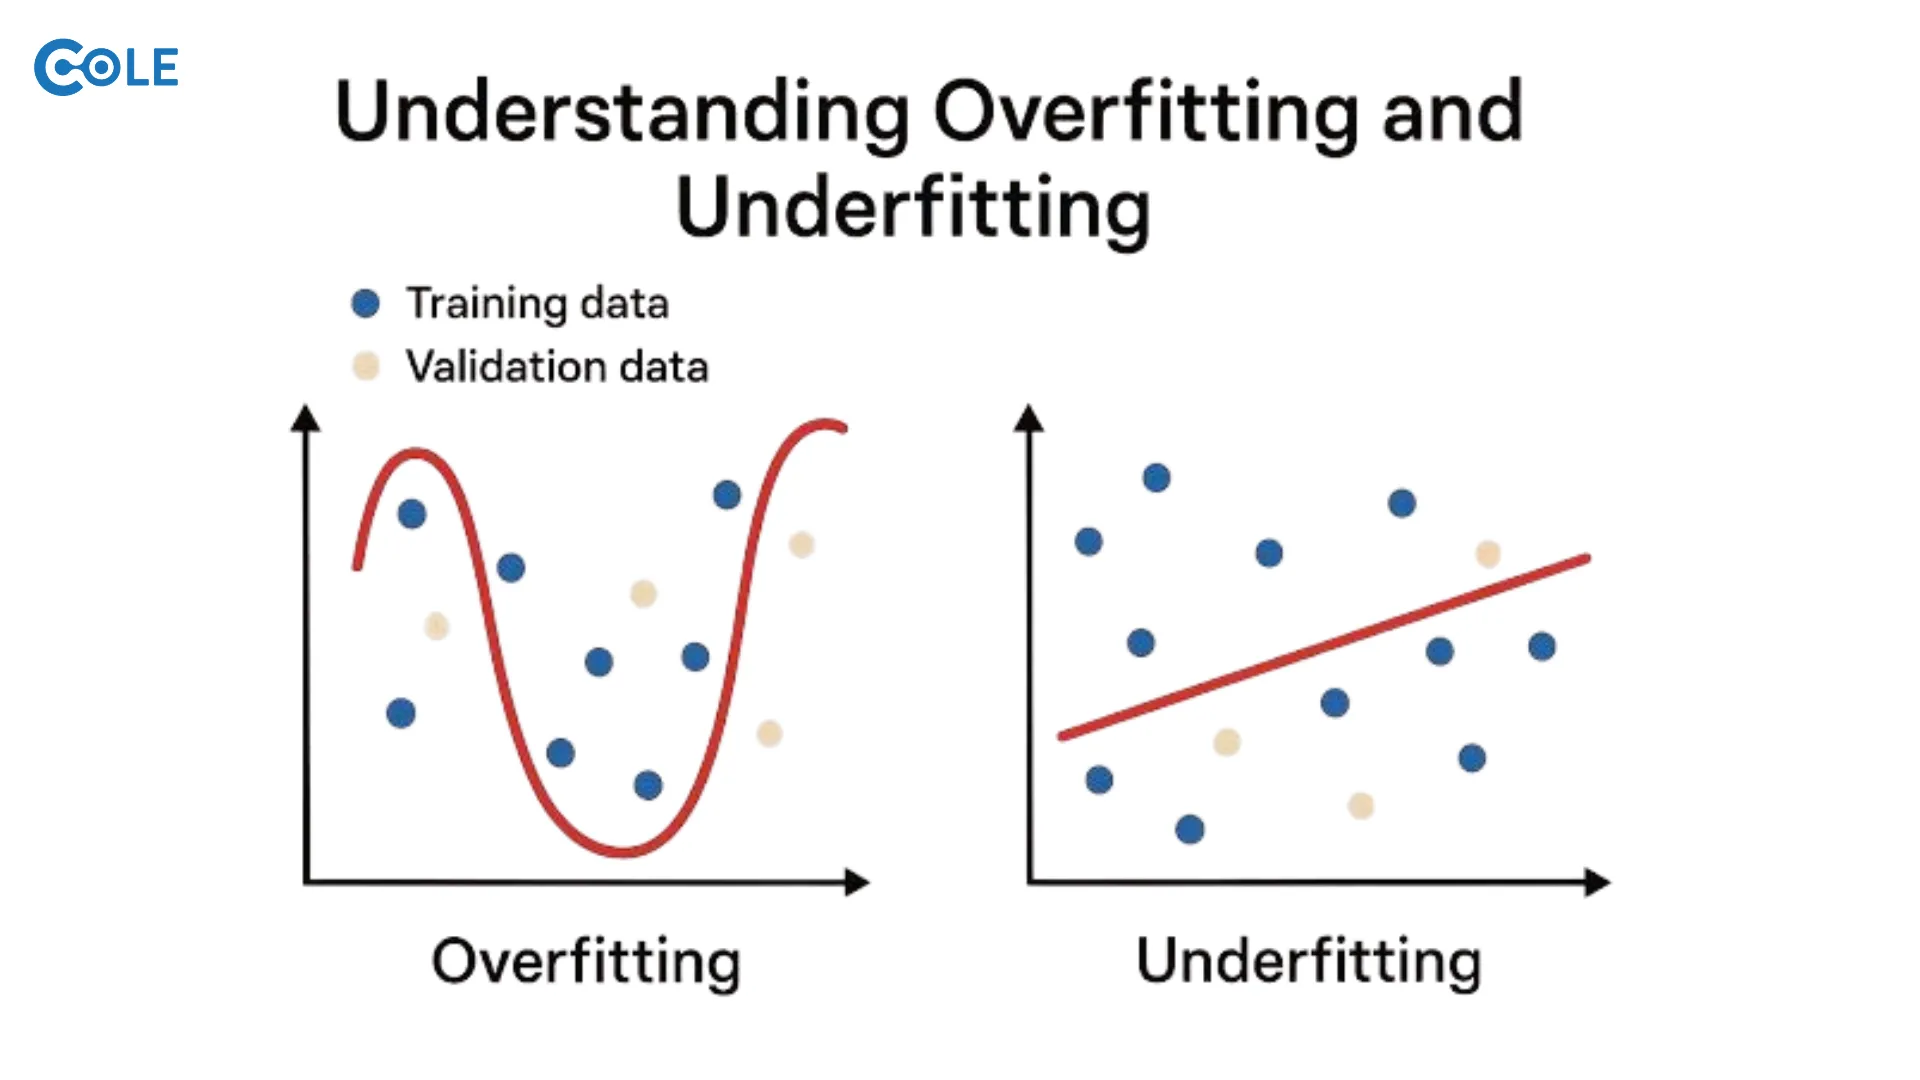
Overfitting – Mô hình học quá sát dữ liệu huấn luyện
Overfitting xảy ra khi mô hình ghi nhớ quá nhiều chi tiết hoặc nhiễu trong dữ liệu huấn luyện, dẫn đến kết quả tốt trên tập huấn luyện nhưng kém trên dữ liệu mới.
Ví dụ, mô hình dự đoán khách hàng mua hàng có thể học thuộc những đặc điểm riêng của nhóm khách hàng trong dữ liệu cũ, nhưng lại không dự đoán tốt khi gặp khách hàng mới có hành vi khác biệt.
Một số cách hạn chế Overfitting:
Bổ sung dữ liệu huấn luyện có chất lượng và tính đại diện.
Giảm độ phức tạp của mô hình.
Sử dụng Regularization như L1 hoặc L2.
Áp dụng Cross-validation để đánh giá ổn định hơn.
Sử dụng Early Stopping khi huấn luyện các mô hình có quá trình học theo vòng lặp.
Kiểm tra hiện tượng rò rỉ dữ liệu (Data Leakage).
Bias và Variance là gì?
Bias và Variance là hai khái niệm giúp giải thích vì sao mô hình có thể dự đoán chưa tốt.
Bias cao: mô hình có giả định quá đơn giản, khó nắm bắt quy luật của dữ liệu, thường liên quan đến Underfitting.
Variance cao: mô hình quá nhạy với những thay đổi trong dữ liệu huấn luyện, thường liên quan đến Overfitting.
Mục tiêu khi xây dựng mô hình là tìm được sự cân bằng phù hợp để mô hình vừa học được quy luật quan trọng, vừa có khả năng khái quát hóa trên dữ liệu mới.
Cross-validation là gì?
Cross-validation (kiểm định chéo) là kỹ thuật đánh giá mô hình bằng cách chia dữ liệu thành nhiều phần và lần lượt sử dụng các phần khác nhau để kiểm định.
Với K-fold Cross-validation, dữ liệu được chia thành K phần. Mô hình được huấn luyện trên K-1 phần và đánh giá trên phần còn lại. Quy trình được lặp lại K lần để mỗi phần đều có cơ hội làm tập đánh giá.
Kết quả trung bình giúp người phát triển có cái nhìn ổn định hơn về hiệu suất mô hình, đặc biệt khi dữ liệu không quá lớn.
Generative AI và LLM có liên quan gì đến Machine Learning?
Generative AI (AI tạo sinh) là nhóm công nghệ AI có khả năng tạo ra nội dung mới như văn bản, hình ảnh, âm thanh, video hoặc mã nguồn.
Large Language Model (LLM) là mô hình ngôn ngữ lớn, được huấn luyện trên lượng dữ liệu văn bản rất lớn để xử lý và tạo ngôn ngữ tự nhiên.
Hai khái niệm này có mối liên hệ chặt chẽ với Machine Learning:
Machine Learning cung cấp nền tảng phương pháp để mô hình học từ dữ liệu.
Deep Learning sử dụng mạng nơ-ron nhiều lớp để học các biểu diễn phức tạp.
LLM thường được xây dựng trên kiến trúc Deep Learning, tiêu biểu là Transformer.
Generative AI sử dụng các mô hình đã huấn luyện để tạo ra nội dung mới theo yêu cầu.
Ví dụ, một chatbot AI có thể nhận câu hỏi bằng ngôn ngữ tự nhiên, phân tích ngữ cảnh và tạo câu trả lời. Khả năng này được xây dựng trên các mô hình học sâu và quá trình huấn luyện Machine Learning.
Vì vậy, Machine Learning không chỉ là nền tảng của nhiều hệ thống dự đoán truyền thống mà còn đóng vai trò quan trọng trong sự phát triển của AI tạo sinh hiện nay.
Muốn học Machine Learning cần bắt đầu từ đâu?
Machine Learning là lĩnh vực kết hợp giữa lập trình, toán học, thống kê và tư duy phân tích dữ liệu. Người mới nên xây dựng nền tảng theo từng giai đoạn thay vì bắt đầu ngay với các thuật toán phức tạp.
| Giai đoạn | Kiến thức cần học | Mục tiêu |
|---|---|---|
| 1. Lập trình | Python, NumPy, Pandas | Đọc, xử lý và phân tích dữ liệu |
| 2. Toán và thống kê | Đại số tuyến tính, xác suất, thống kê | Hiểu cơ sở toán học của thuật toán |
| 3. Xử lý dữ liệu | Data Cleaning, EDA, trực quan hóa | Chuẩn bị dữ liệu cho mô hình |
| 4. Machine Learning cơ bản | Regression, Classification, Clustering | Hiểu và triển khai các thuật toán phổ biến |
| 5. Thực hành dự án | Scikit-learn, đánh giá mô hình | Xây dựng mô hình giải quyết bài toán thực tế |
| 6. Kiến thức nâng cao | Deep Learning, MLOps | Phát triển và vận hành mô hình chuyên sâu |
Python và SQL
Python là ngôn ngữ lập trình được sử dụng rộng rãi trong Data Science và Machine Learning nhờ hệ sinh thái thư viện phong phú. Người học nên bắt đầu với cú pháp cơ bản, sau đó tiếp cận NumPy và Pandas để xử lý dữ liệu.
SQL cũng rất cần thiết vì dữ liệu trong doanh nghiệp thường được lưu trữ trong các hệ quản trị cơ sở dữ liệu. Biết truy vấn và tổng hợp dữ liệu sẽ giúp quá trình xây dựng mô hình thuận lợi hơn.
Toán học và thống kê
Người học không nhất thiết phải thành thạo toàn bộ kiến thức toán học ngay từ đầu. Tuy nhiên, cần hiểu các nội dung nền tảng như:
Đại số tuyến tính: vector, ma trận và phép biến đổi.
Xác suất: phân phối xác suất và các khái niệm cơ bản.
Thống kê: trung bình, phương sai, độ lệch chuẩn và tương quan.
Giải tích: đạo hàm và cách tối ưu hóa hàm mất mát.
Những kiến thức này giúp người học hiểu cách thuật toán hoạt động thay vì chỉ sử dụng thư viện có sẵn.
Xử lý và phân tích dữ liệu
Trước khi huấn luyện mô hình, người học cần biết cách kiểm tra chất lượng dữ liệu, xử lý giá trị thiếu, phát hiện ngoại lệ và phân tích mối quan hệ giữa các biến.
Đây là giai đoạn quan trọng vì dữ liệu đầu vào ảnh hưởng trực tiếp đến chất lượng mô hình.
Học thuật toán và thực hành dự án
Sau khi có nền tảng, người học có thể bắt đầu với Linear Regression, Logistic Regression, Decision Tree, Random Forest và K-Means.
Thay vì chỉ học lý thuyết, nên thực hành các dự án nhỏ như dự đoán giá nhà, phân loại email spam, phân nhóm khách hàng hoặc dự đoán khả năng mua hàng.
Tìm hiểu MLOps cơ bản
MLOps là tập hợp các phương pháp và công cụ hỗ trợ đưa mô hình Machine Learning từ giai đoạn thử nghiệm vào môi trường vận hành, đồng thời quản lý vòng đời của mô hình.
Một số nội dung cơ bản gồm quản lý phiên bản dữ liệu và mô hình, triển khai mô hình, theo dõi hiệu suất, phát hiện dữ liệu thay đổi và huấn luyện lại khi cần thiết.
Người mới chưa cần đi sâu vào MLOps ngay từ đầu. Tuy nhiên, việc hiểu cách một mô hình được triển khai và duy trì trong thực tế sẽ giúp mở rộng góc nhìn về công việc Machine Learning.
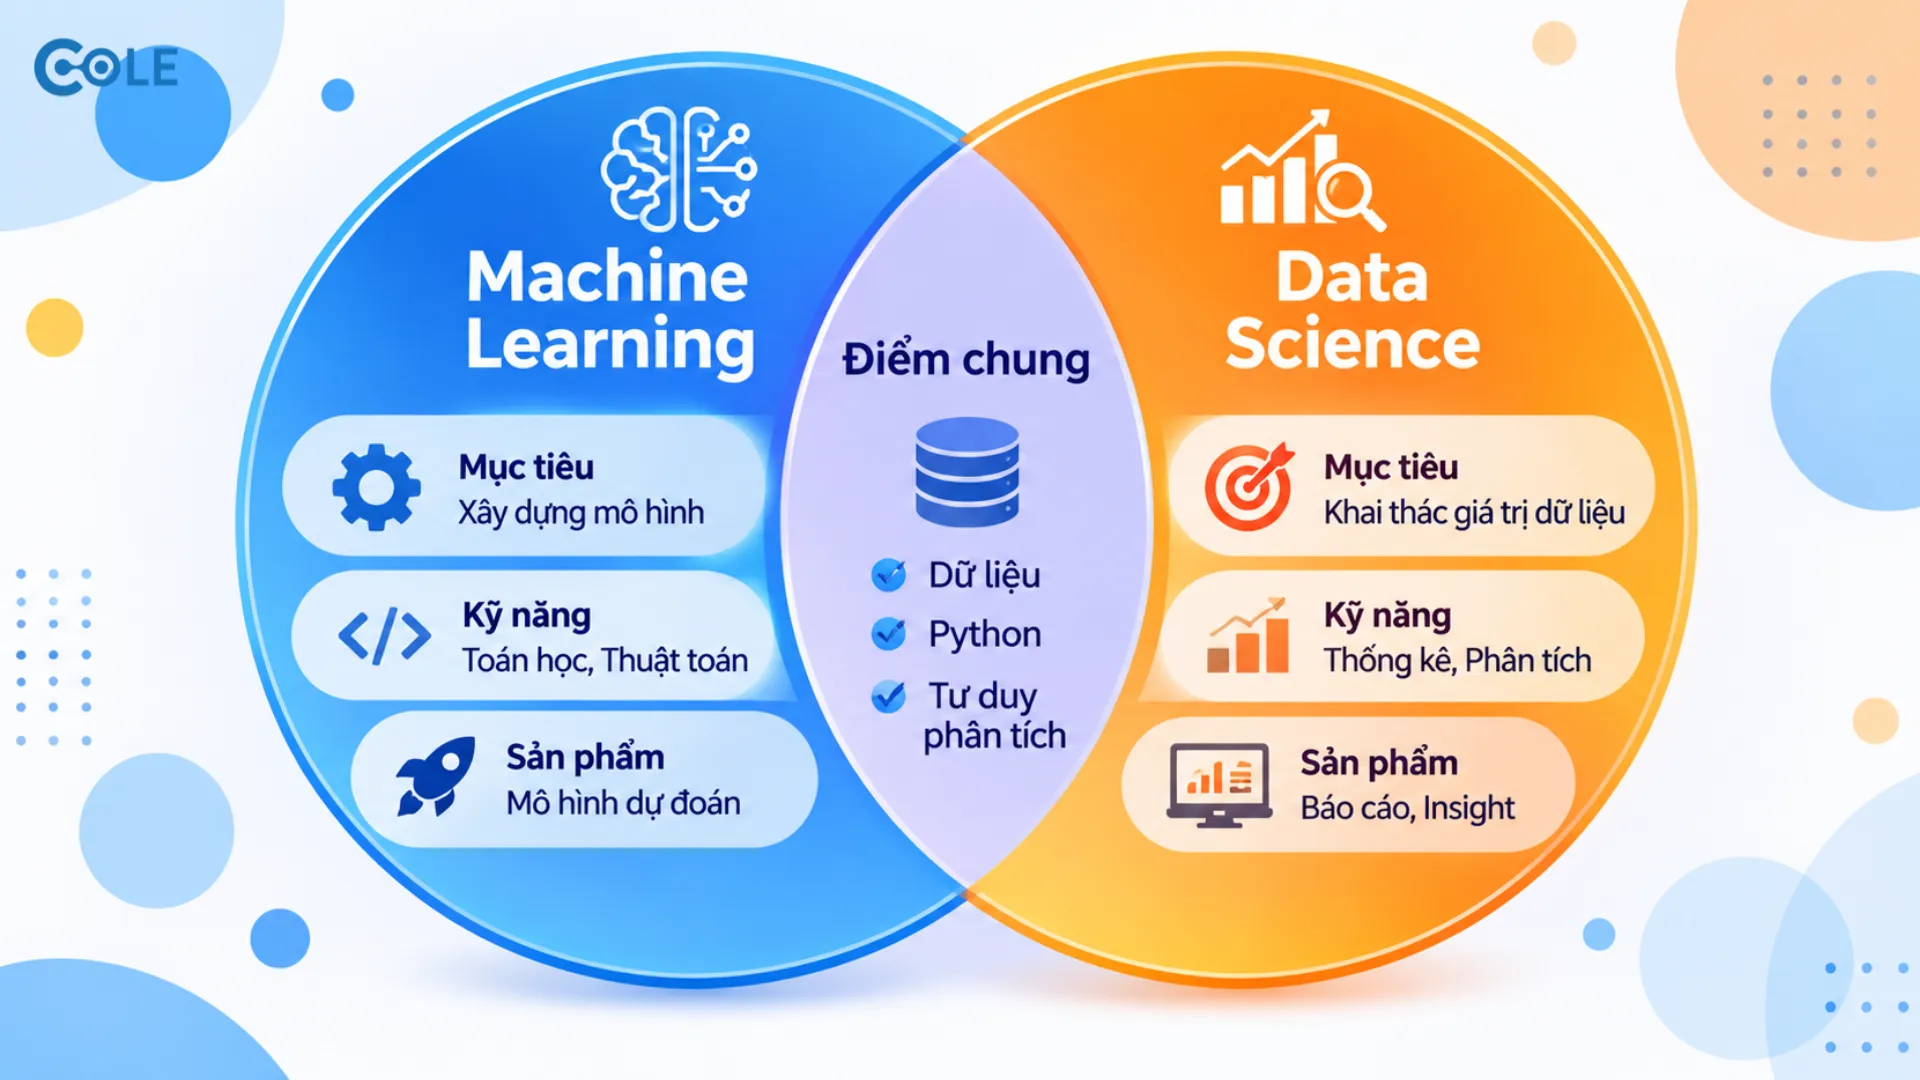
Machine Learning trong lộ trình Data Science
Data Science (Khoa học dữ liệu) là lĩnh vực sử dụng dữ liệu, phương pháp thống kê, lập trình và kiến thức chuyên môn để tìm ra thông tin có giá trị, hỗ trợ giải quyết vấn đề và ra quyết định.
Machine Learning là một trong những nhóm kỹ thuật quan trọng của Data Science, nhưng không phải dự án Data Science nào cũng bắt buộc phải sử dụng Machine Learning.
Một lộ trình Data Science cơ bản có thể triển khai theo các giai đoạn:
Python và SQL: học cách truy vấn, xử lý và thao tác với dữ liệu.
Toán và thống kê: xây dựng nền tảng để phân tích và hiểu dữ liệu.
Data Cleaning và EDA: làm sạch, khám phá và tìm hiểu đặc điểm dữ liệu.
Data Visualization: trình bày dữ liệu bằng biểu đồ và báo cáo.
Machine Learning: sử dụng thuật toán để phân loại, dự đoán hoặc phân cụm.
Dự án thực tế: kết hợp các kiến thức để giải quyết một bài toán cụ thể.
Nếu muốn theo đuổi Data Science, người học nên xây dựng kiến thức từ xử lý dữ liệu đến phân tích và mô hình hóa. Việc học Machine Learning sẽ hiệu quả hơn khi đã hiểu dữ liệu đến từ đâu, có đặc điểm gì và cần giải quyết vấn đề nào.
Học Data Science bài bản cùng Cole
Nếu bạn muốn xây dựng nền tảng về Python, xử lý dữ liệu, thống kê và Machine Learning, việc học theo một lộ trình có hệ thống sẽ giúp tiết kiệm thời gian và tránh tiếp cận kiến thức rời rạc.
Khóa học Data Science tại Cole hướng đến việc trang bị kiến thức và kỹ năng làm việc với dữ liệu, từ nền tảng đến ứng dụng. Người học có thể tìm hiểu nội dung chương trình để xác định mức độ phù hợp với mục tiêu của mình.
Tìm hiểu khóa học Data Science tại Cole để bắt đầu xây dựng lộ trình học Khoa học dữ liệu.
Câu hỏi thường gặp về Machine Learning
Machine Learning có phải là trí tuệ nhân tạo không?
Machine Learning là một nhánh của trí tuệ nhân tạo. AI có phạm vi rộng hơn, bao gồm cả những hệ thống hoạt động dựa trên luật, tìm kiếm và suy luận mà không nhất thiết phải học từ dữ liệu.
Machine Learning khác Deep Learning như thế nào?
Machine Learning là lĩnh vực giúp máy tính học từ dữ liệu bằng nhiều loại thuật toán. Deep Learning là một nhánh của Machine Learning, sử dụng mạng nơ-ron nhiều lớp để học các đặc trưng phức tạp.
Machine Learning có cần nhiều dữ liệu không?
Lượng dữ liệu cần thiết phụ thuộc vào bài toán và thuật toán. Một số mô hình truyền thống có thể hoạt động tốt với dữ liệu vừa phải, trong khi các mô hình Deep Learning thường cần nhiều dữ liệu và tài nguyên tính toán hơn.
Người không giỏi toán có học Machine Learning được không?
Người mới vẫn có thể bắt đầu học Machine Learning mà chưa cần kiến thức toán chuyên sâu. Tuy nhiên, cần từng bước bổ sung xác suất, thống kê, đại số tuyến tính và các kiến thức toán liên quan để hiểu sâu hơn về thuật toán.
Machine Learning có thể thay thế con người không?
Machine Learning có thể tự động hóa một số công việc phân tích và dự đoán, nhưng vẫn cần con người xác định mục tiêu, chuẩn bị dữ liệu, kiểm tra kết quả và giám sát hệ thống. Trong nhiều lĩnh vực, mô hình đóng vai trò hỗ trợ thay vì thay thế hoàn toàn chuyên gia.
Nên học Machine Learning hay Data Science trước?
Nếu mới bắt đầu và chưa có nền tảng xử lý dữ liệu, bạn nên học Python, SQL, thống kê và phân tích dữ liệu trước. Sau đó, có thể tiếp cận Machine Learning như một phần trong lộ trình Data Science.
.jpg "Hướng dẫn Vibe Coding cho người mới tạo sản phẩm thực tế")