Trong các hệ thống dữ liệu hiện đại, doanh nghiệp thường phải xử lý nhiều công đoạn như thu thập dữ liệu, làm sạch, biến đổi, lưu trữ và cập nhật báo cáo. Khi số lượng tác vụ tăng lên, việc chạy từng script Python hoặc SQL thủ công sẽ khiến quy trình khó kiểm soát, dễ xảy ra lỗi và tốn thời gian vận hành.
Apache Airflow là một nền tảng mã nguồn mở giúp xây dựng, lập lịch và giám sát các quy trình xử lý dữ liệu. Thông qua việc định nghĩa workflow bằng Python, Data Engineer có thể tổ chức các tác vụ thành một quy trình có thứ tự, theo dõi trạng thái thực thi và chủ động xử lý khi có lỗi.
Bài viết này hướng dẫn cách sử dụng Apache Airflow để xây dựng một Data Pipeline cơ bản, tạo DAG bằng Python, truyền dữ liệu giữa các tác vụ và mở rộng quy trình bằng Apache Spark. Đồng thời, bài viết làm rõ vai trò của Airflow khi kết hợp với Kafka trong kiến trúc Big Data.
1. Apache Airflow là gì?
Apache Airflow là nền tảng mã nguồn mở dùng để lập trình, lập lịch và giám sát các workflow. Công cụ này cho phép người dùng định nghĩa quy trình xử lý dữ liệu bằng Python, sau đó tự động điều phối các tác vụ theo thứ tự và điều kiện đã thiết lập.
Thay vì phải chạy từng script riêng lẻ, Data Engineer có thể sử dụng Airflow để quản lý toàn bộ quy trình trong một hệ thống thống nhất.
Ví dụ, một Data Pipeline xử lý dữ liệu bán hàng có thể gồm các bước:
Thu thập dữ liệu đơn hàng từ hệ thống nguồn.
Kiểm tra và làm sạch dữ liệu.
Tính toán doanh thu theo ngày.
Lưu kết quả vào Data Warehouse.
Cập nhật dữ liệu phục vụ báo cáo Power BI.
Airflow chịu trách nhiệm điều phối thứ tự thực hiện, lập lịch chạy và theo dõi trạng thái của từng bước.
Những thành phần chính trong Apache Airflow
Để sử dụng Airflow hiệu quả, cần hiểu một số thành phần quan trọng:
| Thành phần | Chức năng |
|---|---|
| DAG | Biểu diễn workflow và mối quan hệ phụ thuộc giữa các tác vụ |
| Task | Một công việc cụ thể trong workflow |
| Operator | Thành phần định nghĩa cách thực thi một task |
| Scheduler | Theo dõi lịch chạy và tạo các DAG Run phù hợp |
| Executor | Quyết định cách các task instance được thực thi |
| Worker | Tiến trình hoặc môi trường thực thi task trong một số mô hình triển khai |
| Webserver | Cung cấp giao diện quản lý và giám sát workflow |
| Metadata Database | Lưu trạng thái DAG Run, task instance và thông tin vận hành |
Trong đó, DAG và Task là hai khái niệm cần nắm vững trước khi xây dựng Data Pipeline.
2. DAG trong Apache Airflow hoạt động như thế nào?
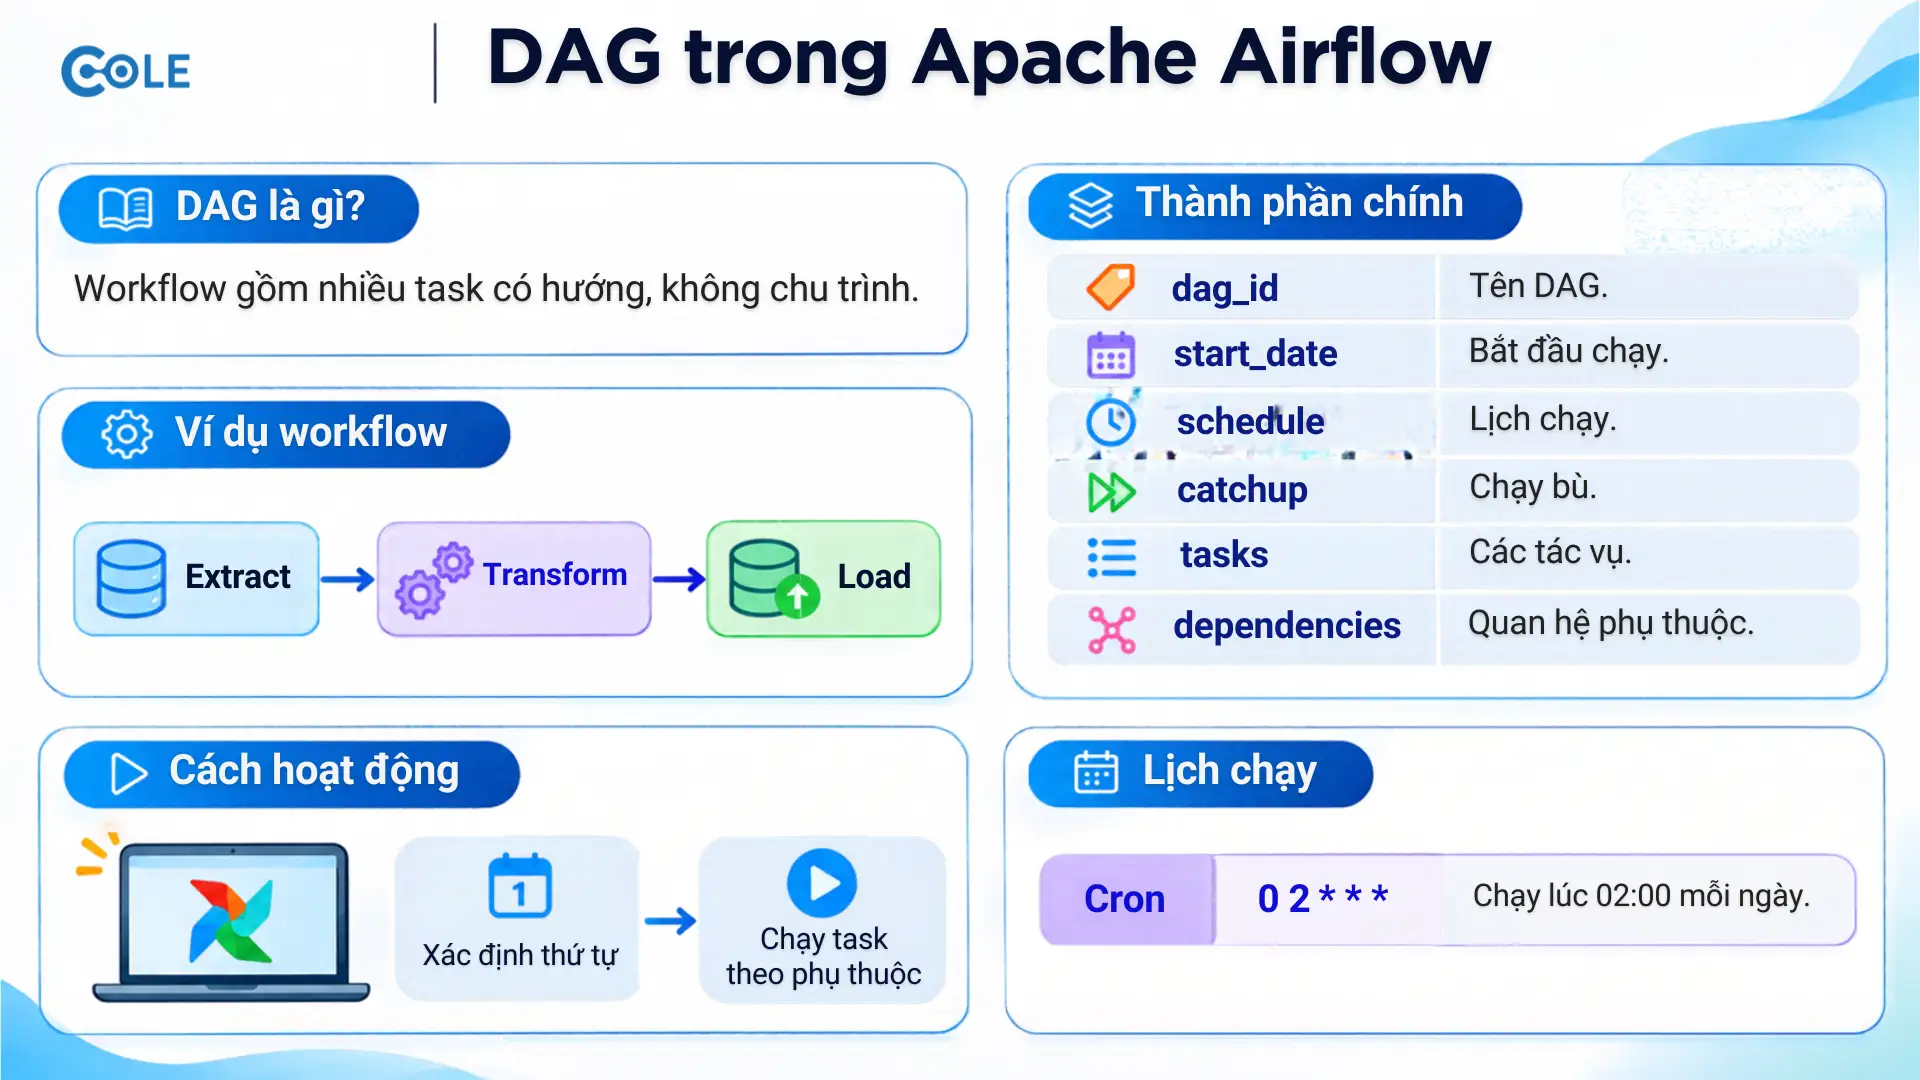
DAG là viết tắt của Directed Acyclic Graph, có nghĩa là đồ thị có hướng không chu trình. Trong Apache Airflow, DAG mô tả một workflow gồm nhiều task và các mối quan hệ phụ thuộc giữa chúng.
Ví dụ, một quy trình xử lý dữ liệu có ba task:
Extract: Thu thập dữ liệu từ hệ thống nguồn.
Transform: Làm sạch và biến đổi dữ liệu.
Load: Lưu dữ liệu vào hệ thống đích.
Thứ tự thực hiện được biểu diễn như sau:
Extract → Transform → Load
Airflow dựa trên các mối quan hệ này để xác định task nào được phép chạy trước, task nào cần chờ task khác hoàn thành.
Các thành phần của một DAG
Một DAG thường có các thông tin cấu hình:
dag_id: Tên định danh duy nhất của DAG.
start_date: Thời điểm bắt đầu lịch chạy.
schedule: Lịch thực thi workflow.
catchup: Quyết định có tạo các lần chạy bù cho những khoảng thời gian trước đó hay không.
tasks: Danh sách các tác vụ thuộc workflow.
dependencies: Quan hệ phụ thuộc giữa các task.
Airflow hỗ trợ nhiều cách khai báo lịch chạy, phổ biến nhất là biểu thức Cron.
Ví dụ:
| Biểu thức | Lịch thực thi |
|---|---|
| 0 2 * * * | Mỗi ngày lúc 02:00 |
| 0 * * * * | Mỗi giờ |
| 0 8 * * 1 | 08:00 thứ Hai hằng tuần |
| 0 0 1 * * | 00:00 ngày đầu tiên mỗi tháng |
Lưu ý: Lịch chạy được tính theo timezone của DAG. Nếu không cấu hình timezone riêng, Airflow mặc định sử dụng UTC.
3. Hướng dẫn cài đặt Apache Airflow
Apache Airflow có thể được cài đặt trong môi trường Python để phục vụ học tập và thử nghiệm. Với hệ thống thực tế, cần lựa chọn phương án triển khai phù hợp với kiến trúc hạ tầng.
Bước 1: Chuẩn bị môi trường Python
Tạo môi trường ảo để quản lý các thư viện:
python -m venv airflow-env
Kích hoạt môi trường trên Windows:
airflow-env\Scripts\activate
Trên Linux hoặc macOS:
source airflow-env/bin/activate
Bước 2: Cài đặt Apache Airflow
Airflow có nhiều phiên bản và phụ thuộc vào phiên bản Python tương ứng. Vì vậy, không nên cài đặt bằng một lệnh pip tùy ý mà không kiểm tra tương thích.
Ví dụ cài đặt Airflow bằng constraints file:
AIRFLOW_VERSION=2.10.5
PYTHON_VERSION=3.11
pip install "apache-airflow==${AIRFLOW_VERSION}" \
  --constraint "https://raw.githubusercontent.com/apache/airflow/constraints-${AIRFLOW\_VERSION}/constraints-${PYTHON\_VERSION}.txt"
Đây là ví dụ cho Airflow 2.10.5 và Python 3.11. Khi triển khai, cần chọn phiên bản Airflow, Python và constraints tương thích với môi trường thực tế.
Bước 3: Khởi tạo cơ sở dữ liệu và chạy Airflow
Khởi tạo metadata database:
airflow db migrate
Tạo tài khoản quản trị:
airflow users create \
  --username admin \
  --firstname Admin \
  --lastname User \
  --role Admin \
  --email admin@example.com \
  --password admin
Khởi chạy giao diện web:
airflow webserver --port 8080
Mở một terminal khác và chạy Scheduler:
airflow scheduler
Sau khi các dịch vụ hoạt động, truy cập:
http://localhost:8080
Đăng nhập bằng tài khoản đã tạo để quản lý DAG và theo dõi các lần chạy.
Lưu ý: Cách chạy webserver và scheduler riêng biệt phù hợp với một số phiên bản Airflow 2.x. Với các phiên bản mới hơn hoặc môi trường production, hãy sử dụng phương thức khởi chạy và triển khai theo đúng tài liệu của phiên bản đang cài đặt. Không nên dùng tài khoản và mật khẩu mẫu trong môi trường thật.
4. Hướng dẫn xây dựng Data Pipeline bằng Apache Airflow
Sau khi cài đặt, có thể bắt đầu xây dựng một workflow đơn giản để xử lý dữ liệu bán hàng.
Trong ví dụ này, Data Pipeline gồm ba công đoạn:
Extract: Lấy thông tin đơn hàng.
Transform: Xử lý và tính toán dữ liệu.
Load: Đưa kết quả vào hệ thống đích.
Bước 1: Tạo file DAG
Trong thư mục DAG của Airflow, tạo file:
sales_pipeline.py
Thông thường, thư mục DAG được cấu hình thông qua biến môi trường AIRFLOW__CORE__DAGS_FOLDER.
Bước 2: Viết các hàm xử lý dữ liệu
Mỗi task sẽ đảm nhận một nhiệm vụ riêng. Để minh họa, ví dụ sử dụng dữ liệu đơn hàng giả lập:
from datetime import timedelta
import pendulum
from airflow import DAG
from airflow.operators.python import PythonOperator
def extract_data():
    # Mô phỏng việc lấy dữ liệu từ hệ thống nguồn
    orders = [
        {"order_id": 1, "amount": 500000},
        {"order_id": 2, "amount": 750000},
        {"order_id": 3, "amount": 250000}
    ]
    print(f"Đã thu thập {len(orders)} đơn hàng")
    # Chỉ trả về metadata nhỏ để minh họa XCom
    return {
        "total_orders": len(orders),
        "source": "sales_system"
    }
def transform_data(ti):
    # Nhận metadata từ task extract_data
    extracted_info = ti.xcom_pull(
        task_ids="extract"
    )
    total_orders = extracted_info["total_orders"]
    # Mô phỏng quá trình biến đổi dữ liệu
    processed_info = {
        "processed_orders": total_orders,
        "status": "completed"
    }
    print(f"Đã xử lý {total_orders} đơn hàng")
    return processed_info
def load_data(ti):
    # Nhận kết quả từ task transform_data
    processed_info = ti.xcom_pull(
        task_ids="transform"
    )
    print(
        f"Đã tải {processed_info['processed_orders']} "
        "đơn hàng vào hệ thống đích"
    )
with DAG(
    dag_id="sales_data_pipeline",
    description="Pipeline xử lý dữ liệu bán hàng",
    start_date=pendulum.datetime(
        2026, 1, 1,
        tz="Asia/Ho_Chi_Minh"
    ),
    schedule="0 2 * * *",
    catchup=False,
    default_args={
        "owner": "data_engineer",
        "retries": 2,
        "retry_delay": timedelta(minutes=5)
    },
    tags=["sales", "data-pipeline"]
) as dag:
    extract = PythonOperator(
        task_id="extract",
        python_callable=extract_data
    )
    transform = PythonOperator(
        task_id="transform",
        python_callable=transform_data
    )
    load = PythonOperator(
        task_id="load",
        python_callable=load_data
    )
    # Khai báo thứ tự thực thi
    extract >> transform >> load
Đây là DAG hoàn chỉnh ở mức minh họa, sử dụng PythonOperator để thực hiện ba công đoạn và XCom để truyền metadata giữa các task. Khi triển khai thực tế, cần thay dữ liệu giả lập bằng kết nối tới hệ thống nguồn và hệ thống đích.
Bước 3: Giải thích các cấu hình quan trọng
Timezone
start_date=pendulum.datetime(
    2026, 1, 1,
    tz="Asia/Ho_Chi_Minh"
)
Cấu hình này giúp DAG sử dụng múi giờ Việt Nam thay vì mặc định UTC. Do đó, lịch 0 2 * * * được hiểu là 02:00 theo giờ Việt Nam.
Lịch chạy
schedule="0 2 * * *"
DAG được lập lịch chạy mỗi ngày vào lúc 02:00. Đây là thời điểm thường được lựa chọn cho các pipeline xử lý dữ liệu định kỳ, khi lưu lượng truy cập hoặc hoạt động giao dịch có thể thấp hơn.
Catchup
catchup=False
Khi bật catchup=False, Airflow không tự động tạo các DAG Run cho toàn bộ data interval trong quá khứ chưa được thực thi kể từ start_date.
Cấu hình này hữu ích khi chỉ muốn workflow bắt đầu chạy theo lịch hiện tại, thay vì tạo hàng loạt lần chạy bù cho những khoảng thời gian trước đó.
Data Interval
Data Interval là khoảng thời gian dữ liệu mà một DAG Run chịu trách nhiệm xử lý. Ví dụ, một pipeline chạy hằng ngày có thể xử lý dữ liệu phát sinh trong ngày trước đó.
Cần phân biệt thời điểm DAG Run được kích hoạt với khoảng thời gian dữ liệu mà DAG Run đó xử lý. Hai khái niệm này không nhất thiết trùng nhau.
Bước 4: Hiểu cách truyền dữ liệu bằng XCom
Trong ví dụ trên, extract_data() trả về một dictionary nhỏ. Airflow có thể tự động lưu giá trị trả về của task vào XCom.
Task tiếp theo sử dụng:
extracted_info = ti.xcom_pull(
    task_ids="extract"
)
để lấy dữ liệu từ task extract.
XCom phù hợp để truyền các giá trị nhỏ như:
Số lượng bản ghi đã xử lý.
Đường dẫn tới file dữ liệu.
Trạng thái hoàn thành.
Tên bảng hoặc mã định danh của một lần xử lý.
Không nên sử dụng XCom để truyền DataFrame lớn, hàng triệu bản ghi hoặc toàn bộ file dữ liệu. Thay vào đó, hãy lưu dữ liệu trong object storage, database hoặc hệ thống lưu trữ phù hợp, sau đó truyền đường dẫn hoặc metadata qua XCom.
5. Tích hợp Apache Spark để xử lý dữ liệu lớn
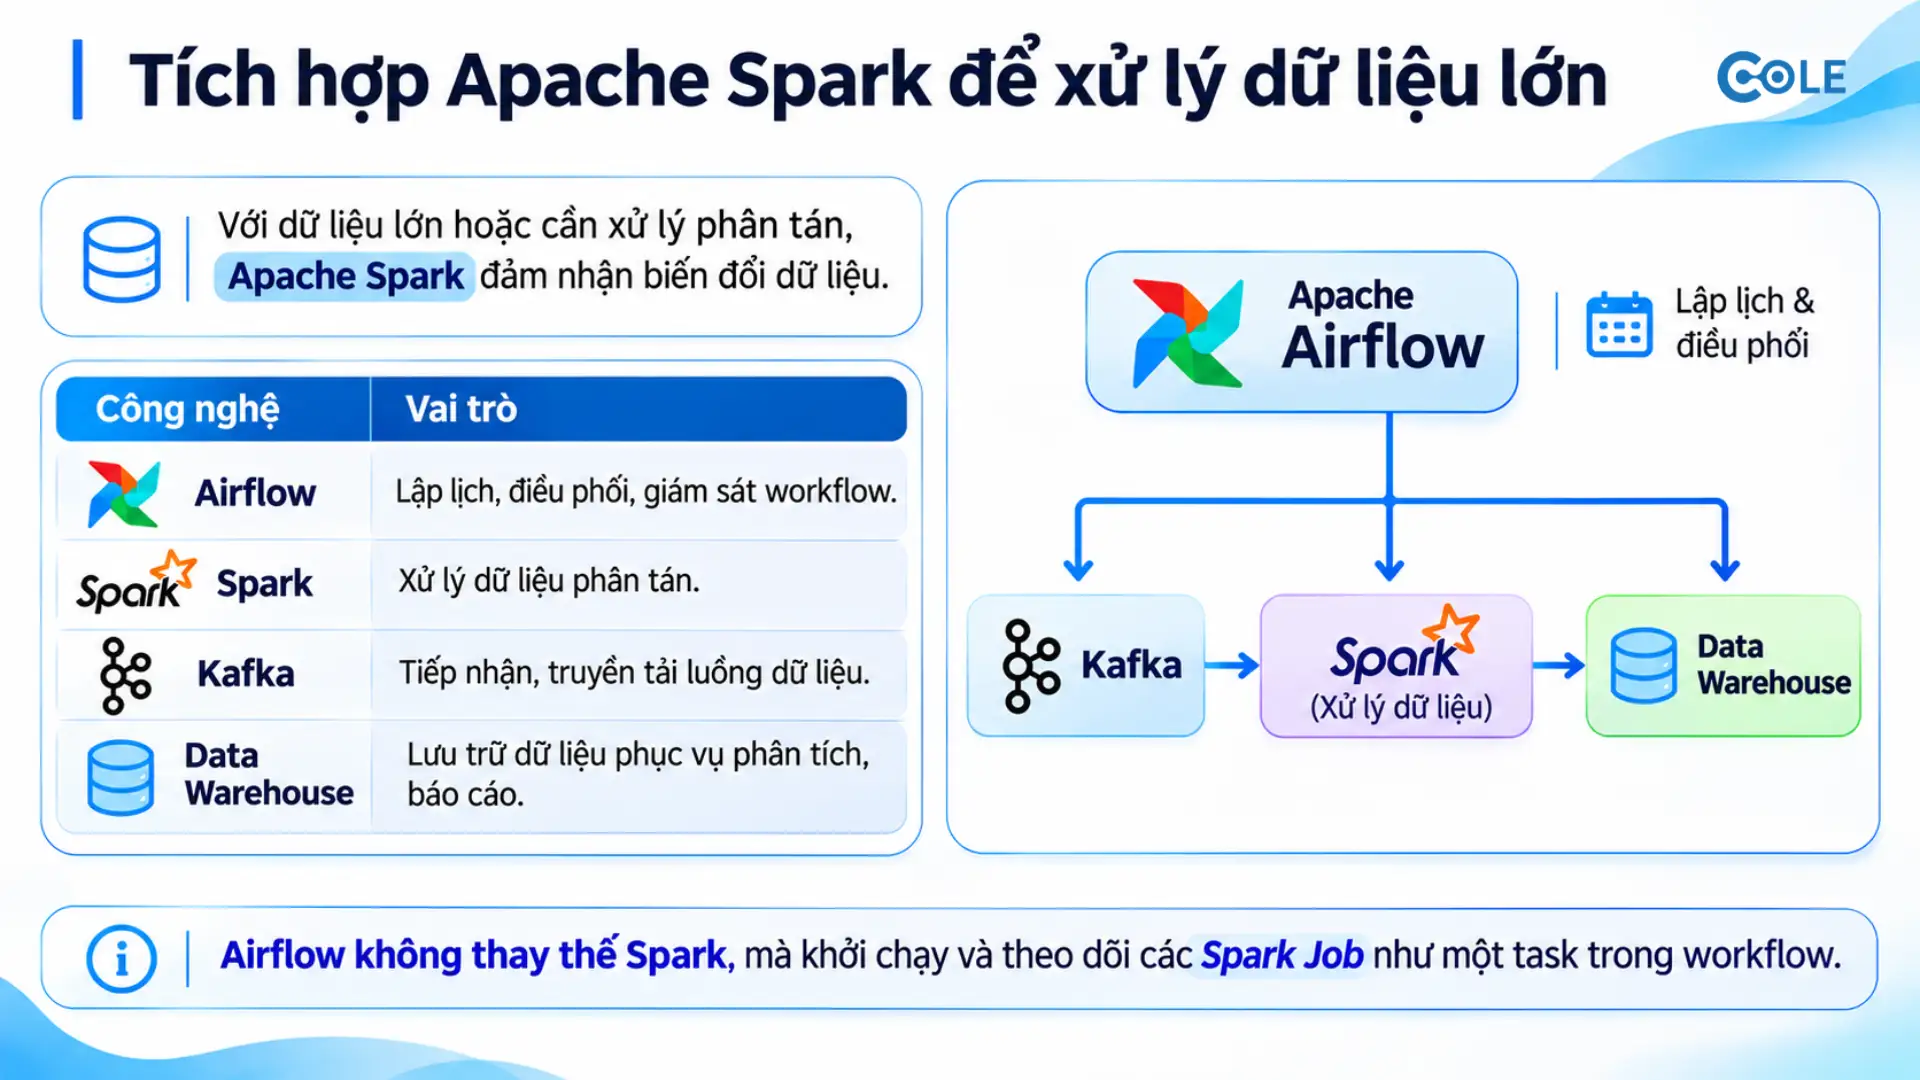
Với những pipeline có khối lượng dữ liệu lớn hoặc yêu cầu xử lý phân tán, Apache Spark có thể đảm nhận công đoạn biến đổi dữ liệu.
Apache Airflow và Apache Spark có vai trò khác nhau:
| Công nghệ | Vai trò |
|---|---|
| Apache Airflow | Lập lịch, điều phối và giám sát workflow |
| Apache Spark | Xử lý dữ liệu phân tán |
| Apache Kafka | Tiếp nhận và truyền tải luồng dữ liệu |
| Data Warehouse | Lưu trữ dữ liệu phục vụ phân tích và báo cáo |
Airflow không trực tiếp thay thế Spark. Thay vào đó, Airflow có thể khởi chạy và theo dõi các Spark Job như một task trong workflow.
Sử dụng SparkSubmitOperator
Để tích hợp Spark, trước tiên cần cài Apache Spark Provider tương thích với phiên bản Airflow đang sử dụng:
pip install apache-airflow-providers-apache-spark
Trong môi trường triển khai thực tế, cần sử dụng constraints phù hợp và kiểm tra tính tương thích của provider với phiên bản Airflow.
Sau đó, import operator:
from airflow.providers.apache.spark.operators.spark_submit import (
    SparkSubmitOperator
)
Ví dụ khai báo một Spark task trong DAG:
process_with_spark = SparkSubmitOperator(
    task_id="process_with_spark",
    application="/opt/airflow/jobs/process_sales.py",
    conn_id="spark_default",
    name="sales-processing-job",
    verbose=True
)
Trong đó:
application: Đường dẫn tới file Spark application.
conn_id: Connection chứa thông tin kết nối tới Spark.
name: Tên Spark Job.
verbose: Bật log chi tiết trong quá trình thực thi.
Để task hoạt động, cần chuẩn bị Spark application, cấu hình connection spark_default trong Airflow và bảo đảm môi trường chạy Airflow có thể truy cập Spark cluster.
Ví dụ, trong một pipeline thực tế, có thể tổ chức quy trình:
Extract → Spark Processing → Load
Airflow sẽ điều phối các bước, còn Spark đảm nhận phần tính toán và xử lý dữ liệu.
Khi nào nên sử dụng Spark?
Không phải mọi Data Pipeline đều cần Apache Spark. Với dữ liệu nhỏ hoặc khối lượng vừa phải, SQL, Python, Pandas hoặc Polars có thể đáp ứng tốt mà không cần triển khai thêm một hệ thống xử lý phân tán.
Spark phù hợp hơn khi khối lượng dữ liệu, độ phức tạp tính toán, yêu cầu xử lý song song hoặc giới hạn tài nguyên của một máy đơn khiến các công cụ thông thường không còn đáp ứng hiệu quả.
Việc lựa chọn công nghệ nên dựa trên khối lượng dữ liệu, cấu trúc dữ liệu, tài nguyên hạ tầng, độ trễ yêu cầu và chi phí vận hành.
6. Kết hợp Apache Airflow và Kafka trong Data Pipeline
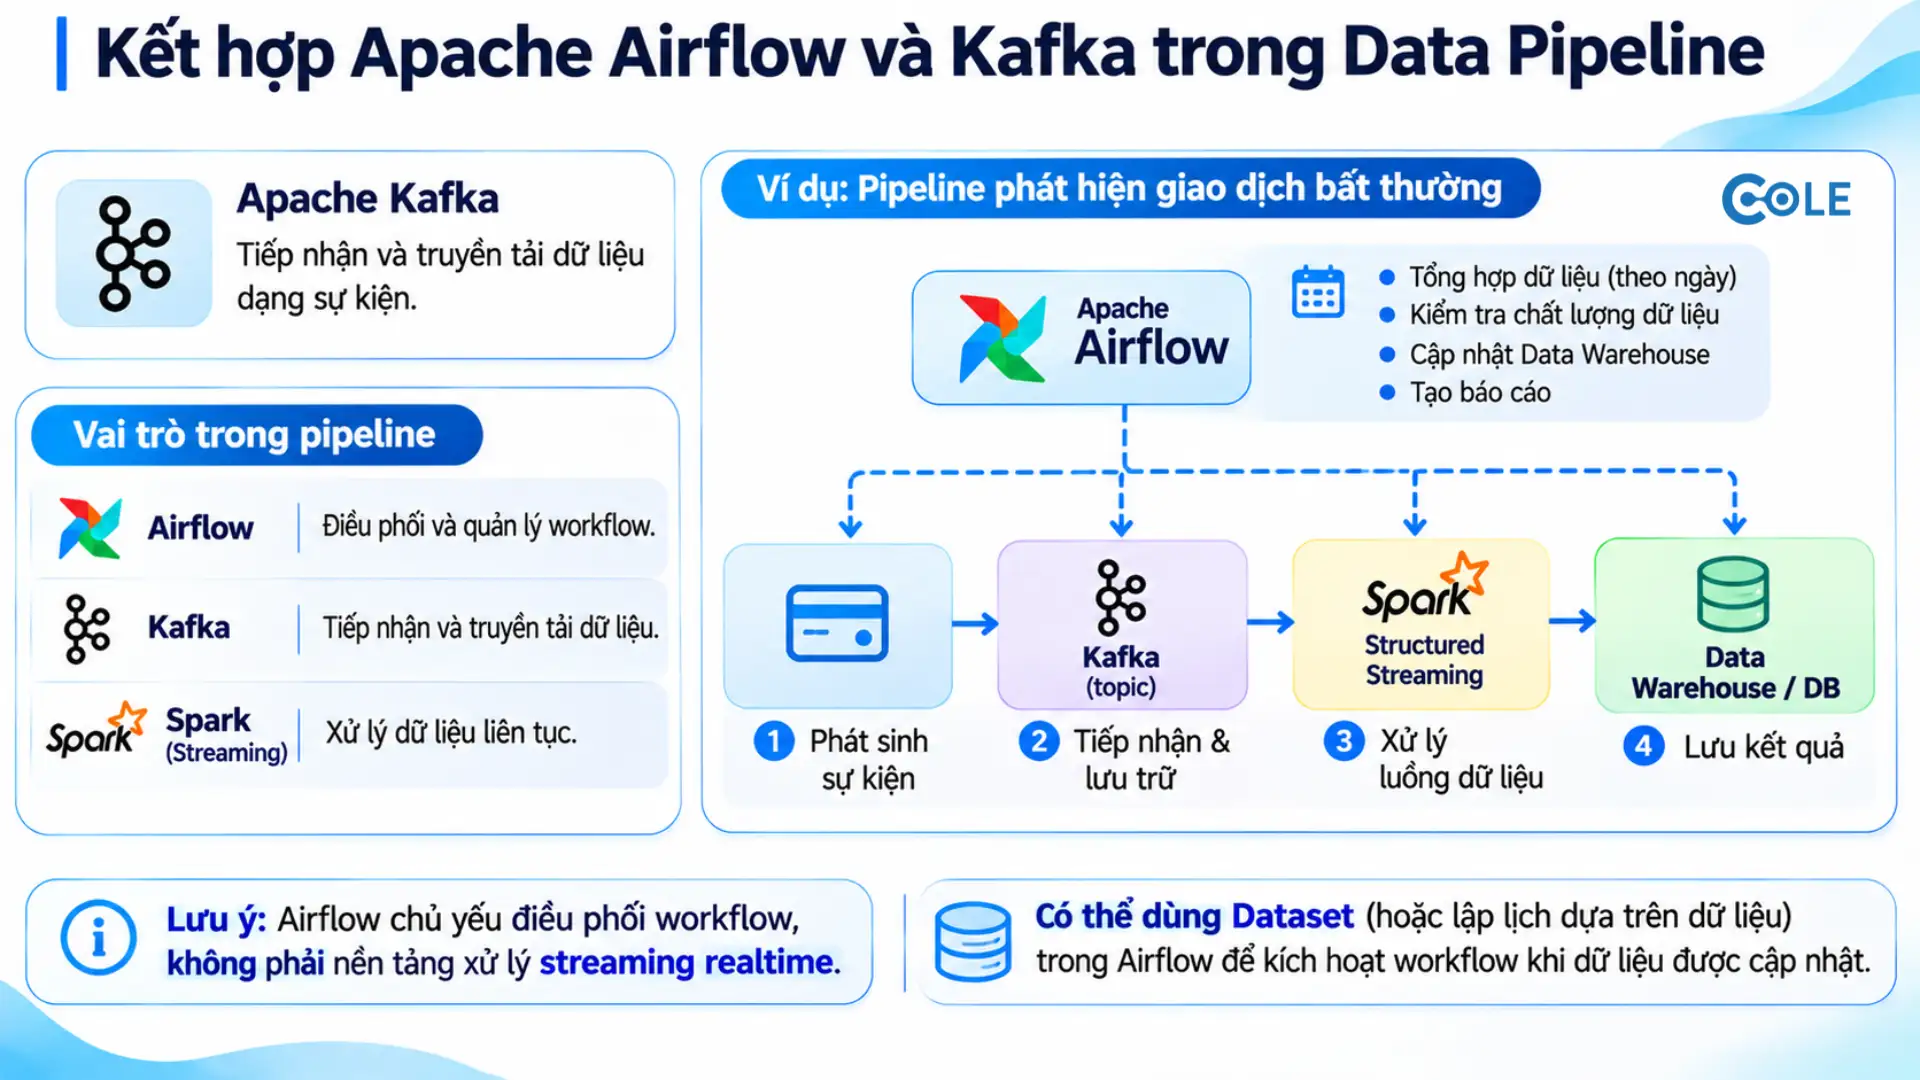
Apache Kafka là nền tảng phân tán thường được sử dụng để tiếp nhận và truyền tải dữ liệu dạng sự kiện. Kafka phù hợp với các hệ thống cần xử lý luồng dữ liệu liên tục, chẳng hạn như giao dịch tài chính, hành vi người dùng hoặc dữ liệu cảm biến.
Trong kiến trúc Big Data, Kafka và Airflow có thể phối hợp với nhau nhưng không thay thế chức năng của nhau.
Ví dụ, một hệ thống phát hiện giao dịch bất thường có thể hoạt động theo mô hình:
Hệ thống giao dịch phát sinh sự kiện.
Kafka tiếp nhận và lưu trữ các sự kiện trong topic.
Spark Structured Streaming đọc dữ liệu từ Kafka và xử lý luồng giao dịch.
Kết quả được ghi vào hệ thống lưu trữ hoặc cơ sở dữ liệu.
Airflow điều phối các công việc liên quan như tổng hợp dữ liệu theo ngày, kiểm tra chất lượng dữ liệu, cập nhật Data Warehouse và tạo báo cáo.
Trong mô hình này:
Kafka đảm nhận việc tiếp nhận và truyền tải dữ liệu.
Spark Structured Streaming xử lý dữ liệu liên tục.
Airflow quản lý các workflow theo lịch hoặc theo điều kiện phụ thuộc dữ liệu.
Lưu ý: Airflow chủ yếu phục vụ điều phối workflow, không phải nền tảng xử lý streaming realtime. Nếu cần xử lý dữ liệu ngay khi sự kiện phát sinh, nên sử dụng Kafka cùng các công cụ streaming phù hợp.
Ở những phiên bản Airflow hỗ trợ, có thể sử dụng cơ chế Dataset hoặc các tính năng lập lịch dựa trên dữ liệu để kích hoạt workflow khi dữ liệu đầu vào được cập nhật. Tuy nhiên, đây vẫn là cơ chế điều phối workflow, không thay thế bộ máy xử lý streaming.
7. Vận hành Apache Airflow trong môi trường thực tế
Xây dựng được một DAG mới chỉ là bước đầu. Khi số lượng pipeline tăng lên, Data Engineer cần quan tâm đến khả năng mở rộng, độ ổn định và việc giám sát hệ thống.
Lựa chọn Executor phù hợp
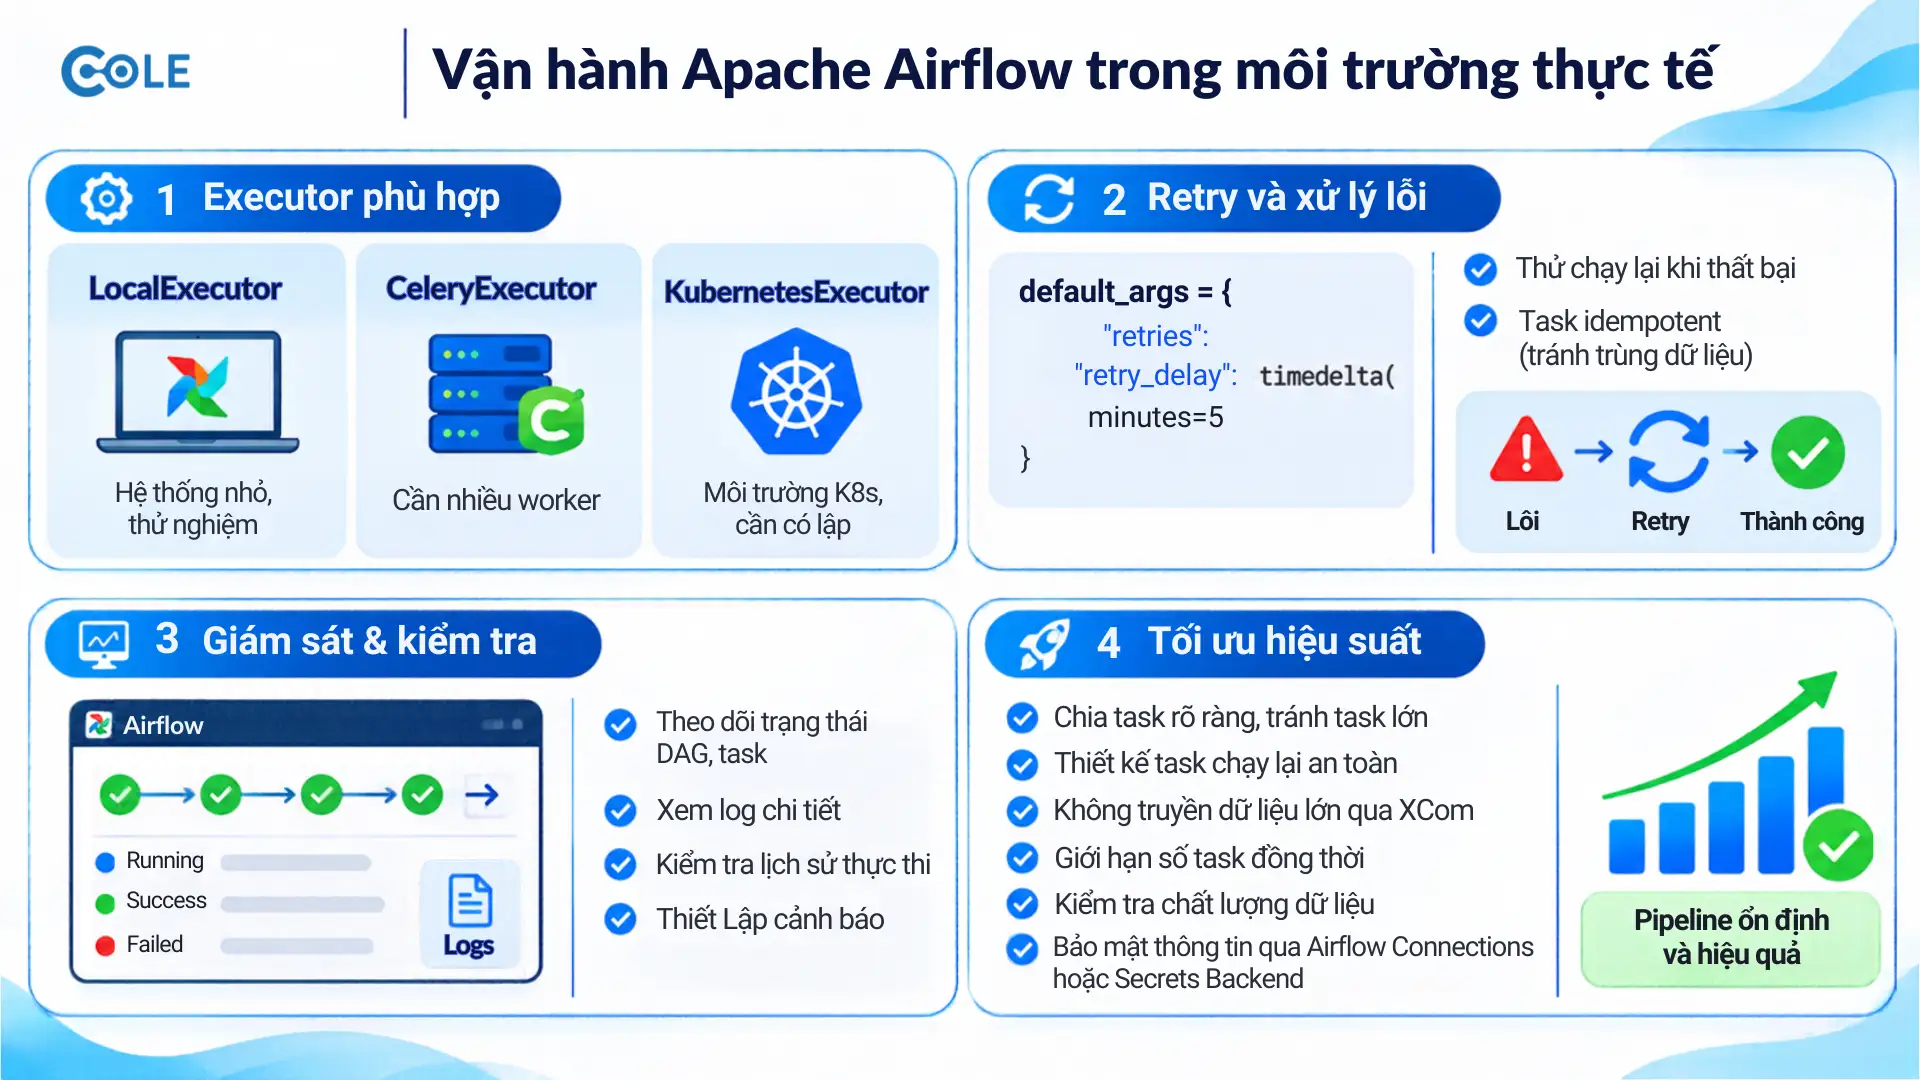
Executor quyết định cách Airflow thực thi các task instance. Một số loại Executor phổ biến gồm:
| Executor | Đặc điểm | Trường hợp sử dụng |
|---|---|---|
| LocalExecutor | Thực thi task trên cùng môi trường chạy Airflow | Hệ thống nhỏ, môi trường thử nghiệm hoặc workload vừa phải |
| CeleryExecutor | Phân phối task tới các worker thông qua Celery | Hệ thống cần mở rộng nhiều worker |
| KubernetesExecutor | Tạo môi trường thực thi task dưới dạng Kubernetes Pod | Hạ tầng Kubernetes, workload cần cô lập tài nguyên |
Không có một Executor phù hợp cho mọi hệ thống. Việc lựa chọn cần căn cứ vào số lượng task đồng thời, tài nguyên tính toán, yêu cầu cô lập, độ phức tạp hạ tầng và chi phí vận hành.
Thiết lập cơ chế retry và xử lý lỗi
Trong Data Pipeline, lỗi có thể xuất hiện do mất kết nối database, API không phản hồi, file chưa được tạo hoặc hệ thống nguồn tạm thời không khả dụng.
Có thể sử dụng các tham số như:
default_args = {
    "retries": 3,
    "retry_delay": timedelta(minutes=5)
}
Khi task thất bại, Airflow sẽ thử chạy lại theo số lần và khoảng thời gian được cấu hình.
Tuy nhiên, cần thiết kế task có khả năng chạy lại an toàn. Ví dụ, nếu một task ghi dữ liệu vào Data Warehouse được chạy lại, cần tránh tạo bản ghi trùng lặp. Có thể sử dụng cơ chế upsert, kiểm tra khóa định danh hoặc xử lý theo từng data partition.
Giám sát và kiểm tra Data Pipeline
Giao diện Airflow cung cấp thông tin về trạng thái DAG Run và từng task. Data Engineer có thể theo dõi:
Task đang chạy, thành công hoặc thất bại.
Thời gian thực thi của từng task.
Log chi tiết để xác định nguyên nhân lỗi.
Các lần retry và trạng thái xử lý.
Lịch sử thực thi của workflow.
Với hệ thống production, nên kết hợp thêm hệ thống logging, monitoring và cảnh báo để phát hiện sớm tình trạng pipeline chạy chậm, thất bại hoặc không cập nhật dữ liệu đúng hạn.
Tối ưu hiệu suất Data Pipeline
Một số nguyên tắc nên áp dụng khi vận hành:
Chia workflow thành các task có nhiệm vụ rõ ràng, tránh tạo một task quá lớn.
Thiết kế task có khả năng chạy lại mà không gây sai lệch dữ liệu.
Không truyền dữ liệu lớn qua XCom.
Giới hạn số lượng task chạy đồng thời theo tài nguyên hệ thống.
Theo dõi thời gian chạy và tối ưu những task thường xuyên bị chậm.
Kiểm tra chất lượng dữ liệu sau các bước biến đổi.
Quản lý thông tin kết nối và thông tin nhạy cảm bằng Airflow Connections hoặc Secrets Backend thay vì ghi trực tiếp vào mã nguồn.
8. Lộ trình học Apache Airflow cho Data Engineer
Để sử dụng Apache Airflow trong công việc, người học nên đi từ kiến thức nền tảng đến khả năng xây dựng và vận hành pipeline hoàn chỉnh.
| Giai đoạn | Nội dung cần học | Kết quả cần đạt |
|---|---|---|
| 1. Kiến thức nền tảng | Python, SQL, Database, Data Pipeline | Hiểu quy trình xử lý dữ liệu |
| 2. Airflow cơ bản | DAG, Task, Operator, Scheduler, XCom | Tạo và chạy workflow đơn giản |
| 3. Tích hợp công nghệ | PostgreSQL, API, Spark, Kafka | Xây dựng pipeline nhiều nguồn dữ liệu |
| 4. Vận hành | Executor, Retry, Logging, Monitoring | Quản lý workflow ổn định |
| 5. Dự án thực tế | ETL, Data Warehouse, Dashboard | Hoàn thiện một Data Pipeline có thể triển khai |
Một bài thực hành phù hợp là xây dựng hệ thống xử lý dữ liệu bán hàng: lấy dữ liệu từ API, làm sạch bằng Python hoặc Spark, lưu vào Data Warehouse và kết nối Power BI để trực quan hóa kết quả.
Qua dự án này, người học có thể hiểu rõ mối liên hệ giữa Data Pipeline, ETL, xử lý dữ liệu và hệ thống báo cáo doanh nghiệp.
9. Học Data Engineer bài bản cùng Cole
Apache Airflow là một trong những công cụ quan trọng trong hệ sinh thái Data Engineering. Tuy nhiên, để xây dựng được một Data Pipeline hoàn chỉnh, người học cần kết hợp nhiều kiến thức như Python, SQL, xử lý dữ liệu, Data Warehouse và trực quan hóa dữ liệu.
Nếu đang định hướng phát triển theo nghề Data Engineer, bạn có thể tham khảo chương trình Data Engineer – Data Warehouse and Data Visualization tại Cole để tìm hiểu lộ trình học và các nội dung đào tạo liên quan.
10. Câu hỏi thường gặp về Apache Airflow
Apache Airflow có miễn phí không?
Có. Apache Airflow là nền tảng mã nguồn mở, được phát triển dưới sự quản lý của Apache Software Foundation. Người dùng có thể cài đặt và triển khai trên hạ tầng riêng. Tuy nhiên, vẫn cần tính đến chi phí máy chủ, lưu trữ, vận hành và bảo trì hệ thống.
Apache Airflow có phải công cụ ETL không?
Airflow không phải công cụ ETL chuyên xử lý dữ liệu. Đây là nền tảng điều phối workflow, có thể kết nối và điều khiển các công cụ ETL khác như Python, SQL, Spark hoặc các dịch vụ xử lý dữ liệu.
Apache Airflow có xử lý dữ liệu realtime không?
Airflow không được thiết kế để xử lý streaming realtime. Công cụ này phù hợp với việc điều phối các workflow theo lịch hoặc theo điều kiện kích hoạt. Đối với xử lý dữ liệu liên tục, có thể kết hợp Kafka và Spark Structured Streaming.
DAG trong Apache Airflow là gì?
DAG là cấu trúc biểu diễn workflow gồm các task và mối quan hệ phụ thuộc giữa chúng. DAG giúp Airflow xác định thứ tự thực thi, theo dõi trạng thái và quản lý các lần chạy của quy trình.
Có cần biết Python để học Apache Airflow không?
Nên có kiến thức Python cơ bản trước khi học Airflow. Người dùng cần hiểu hàm, module, thư viện và cách xử lý dữ liệu bằng Python để xây dựng DAG cũng như tích hợp các công cụ khác.
Apache Airflow có thể kết hợp với Apache Spark không?
Có. Airflow có thể sử dụng SparkSubmitOperator để khởi chạy và theo dõi Spark Job. Trong mô hình này, Airflow đảm nhận việc điều phối workflow, còn Spark thực hiện các tác vụ xử lý dữ liệu phân tán.
Nên học Apache Airflow trước hay Apache Spark trước?
Nếu đã có kiến thức Python và SQL, người học có thể bắt đầu với Airflow để hiểu cách tổ chức và điều phối Data Pipeline. Sau đó, học Spark để mở rộng khả năng xử lý dữ liệu phân tán. Thứ tự này có thể thay đổi tùy theo yêu cầu công việc và nền tảng hiện tại.