Trong các nền tảng thương mại điện tử hiện đại, tính năng gợi ý sản phẩm cá nhân hóa (Personalized Recommendation) đóng vai trò sống còn trong việc giữ chân khách hàng và thúc đẩy doanh thu. Tuy nhiên, khoảng cách từ một thuật toán chạy thử nghiệm trên máy tính cá nhân đến một hệ thống phục vụ hàng chục ngàn người dùng đồng thời là một rào cản kỹ thuật rất lớn.
Hầu hết các dự án máy học ở quy mô nghiên cứu đều dừng lại ở file Jupyter Notebook: nạp một tập dữ liệu tĩnh, tiền xử lý bằng Pandas, gọi hàm huấn luyện mô hình và đánh giá chỉ số F1-score hay AUC. Khi đưa vào môi trường thực tế, hệ thống nhanh chóng bộc lộ các điểm nghẽn: làm thế nào để truy xuất đặc trưng người dùng trong vài mili-giây? Làm thế nào để tự động cập nhật mô hình khi hành vi khách hàng thay đổi mà không cần can thiệp thủ công? Và làm sao để triển khai hệ thống lên đám mây với chi phí tối ưu nhưng vẫn đảm bảo độ tin cậy và bảo mật?
Bài viết này là một case study kỹ thuật chi tiết bóc tách toàn diện dự án Mobile Item Recommendation System do học viên Trần Đình Đức xây dựng và bảo vệ thành công tại Khóa học Bootcamp MLOps - Deploy Model Lên Production. Và sẽ có Link Github ở cuối bài và icon ở đầu bài. Dự án này không chỉ giải quyết trọn vẹn bài toán kinh doanh về gợi ý sản phẩm trên thiết bị di động mà còn hiện thực hóa một kiến trúc MLOps End-to-End chuẩn công nghiệp: từ quản trị dữ liệu đặc trưng bằng Feast và Redis, tự động hóa luồng xử lý với Apache Airflow, quản lý vòng đời mô hình qua MLflow, cho đến việc đóng gói triển khai serverless trên Google Cloud Platform (GCP) và giám sát liên tục bằng Prometheus cùng Grafana.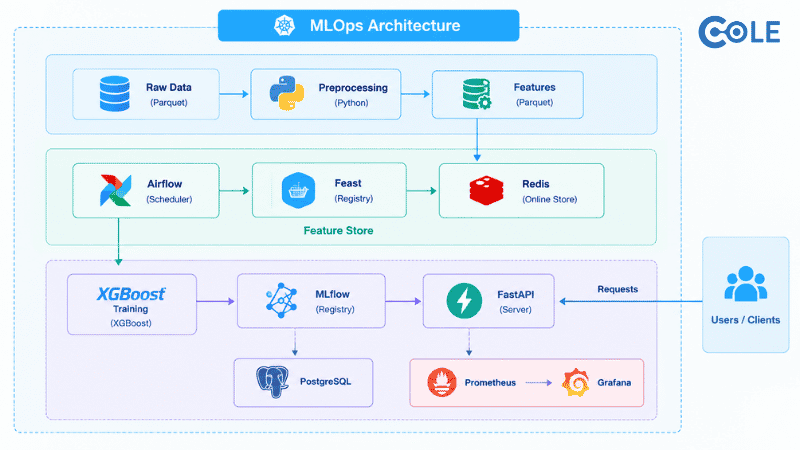
1. Tổng quan bài toán nghiệp vụ và kiến trúc hệ thống 5 tầng
Mục tiêu nghiệp vụ & Bộ dữ liệu hành vi thương mại điện tử
Hệ thống giải quyết bài toán cốt lõi của sàn thương mại điện tử: Dự đoán hành vi mua hàng của người tiêu dùng đối với các thiết bị di động dựa trên chuỗi tương tác trong quá khứ.
Mục tiêu kỹ thuật được chia thành 2 bài toán phục vụ trực tiếp:
Dự đoán xác suất chuyển đổi (
/predict): Tiếp nhận thông tin định danh của một người dùng (user_id) và một sản phẩm (item_id), sau đó trả về xác suất người dùng đó sẽ thực hiện giao dịch mua hàng (purchase_probability) trong ngày.Gợi ý danh mục tối ưu (
/recommend): Tiếp nhậnuser_idvà tham sốtop_k, hệ thống sẽ quét qua danh mục sản phẩm tiềm năng, tính toán xác suất và trả về danh sách K sản phẩm có khả năng được mua cao nhất.
Dữ liệu đầu vào là chuỗi sự kiện tương tác của người dùng trên nền tảng, bao gồm 4 nhóm hành động chính: Click xem sản phẩm, Thêm vào giỏ hàng (Add to cart), Yêu thích (Favorite) và Mua hàng (Purchase).
Do tập dữ liệu thô ban đầu có dung lượng rất lớn, gây nghẽn bộ nhớ khi huấn luyện cục bộ, tác giả đã áp dụng kỹ thuật lấy mẫu phân tầng (Stratified Sampling) giữ lại 10% dữ liệu đại diện và chuyển đổi toàn bộ sang định dạng Parquet nén cột (Columnar Storage). Kỹ thuật này giúp giảm hơn 70% dung lượng lưu trữ đĩa cứng, đồng thời tối ưu hóa tốc độ đọc I/O khi nạp dữ liệu vào pipeline.
Sơ đồ luồng dữ liệu & Hạ tầng kỹ thuật (System Architecture)
Thay vì sử dụng một kiến trúc nguyên khối (Monolith) cồng kềnh, hệ thống được phân rã thành 5 tầng độc lập theo tư duy vi dịch vụ (Microservices), kết hợp giữa hạ tầng máy chủ ảo và kiến trúc không máy chủ (Serverless):
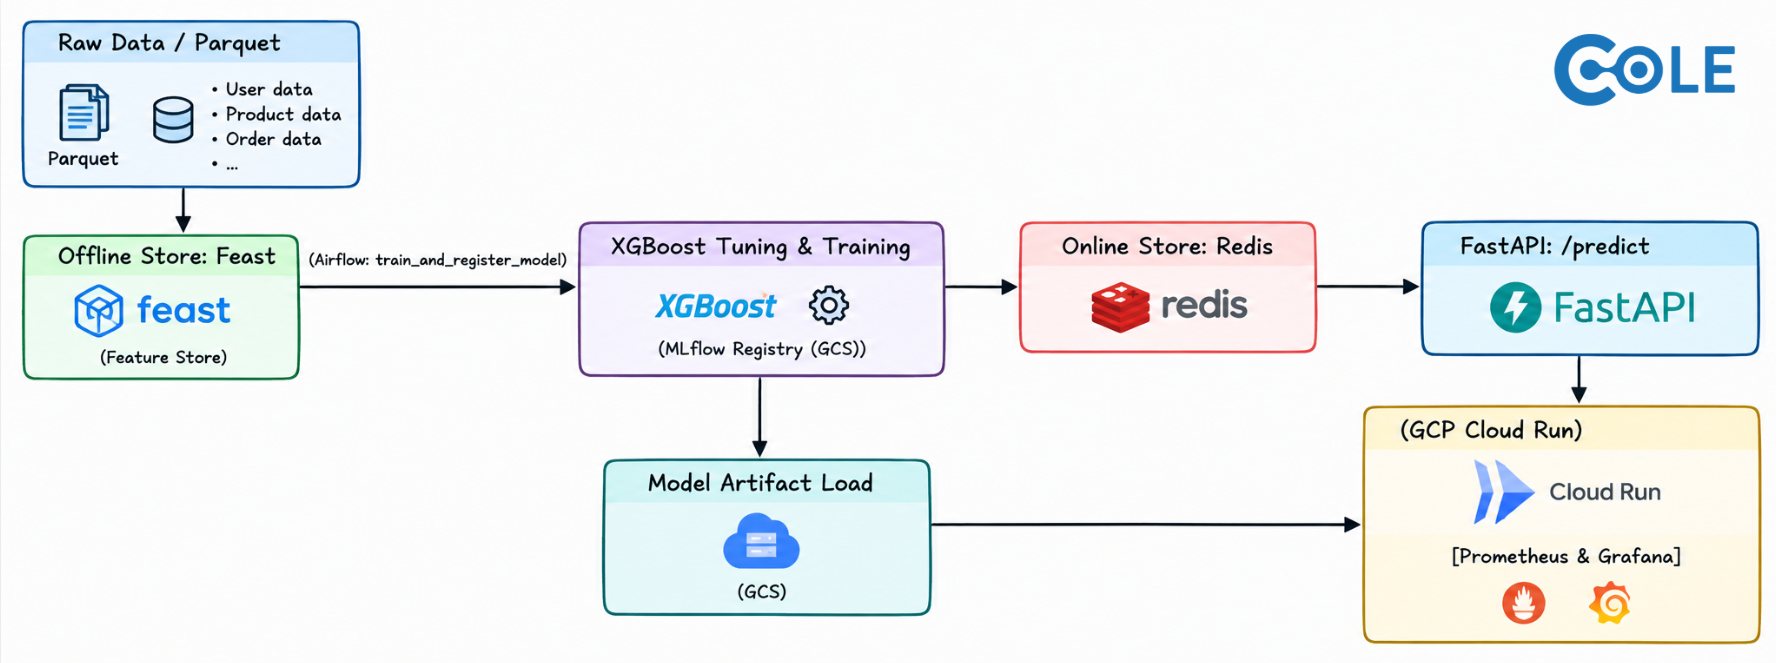
Mô hình triển khai hạ tầng lai (Hybrid Cloud Architecture):
GCP Compute Engine (Virtual Machine): Chạy các dịch vụ nội bộ có trạng thái (Stateful) và các tiến trình nền chạy liên tục qua Docker Compose, bao gồm: Apache Airflow (Scheduler, Webserver), MLflow Tracking Server, Redis In-memory Database, Prometheus và Grafana.
GCP Cloud Run: Triển khai riêng biệt ứng dụng Serving API (FastAPI). Đây là giải pháp Serverless Container giúp hệ thống tự động co giãn từ 0 lên hàng chục bản sao khi có lưu lượng truy cập lớn và hạ về 0 khi không có request, giúp tiết kiệm tối đa ngân sách vận hành hạ tầng đám mây.
2. Thiết lập Feature Store: Giải quyết Training-Serving Skew với Feast và Redis
Tại sao hệ thống Production bắt buộc phải có Feature Store?
Trong các hệ thống học máy truyền thống, khi người dùng gửi một yêu cầu gợi ý, API thường phải truy vấn trực tiếp vào cơ sở dữ liệu quan hệ (PostgreSQL, MySQL) để thực hiện các phép kết hợp (JOIN) và tính toán các chỉ số thống kê (như số lượt click trong 7 ngày qua). Phương pháp này làm tăng độ trễ mạng lên đến hàng trăm mili-giây, dễ gây treo database khi lượng truy cập tăng vọt.
Nguy hiểm hơn, nó dẫn đến hiện tượng Training-Serving Skew (lệch pha dữ liệu): logic tính toán đặc trưng bằng thư viện Pandas lúc huấn luyện không khớp hoàn toàn với logic câu lệnh SQL được viết lại trên API. Ngoài ra, việc kết hợp dữ liệu thiếu chặt chẽ rất dễ gây ra hiện tượng Data Leakage (rò rỉ dữ liệu từ tương lai vào quá khứ).
Feast (Feature Store for Machine Learning) giải quyết bài toán này bằng kiến trúc lưu trữ kép (Dual-Store):
Offline Feature Store: Sử dụng các file Parquet tĩnh lưu trên hệ thống tệp hoặc Google Cloud Storage, chịu trách nhiệm cung cấp dữ liệu lớn cho việc huấn luyện mô hình theo cơ chế Point-in-time Join (đảm bảo tính toàn vẹn lịch sử).
Online Feature Store: Tích hợp trực tiếp với Redis, lưu trữ các vector đặc trưng mới nhất của từng User và Item trên bộ nhớ RAM. Khi API hoạt động, nó chỉ mất từ 1 đến 3 mili-giây để truy xuất toàn bộ dữ liệu cần thiết phục vụ suy luận.
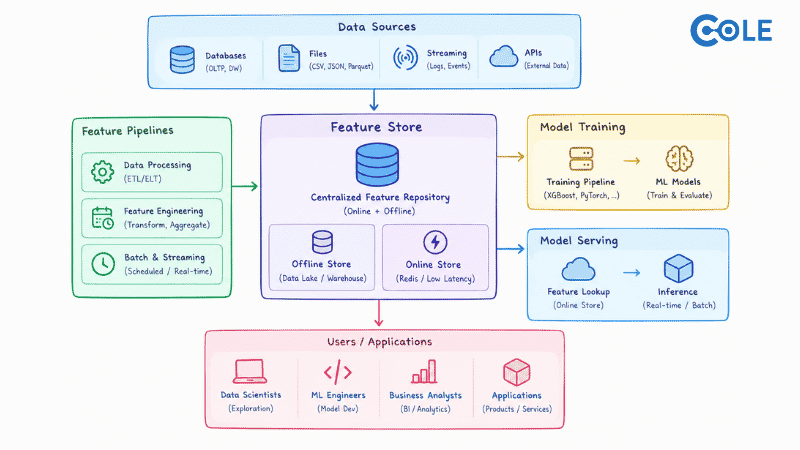
Cấu hình feature_store.yaml và định nghĩa Feature Views
Trong thư mục dự án, file cấu hình feature_store.yaml đóng vai trò liên kết các tầng lưu trữ:
YAML
project: mobile_recommendation
registry: data/registry.db
provider: local
offline_store:
    type: file
online_store:
    type: redis
    connection_string: "redis:6379"
Dựa trên cấu hình này, mã nguồn định nghĩa rõ hai thực thể chính (user_id, item_id) cùng các bảng đặc trưng (Feature Views):
User Behavior Features: Bao gồm các trường tổng hợp như số lần click sản phẩm trong 7 ngày gần nhất, tỷ lệ thêm vào giỏ hàng, tổng số đơn mua hoàn tất.
Item Conversion Features: Bao gồm tổng lượt xem của sản phẩm, tỷ lệ chuyển đổi từ lượt xem sang lượt mua và danh mục phân loại (
item_category).
Tất cả các Feature Views đều được thiết lập thuộc tính online=True và thời gian hiệu lực dữ liệu (ttl) là 30 ngày, đảm bảo hệ thống không lưu trữ các dữ liệu rác đã quá hạn trong bộ nhớ đệm.
3. Tự động hóa Pipeline với 3 DAGs chuyên biệt trên Apache Airflow
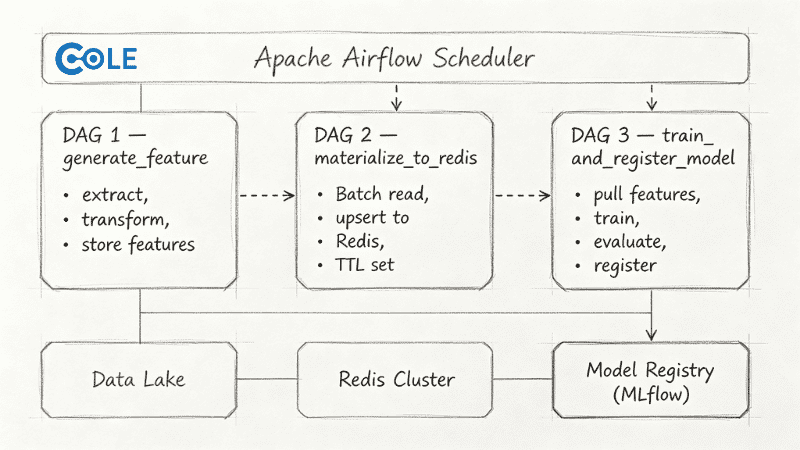
Để toàn bộ chu trình xử lý dữ liệu và huấn luyện mô hình có thể tự vận hành mà không cần con người gõ lệnh thủ công, tác giả đã xây dựng 3 đồ thị xử lý có hướng (DAGs) độc lập trên Apache Airflow:
[DAG: generate_feature]      ──> Tạo đặc trưng mới và cập nhật Feast Offline Store
[DAG: materialize_to_redis]  ──> Đồng bộ đặc trưng mới nhất từ Feast sang Redis Online Store
[DAG: train_and_register]    ──> Kéo dữ liệu, huấn luyện XGBoost, đánh giá và đăng ký vào MLflow
DAG 1: generate_feature (Tiền xử lý và tạo đặc trưng)
Đọc dữ liệu thô Parquet theo từng phân vùng thời gian.
Thực thi các hàm tính toán biến đổi dữ liệu (Feature Engineering): tính tần suất tương tác, tỷ lệ chuyển đổi cho từng thực thể.
Lưu trữ các bảng dữ liệu đã xử lý vào thư mục đích được Feast quản lý để sẵn sàng phục vụ các bước tiếp theo.
DAG 2: materialize_to_redis (Đồng bộ hóa Online Store)
Chịu trách nhiệm đồng bộ dữ liệu đặc trưng từ các file Parquet ngoại tuyến sang cơ sở dữ liệu in-memory Redis.
Sử dụng cơ chế đồng bộ gia tăng (Incremental Materialization): thay vì nạp lại toàn bộ dữ liệu từ đầu (gây quá tải Redis), Airflow chỉ quét và đẩy các bản ghi có dấu thời gian (timestamp) mới phát sinh kể từ lần chạy trước đó.
DAG 3: train_and_register_model (Tự động hóa Huấn luyện và Đánh giá)
Sử dụng Feast Python SDK để trích xuất tập dữ liệu huấn luyện lịch sử với độ chính xác thời gian tuyệt đối.
Huấn luyện các mô hình Baseline (Logistic Regression, Random Forest) và mô hình ứng viên chính: thuật toán XGBoost Classifier.
Tự động thực hiện quá trình tinh chỉnh siêu tham số (Hyperparameter Tuning) để tìm ra bộ tham số (learning rate, max depth, n estimators) tối ưu nhất.
So sánh các chỉ số ROC-AUC và Log Loss của phiên bản vừa huấn luyện với phiên bản đang chạy thực tế. Nếu các chỉ số vượt qua ngưỡng kiểm định, pipeline sẽ tự động kích hoạt tiến trình đăng ký mô hình vào MLflow Model Registry.
4. Quản trị vòng đời mô hình và Triển khai Serving (MLflow & FastAPI)
Quản lý thí nghiệm và lưu trữ Artifacts với MLflow
Trong quá trình huấn luyện, mọi thông số kỹ thuật đều được MLflow Tracking ghi nhận đầy đủ:
Parameters & Metrics: Ghi lại giá trị tham số cấu hình và toàn bộ diễn biến của hàm mất mát, chỉ số AUC, F1-score qua từng vòng lặp.
Model Registry: Quản lý vòng đời mô hình theo các giai đoạn rõ ràng. Mô hình mới nhất sau khi vượt qua bài kiểm tra của Airflow DAG sẽ được gán nhãn chuyển từ trạng thái
StagingsangProduction, cho phép hệ thống phục vụ truy xuất phiên bản chuẩn xác nhất.
Xây dựng API phục vụ suy luận bằng FastAPI
Tầng giao tiếp với người dùng được xây dựng hoàn toàn bằng FastAPI nhằm tận dụng cơ chế xử lý bất đồng bộ (async/await) hiệu năng cao. Ứng dụng cung cấp 2 Endpoint nghiệp vụ chính:
Endpoint
/predict: Tiếp nhận payload JSON chứauser_id,item_idvàitem_category. FastAPI lập tức gọi Feast Client để lấy vector đặc trưng tương ứng từ Redis, sau đó đưa qua mô hình XGBoost đã nạp vào bộ nhớ để tính toán và trả về xác suất mua hàng:JSON
{
  "user_id": 10023,
  "item_id": 5541,
  "item_category": "Smartphone",
  "probability": 0.842,
  "prediction": 1
}
Endpoint
/recommend: Tiếp nhậnuser_idvà số lượngtop_k. Hệ thống sẽ tính toán xác suất mua hàng đối với danh sách các sản phẩm mục tiêu và trả về danh sách K sản phẩm có xác suất cao nhất.Tích hợp sẵn tài liệu tương tác tự động Swagger UI tại đường dẫn
/docs, giúp đội ngũ phát triển giao diện (Frontend/Mobile) dễ dàng kiểm thử trực tiếp các trường hợp dữ liệu.
5. Đóng gói Docker, CI/CD và Triển khai thực tế trên Google Cloud Platform
Đóng gói dịch vụ với Docker và Docker Compose
Toàn bộ mã nguồn được container hóa hoàn toàn để loại bỏ lỗi không tương thích môi trường ("chạy được trên máy tôi nhưng lỗi trên server"):
Dịch vụ FastAPI Serving được viết riêng một
Dockerfiletối ưu hóa kích thước bằng cách sử dụng base image Python-slim.Cụm dịch vụ chạy nền trên máy chủ GCP Compute Engine VM được đóng gói và liên kết thông qua một file
docker-compose.ymlduy nhất, quản lý các dịch vụ: Airflow Webserver, Airflow Scheduler, Redis Server, MLflow Server, Prometheus và Grafana.
Pipeline CI/CD tự động hóa qua GitHub Actions
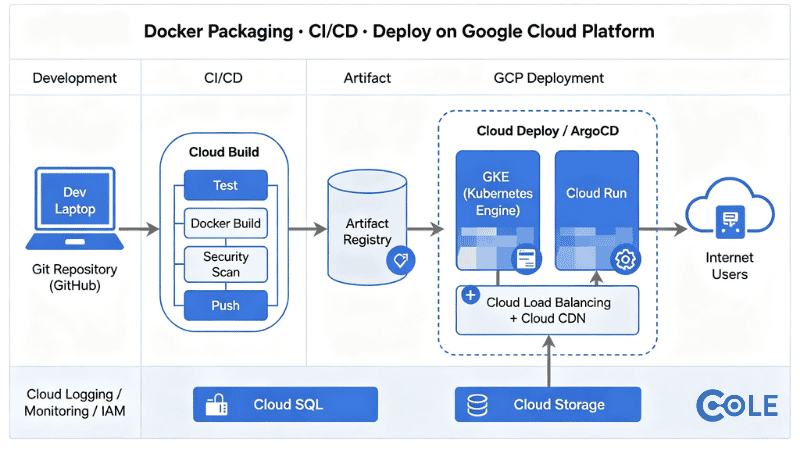
Quy trình từ lúc cập nhật code đến khi triển khai lên đám mây được tự động hóa hoàn toàn bằng GitHub Actions qua các bước:
Khi có mã nguồn mới được merge vào nhánh chính
main, GitHub Actions kích hoạt chu trình kiểm tra cú pháp và chất lượng mã nguồn (Linting).Tự động đóng gói bản dựng Docker Image mới nhất cho dịch vụ FastAPI.
Đăng nhập an toàn vào Google Cloud và đẩy (push) image lên kho lưu trữ GCP Artifact Registry.
Kích hoạt lệnh triển khai tự động cập nhật image mới lên dịch vụ GCP Cloud Run mà không làm gián đoạn hệ thống (Zero-Downtime Deployment).
6. Những bài học hạ tầng thực tế từ quá trình triển khai Cloud (Troubleshooting)
Đây là phần nội dung giá trị nhất được đúc rút từ quá trình triển khai thực tế và phần trao đổi kỹ thuật chuyên sâu giữa học viên và chuyên gia hướng dẫn trong buổi báo cáo.
Lỗi 1: Thất lạc Model Artifacts của MLflow khi chuyển từ Local lên Cloud
Hiện tượng lỗi: Khi phát triển dưới máy cá nhân bằng Docker Compose, MLflow lưu các file artifact (mô hình đã train) vào một thư mục cục bộ (Local Volume). Tuy nhiên, khi đóng gói và đưa lên máy chủ ảo trên Cloud, API Serving không thể tải được file mô hình dẫn đến lỗi sập ứng dụng khi thực hiện suy luận.
Nguyên nhân: File hệ thống nội bộ của Docker container có tính chất tạm thời (ephemeral) và không thể chia sẻ ra ngoài môi trường Cloud Run không máy chủ.
Cách khắc phục:
Cấu hình tham số khởi động của MLflow Server trỏ trực tiếp kho lưu trữ artifact về dịch vụ lưu trữ đám mây:
--default-artifact-root gs://[TEN_GCS_BUCKET].Đồng thời, thiết lập tài khoản dịch vụ (GCP Service Account) và cấp quyền IAM chuẩn xác: cấp quyền
roles/storage.objectAdmincho máy chủ VM (để Airflow và MLflow ghi file mô hình) và quyềnroles/storage.objectViewercho Cloud Run (để FastAPI nạp file mô hình vào bộ nhớ).
Lỗi 2: Xung đột cấu hình mạng trong Docker Compose và Host Binding
Hiện tượng lỗi: Các container dịch vụ trên Cloud VM khởi động thành công nhưng trình duyệt từ bên ngoài không thể truy cập giao diện web của Airflow hay MLflow, hoặc các service không thể kết nối tới cơ sở dữ liệu Redis.
Nguyên nhân và giải pháp:
Lỗi Host Binding: Rất nhiều trường hợp cấu hình máy chủ lắng nghe tại địa chỉ
127.0.0.1. Địa chỉ này chỉ chấp nhận các kết nối nội bộ trong chính container đó. Bắt buộc phải đổi địa chỉ lắng nghe thành0.0.0.0để tiếp nhận lưu lượng từ mọi network interface bên ngoài.Lỗi phân giải tên miền nội bộ: Trong file
docker-compose.yml, các service phải được gắn vào chung một Docker Bridge Network. Khi đó, các ứng dụng gọi nhau bằng chính tên định danh của service (ví dụ chuỗi kết nối làredis:6379) thay vì sử dụng địa chỉ IP tĩnh dễ bị thay đổi khi container khởi động lại.
Lỗi 3: Rủi ro bảo mật hạ tầng khi cấu hình Firewall trên Cloud
Hiện tượng: Để truy cập nhanh các trang quản trị (Airflow cổng 8080, MLflow cổng 5000, Grafana cổng 3000), thói quen của nhiều kỹ sư là tạo các luật (rules) trên GCP Firewall mở toàn bộ dải IP nguồn
0.0.0.0/0.Rủi ro và giải pháp chuẩn doanh nghiệp:
Việc mở cổng công khai
0.0.0.0/0khiến hệ thống trở thành mục tiêu quét tự động của các bot mạng độc hại, đặc biệt là cổng Redis vốn không có cơ chế mã hóa phức tạp mặc định.Các giải pháp khắc phục chuẩn công nghiệp bao gồm:
Giới hạn IP truy cập (IP Whitelisting): Chỉ cho phép các địa chỉ IP tĩnh của văn phòng hoặc máy tính cá nhân của quản trị viên được phép kết nối vào các cổng quản trị.
Truy cập qua mạng riêng ảo (Cloud VPN / SSH Tunneling): Đặt toàn bộ các máy chủ vào mạng nội bộ (Internal VPC) không có IP công khai, quản trị viên chỉ truy cập thông qua đường hầm SSH bảo mật.
Thiết lập Reverse Proxy: Đặt một máy chủ Nginx hoặc Cloud Load Balancer ở phía trước, cấu hình chứng chỉ bảo mật SSL/TLS (HTTPS) và tích hợp các lớp xác thực người dùng tập trung trước khi chuyển tiếp yêu cầu vào các dịch vụ nội bộ.
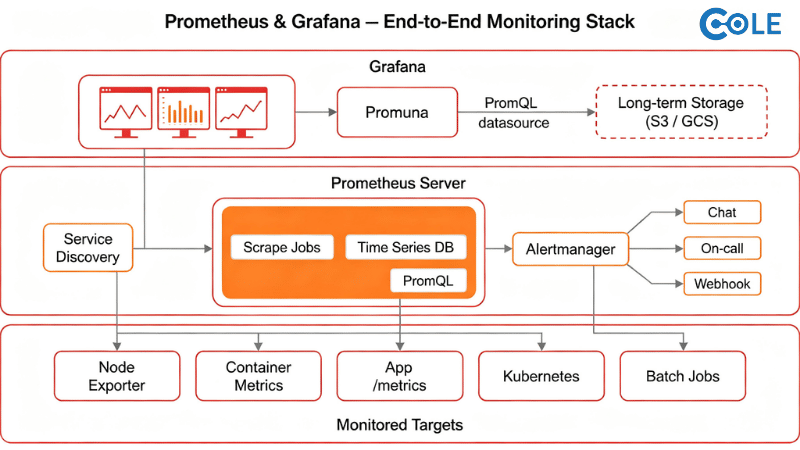
7. Giám sát toàn diện hệ thống với Prometheus và Grafana
Một hệ thống triển khai thực tế không thể vận hành an toàn nếu thiếu tầng giám sát (Observability). Để đảm bảo các cam kết chất lượng dịch vụ (SLA), dự án tích hợp hệ thống giám sát tự động 24/7:
Khai báo và Thu thập chỉ số (Metrics Collection):
Mã nguồn FastAPI được tích hợp thư viện
prometheus-fastapi-instrumentator, tự động sinh ra một endpoint chuẩn/metrics.Máy chủ Prometheus trên Cloud VM được cấu hình thông qua file
prometheus.ymlđể định kỳ cào (scrape) dữ liệu từ endpoint này sau mỗi chu kỳ 15 giây.Bảng điều khiển trực quan trên Grafana:
Grafana kết nối với nguồn dữ liệu Prometheus để hiển thị các biểu đồ theo dõi sức khỏe hệ thống theo thời gian thực:
Thông lượng (Throughput): Số lượng request tiếp nhận trên mỗi giây (Requests Per Second - RPS).
Độ trễ phân vị (Latency Distribution): Giám sát sát sao các ngưỡng độ trễ p50, p95 và p99 để phát hiện ngay các trường hợp suy giảm hiệu năng khi hệ thống chịu tải cao.
Tỷ lệ mã lỗi HTTP: Theo dõi sát tỷ lệ mã phản hồi HTTP 200 (thành công), 4xx (lỗi client) và cảnh báo tức thời nếu mã lỗi 5xx (lỗi server) có xu hướng gia tăng bất thường.
8. Các câu hỏi thường gặp (FAQ)
1. Tại sao nên chọn Feast kết hợp Redis thay vì lưu trữ đặc trưng trực tiếp trong PostgreSQL/MySQL?
Cơ sở dữ liệu quan hệ được thiết kế tối ưu cho các giao dịch ACID và lưu trữ dữ liệu có cấu trúc, không được thiết kế cho việc đọc ngẫu nhiên hàng chục ngàn vector đặc trưng trên giây với độ trễ thấp. Khi ứng dụng phải join nhiều bảng lớn để tính toán đặc trưng tại thời điểm người dùng gọi API, độ trễ có thể lên tới hàng trăm mili-giây hoặc gây nghẽn kết nối database. Redis lưu trữ dữ liệu hoàn toàn trên RAM dưới dạng cấu trúc HASH tối ưu nhị phân, cho phép truy xuất đặc trưng chỉ mất từ 1 đến 3 mili-giây, đáp ứng tiêu chuẩn khắt khe của các hệ thống gợi ý trực tuyến.
2. Sự khác biệt giữa việc lưu trữ Model Artifacts trên Local và trên Google Cloud Storage (GCS) là gì?
Khi chạy local trên Docker, bạn có thể map volume của máy tính vào container để lưu file mô hình. Tuy nhiên, khi chuyển lên môi trường Cloud phân tán, đặc biệt là khi dùng các dịch vụ Serverless như Cloud Run (vốn tự động tạo mới và hủy các container theo nhu cầu), dữ liệu lưu cục bộ bên trong container sẽ biến mất khi container tắt đi. Việc sử dụng GCS Bucket làm nơi lưu trữ tập trung giúp mọi thành phần trong hệ thống (Airflow, MLflow, FastAPI) có thể đọc và ghi file mô hình một cách độc lập, ổn định và bảo mật thông qua phân quyền tài khoản dịch vụ (IAM Service Account).
3. Tại sao trong dự án này lại tách riêng hạ tầng thành GCP Compute Engine và GCP Cloud Run?
Đây là chiến lược thiết kế tối ưu hóa chi phí (Cost-Optimization). Các dịch vụ như Airflow, MLflow, Redis, Prometheus và Grafana là các tiến trình nội bộ cần chạy nền liên tục (Stateful/Daemon), vì vậy đặt chúng trên một máy chủ ảo Compute Engine VM cố định sẽ tiết kiệm chi phí hơn rất nhiều so với việc thuê các dịch vụ quản lý riêng lẻ. Ngược lại, API Serving (FastAPI) phục vụ người dùng bên ngoài có lưu lượng truy cập biến động liên tục (cao điểm vào buổi tối, thấp điểm vào ban đêm). Đưa FastAPI lên Cloud Run giúp hệ thống tự động co giãn số lượng máy chủ theo lượng request thực tế và tự giảm về 0 khi không có người dùng, triệt tiêu hoàn toàn chi phí máy chủ nhàn rỗi.
4. Nếu không có kinh nghiệm về DevOps, làm thế nào để xử lý các lỗi cấu hình mạng trong Docker Compose?
Hai nguyên tắc cốt lõi bạn cần ghi nhớ:
Thứ nhất, luôn cấu hình ứng dụng trong container lắng nghe ở host 0.0.0.0 thay vì 127.0.0.1 để container có thể nhận kết nối từ bên ngoài.
Thứ hai, trong file docker-compose.yml, hãy khai báo một mạng chung (bridge network) cho các dịch vụ. Khi các container nằm trong cùng một mạng, chúng sẽ tự động phân giải tên miền của nhau bằng chính tên service được định nghĩa trong file compose (ví dụ: host của Redis sẽ chính là redis, host của MLflow sẽ chính là mlflow), tuyệt đối không dùng địa chỉ IP tĩnh để kết nối giữa các container.
5. Dự án này có thể mở rộng (scale) lên quy mô dữ liệu hàng chục triệu bản ghi như thế nào?
Để nâng cấp hệ thống lên quy mô dữ liệu doanh nghiệp lớn:
Tầng tiền xử lý dữ liệu của Airflow có thể chuyển từ việc chạy mã Python thuần sang sử dụng Apache Spark hoặc dịch vụ Google Cloud Dataproc để xử lý dữ liệu phân tán.
Cơ sở dữ liệu Redis đơn lẻ (Single-node) có thể nâng cấp lên cụm Redis Cluster kết hợp Sentinel để đảm bảo tính sẵn sàng cao (High Availability) và phân mảnh dữ liệu (Sharding).
Đối với các đặc trưng biến động tức thì theo từng giây (Real-time Streaming Features), có thể tích hợp thêm luồng xử lý Apache Kafka kết hợp tính năng Push Source của Feast thay vì chỉ dùng cơ chế Batch Materialization theo chu kỳ.
9. Checklist nghiệm thu một dự án MLOps chuẩn Production
Để tự rà soát và đánh giá một dự án học máy có đạt chuẩn vận hành doanh nghiệp hay không, bạn có thể đối chiếu với bảng kiểm tra 6 tiêu chí dưới đây:
| Tiêu chí đánh giá | Trạng thái đạt chuẩn (Production-Ready) | Công nghệ triển khai trong Case Study |
|---|---|---|
| 1. Quản trị đặc trưng | Tách biệt Offline Store (Batch) và Online Store (Real-time Cache) | Feast + Redis In-memory |
| 2. Tự động hóa Pipeline | Lịch trình huấn luyện và đồng bộ dữ liệu tự động, có cơ chế chạy lại khi lỗi | 3 DAGs độc lập trên Apache Airflow |
| 3. Quản trị vòng đời mô hình | Theo dõi thí nghiệm, lưu trữ tham số, chỉ số và versioning mô hình tập trung | MLflow + Google Cloud Storage Bucket |
| 4. Hiệu năng phục vụ API | API bất đồng bộ hiệu năng cao, tự động co giãn theo tải thực tế | FastAPI triển khai trên GCP Cloud Run |
| 5. Triển khai tự động (CI/CD) | Tự động hóa kiểm thử mã nguồn, build Docker image và deploy không downtime | GitHub Actions + GCP Artifact Registry |
| 6. Giám sát vận hành | Theo dõi thông lượng, độ trễ phân vị p95/p99 và tỷ lệ mã lỗi theo thời gian thực | Prometheus cào số liệu + Dashboard Grafana |
Một hệ thống học máy thực chiến không được đánh giá bằng việc xây dựng thuật toán phức tạp đến mức nào, mà được định nghĩa bằng việc toàn bộ hệ thống đó có thể vận hành ổn định, tự thích ứng, an toàn và mang lại giá trị kinh doanh thực tế trên môi trường đám mây hay không. Việc làm chủ kiến trúc 5 tầng từ Feature Store, Orchestration, Tracking, Serving đến Monitoring chính là nền tảng vững chắc nhất để xây dựng các giải pháp AI chuẩn công nghiệp.
Tham khảo dự án tại Github: https://github.com/DucDTran/mobile-item-recommendation-mlops